Aula 4 de 13
Classificação com regressão logística
Objetivo: prever sim ou não (aprovado ou reprovado, spam ou não spam) com uma probabilidade, treinando do zero com o gradiente descendente da 01.03.
Por que isso importa: a regressão logística é o classificador mais simples que existe, e é também um neurônio: uma conta X @ w + b seguida de uma função de ativação (a sigmoide). Quando você chegar nas redes neurais, vai reconhecer cada peça desta aula. Ela ainda é muito usada na prática, porque é rápida e fácil de interpretar.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
1. O problema: sim ou não
Queremos prever se um aluno vai ser aprovado (1) ou reprovado (0) a partir das horas de estudo. Diferente do preço das casas, a resposta não é um número qualquer: é uma categoria, com só dois valores possíveis.
def sigmoide(z):
    return 1 / (1 + np.exp(-z))

rng = np.random.default_rng(seed=7)
n = 60
horas = rng.uniform(0, 10, size=n)
# a regra "de verdade" (que o modelo não conhece): quanto mais horas, maior a chance de passar
aprovado = (rng.random(n) < sigmoide(1.2 * horas - 6)).astype(int)

print(horas[:5].round(1))
print(aprovado[:5])
print(f"{aprovado.sum()} aprovados de {n}")
[6.3 9. 7.8 2.3 3. ]
[1 1 1 0 0]
30 aprovados de 60Primeira ideia: usar a regressão linear da 01.02 nos 0s e 1s e dizer “aprovado” quando a reta passar de 0,5. Vamos ver o que acontece, e também o que acontece quando entram 3 alunos “caxias”, que estudaram 30, 35 e 40 horas e (claro) passaram.
def ajustar_reta(x, y):
    A = np.column_stack([x, np.ones(len(x))])        # a coluna de 1s da 01.02
    (w, b), *_ = np.linalg.lstsq(A, y, rcond=None)
    return w, b

w_reta, b_reta = ajustar_reta(horas, aprovado)

caxias = np.array([30, 35, 40])
horas_c = np.append(horas, caxias)
aprovado_c = np.append(aprovado, [1, 1, 1])
w_reta_c, b_reta_c = ajustar_reta(horas_c, aprovado_c)

corte = (0.5 - b_reta) / w_reta          # onde a reta vale 0,5
corte_c = (0.5 - b_reta_c) / w_reta_c

fig, axs = plt.subplots(1, 2, figsize=(12, 4))
x = np.linspace(0, 10, 2)
axs[0].scatter(horas, aprovado, color=AZUL, alpha=0.6, label="alunos")
axs[0].plot(x, w_reta * x + b_reta, color=LARANJA, label="reta")
axs[0].axvline(corte, color="gray", linestyle="--", label=f"corte em 0,5: {corte:.1f} h")
axs[0].set_title(f"A reta vai de {b_reta:.2f} a {w_reta * 10 + b_reta:.2f}")

x = np.linspace(0, 42, 2)
axs[1].scatter(horas, aprovado, color=AZUL, alpha=0.6, label="alunos")
axs[1].scatter(caxias, [1, 1, 1], color=VERDE, marker="^", s=80, label="caxias")
axs[1].plot(x, w_reta * x + b_reta, color="gray", linestyle=":", label="reta antes")
axs[1].plot(x, w_reta_c * x + b_reta_c, color=LARANJA, label="reta depois")
axs[1].axvline(corte_c, color="gray", linestyle="--", label=f"novo corte: {corte_c:.1f} h")
axs[1].set_ylim(-0.3, 1.5)
axs[1].set_title("3 caxias entortam a reta")

for ax in axs:
    ax.set_xlabel("horas de estudo")
    ax.set_ylabel("aprovado (1) / reprovado (0)")
    ax.legend(loc="center right", fontsize=8)
    ax.grid(alpha=0.3)
fig.tight_layout()
plt.show()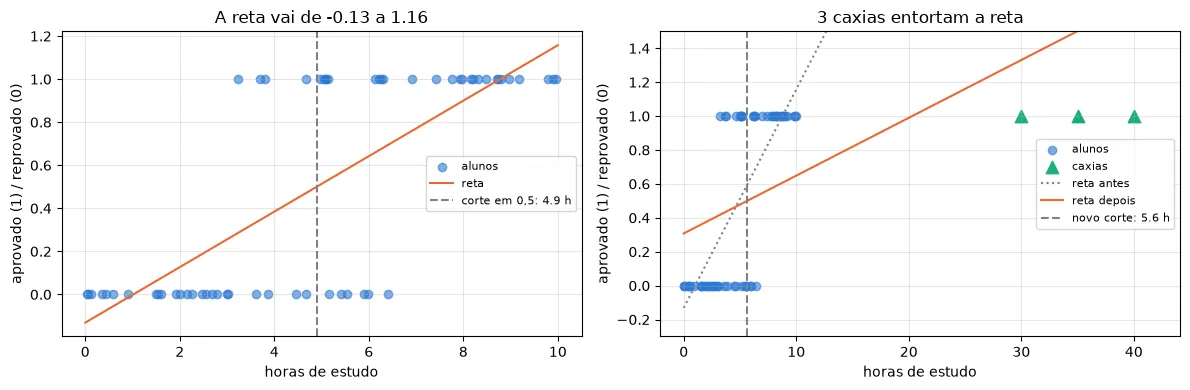
Dois problemas:
- A reta sai do intervalo de 0 a 1. Ela dá −0,13 pra quem não estudou nada e 1,16 pra quem estudou 10 horas. Se a saída é uma “chance de passar”, nada disso faz sentido.
- Pontos que já estão certos com folga atrapalham. Os caxias só confirmam que estudar ajuda, mas puxam a reta, e o corte anda de 4,9 h pra 5,6 h. Com isso, alunos comuns passam a ser classificados errado.
Precisamos de uma curva que fique sempre entre 0 e 1 e que “sature”: depois de certo ponto, estudar mais não muda quase nada.
2. A sigmoide: espremendo a reta entre 0 e 1
Você já desenhou essa função na aula 00.03:
Ela recebe qualquer número e devolve algo entre 0 e 1. A ideia da regressão logística é colocar a reta dentro da sigmoide:
A reta continua lá (ela pode dar qualquer valor), e a sigmoide transforma esse valor numa probabilidade. Em TypeScript:
const sigmoide = (z: number) => 1 / (1 + Math.exp(-z));
const chanceDeAprovar = (horas: number) => sigmoide(w * horas + b);
Com um chute de w = 1.2 e b = -6:
w_chute, b_chute = 1.2, -6.0
x = np.linspace(0, 10, 200)

fig, ax = plt.subplots(figsize=(7, 4))
ax.scatter(horas, aprovado, color=AZUL, alpha=0.6, label="alunos")
ax.plot(x, sigmoide(w_chute * x + b_chute), color=LARANJA, label="p = σ(1.2 × horas − 6)")
ax.axhline(0.5, color="gray", linestyle="--", linewidth=0.8)
ax.axvline(5, color="gray", linestyle=":", label="fronteira: 5 h")
ax.set_title("A sigmoide transforma a reta numa probabilidade")
ax.set_xlabel("horas de estudo")
ax.set_ylabel("probabilidade de aprovar")
ax.legend(loc="upper left")
ax.grid(alpha=0.3)
plt.show()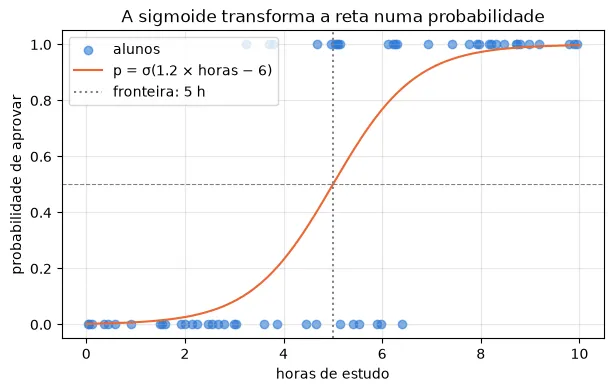
A fronteira de decisão: o modelo diz “aprovado” quando . Como , isso acontece exatamente quando a reta de dentro vale zero:
| horas | classe | ||
|---|---|---|---|
| 2 | −3,6 | 0,03 | reprovado |
| 5 | 0 | 0,50 | na fronteira |
| 8 | 3,6 | 0,97 | aprovado |
Repare no sinal: negativo dá ; positivo dá .
3. A função de custo certa: log-loss
O problema: como medir o erro de uma probabilidade? Poderíamos usar o MSE da 01.02, mas veja o que acontece quando o modelo erra com convicção:
| probabilidade dada à resposta certa | MSE: | log-loss: |
|---|---|---|
| 0,99 (acertou com certeza) | 0,0001 | 0,01 |
| 0,5 (em dúvida) | 0,25 | 0,69 |
| 0,01 (errou com certeza) | 0,98 | 4,61 |
O MSE nunca passa de 1, então um erro cheio de certeza custa quase o mesmo que um “não sei”. O log-loss (também chamado de entropia cruzada) cresce sem limite quando se aproxima de 0: ter certeza e errar é muito caro.
p = np.linspace(0.001, 1, 500)

fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(p, -np.log(p), color=AZUL, label="log-loss: −log(p)")
ax.plot(p, (1 - p) ** 2, color=LARANJA, linestyle="--", label="MSE: (1 − p)²")
ax.set_ylim(0, 5)
ax.set_title("Quanto custa cada resposta")
ax.set_xlabel("probabilidade dada à resposta certa")
ax.set_ylabel("custo")
ax.legend()
ax.grid(alpha=0.3)
plt.show()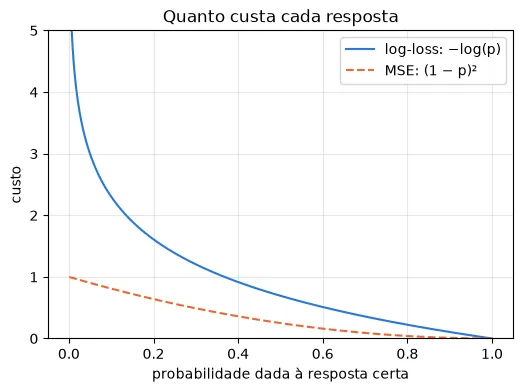
Pra um exemplo com rótulo (0 ou 1) e previsão , a fórmula é:
Parece complicada, mas o funciona como um if: quando , sobra só ; quando , sobra só . Em TypeScript:
const perda = y === 1 ? -Math.log(p) : -Math.log(1 - p);O custo do modelo é a média dessas perdas. Tem mais um motivo pra não usar o MSE aqui: com a sigmoide no meio, o terreno do MSE fica cheio de platôs, enquanto o do log-loss é uma “tigela”, e o gradiente descendente sempre chega no fundo.
4. Treino do zero com gradiente descendente
Pra descer a ladeira precisamos das derivadas. A regra da cadeia (aula 00.05) tem três elos, pra um exemplo:
| elo | derivada |
|---|---|
| log-loss em relação a | |
| sigmoide em relação a | |
| reta em relação a |
Multiplicando os três, quase tudo se cancela:
É por isso que a sigmoide e o log-loss andam juntos: o resultado é simplesmente erro × entrada. Compare com a regressão linear da 01.03:
| modelo | gradiente dos pesos (todos os exemplos) |
|---|---|
| regressão linear (MSE) | |
| regressão logística (log-loss) |
A mesma forma, só que agora o “previsto” é uma probabilidade. O código do treino é quase igual ao da 01.03:
def treinar_logistica(X, y, taxa, epocas):
    w, b = np.zeros(X.shape[1]), 0.0
    historico = []
    for _ in range(epocas):
        p = sigmoide(X @ w + b)
        p_seguro = np.clip(p, 1e-12, 1 - 1e-12)          # evita log(0) = -infinito
        historico.append(-np.mean(y * np.log(p_seguro) + (1 - y) * np.log(1 - p_seguro)))
        erro = p - y
        w = w - taxa * (X.T @ erro) / len(y)
        b = b - taxa * np.mean(erro)
    return w, b, historico


X1 = horas.reshape(-1, 1)          # (60, 1): uma coluna, pra usar a mesma função com várias features depois
w1, b1, hist1 = treinar_logistica(X1, aprovado, taxa=0.3, epocas=5000)
print(f"w = {w1[0]:.3f}, b = {b1:.3f}")
print(f"fronteira: {-b1 / w1[0]:.2f} horas")
print(f"log-loss: {hist1[0]:.3f} no começo -> {hist1[-1]:.3f} no fim")
w = 0.990, b = -4.826
fronteira: 4.88 horas
log-loss: 0.693 no começo -> 0.335 no fimfig, axs = plt.subplots(1, 2, figsize=(12, 4))
axs[0].plot(hist1, color=AZUL)
axs[0].set_title("Custo a cada época")
axs[0].set_xlabel("época")
axs[0].set_ylabel("log-loss")
x = np.linspace(0, 10, 200)
axs[1].scatter(horas, aprovado, color=AZUL, alpha=0.6, label="alunos")
axs[1].plot(x, sigmoide(w1[0] * x + b1), color=LARANJA, label="modelo treinado")
axs[1].axvline(-b1 / w1[0], color="gray", linestyle=":", label=f"fronteira: {-b1 / w1[0]:.2f} h")
axs[1].set_title("A sigmoide treinada")
axs[1].set_xlabel("horas de estudo")
axs[1].set_ylabel("probabilidade de aprovar")
axs[1].legend(loc="center right")
for ax in axs:
ax.grid(alpha=0.3)
fig.tight_layout()
plt.show()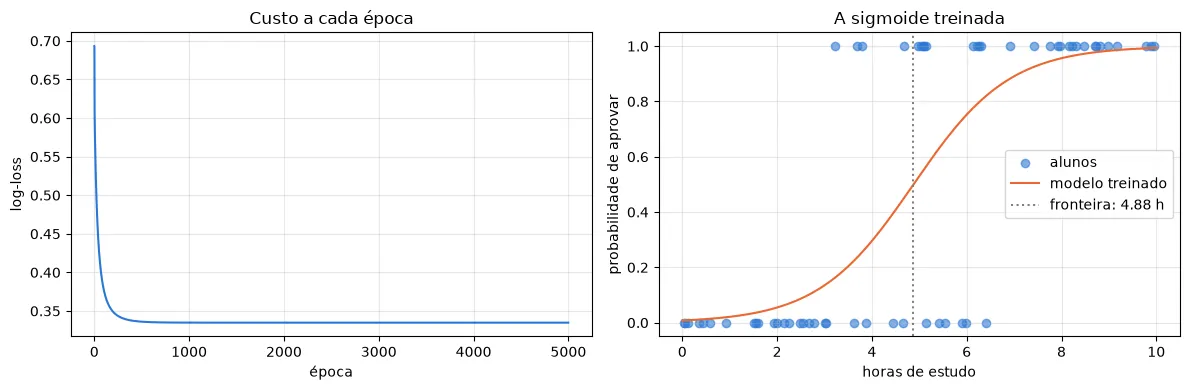
E os caxias? Vamos treinar de novo, agora com eles:
w_c, b_c, _ = treinar_logistica(horas_c.reshape(-1, 1), aprovado_c, taxa=0.05, epocas=20000)

print(f"reta:      corte de {corte:.2f} h -> {corte_c:.2f} h com os caxias")
print(f"logística: fronteira de {-b1 / w1[0]:.2f} h -> {-b_c / w_c[0]:.2f} h com os caxias")
reta: corte de 4.90 h -> 5.63 h com os caxias
logística: fronteira de 4.88 h -> 4.88 h com os caxiasA fronteira da logística não se mexe. O motivo está no gradiente, que é erro × entrada: pra um caxia, o modelo já dá , então o erro é praticamente zero. Quem já está certo com folga não empurra nada.
(A taxa aqui é menor porque 40 horas é uma entrada grande. É o problema de escala da 01.03 de novo.)
5. Duas features: a fronteira vira uma reta
Agora a aprovação depende das horas de estudo e das horas de sono. O modelo é o mesmo, com um peso por feature:
A fronteira continua sendo “a reta de dentro vale zero”: . Com duas features, isso é uma reta no plano, que separa a região “aprovado” da região “reprovado”.
Como aprendemos na 01.03, padronizamos as features antes de treinar.
rng = np.random.default_rng(seed=11)
m = 120
estudo = rng.uniform(0, 10, size=m)
sono = rng.uniform(3, 9, size=m)
y2 = (rng.random(m) < sigmoide(1.1 * estudo + 0.9 * sono - 11)).astype(int)

X2 = np.column_stack([estudo, sono])                  # (120, 2)
media, desvio = X2.mean(axis=0), X2.std(axis=0)
X2z = (X2 - media) / desvio                            # z-score (aulas 00.06 e 01.03)

w2, b2, hist2 = treinar_logistica(X2z, y2, taxa=0.5, epocas=5000)
acertos = np.mean((sigmoide(X2z @ w2 + b2) >= 0.5) == y2)
print(f"pesos (padronizados): {w2.round(3)}, b = {b2:.3f}")
print(f"acurácia: {acertos:.2f}")

# os mesmos pesos na escala original (horas), como no exercício 2 da 01.03
w_orig = w2 / desvio
b_orig = b2 - np.sum(w2 * media / desvio)
print(f"pesos (em horas): {w_orig.round(3)}, b = {b_orig:.3f}")
pesos (padronizados): [6.092 3.548], b = -1.582
acurácia: 0.91
pesos (em horas): [2.021 2.126], b = -23.252# mapa de probabilidade: calcula p em cada ponto de uma grade (meshgrid, aula 00.03)
g_estudo, g_sono = np.meshgrid(np.linspace(0, 10, 200), np.linspace(3, 9, 200))
grade = np.column_stack([g_estudo.ravel(), g_sono.ravel()]) # (40000, 2): um ponto por linha
p_grade = sigmoide(((grade - media) / desvio) @ w2 + b2).reshape(g_estudo.shape)
fig, ax = plt.subplots(figsize=(7, 5))
mapa = ax.contourf(g_estudo, g_sono, p_grade, levels=10, cmap="Greys", alpha=0.5)
fig.colorbar(mapa, ax=ax, label="probabilidade de aprovar")
ax.contour(g_estudo, g_sono, p_grade, levels=[0.5], colors="black", linestyles="--")
ax.scatter(estudo[y2 == 1], sono[y2 == 1], color=AZUL, marker="o", edgecolor="white", label="aprovado")
ax.scatter(estudo[y2 == 0], sono[y2 == 0], color=LARANJA, marker="s", edgecolor="white", label="reprovado")
ax.plot([], [], color="black", linestyle="--", label="fronteira (p = 0,5)") # só pra aparecer na legenda
ax.set_title("A fronteira de decisão é uma reta")
ax.set_xlabel("horas de estudo")
ax.set_ylabel("horas de sono")
ax.legend(loc="lower left")
plt.show()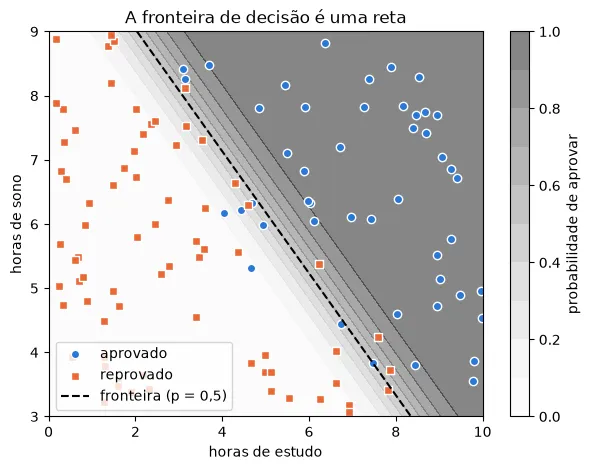
O .ravel() “achata” a grade 200×200 numa lista de 40.000 pontos, e o .reshape volta pro formato de grade depois da conta. Tudo vetorizado, sem laço.
Repare que a fronteira é reta. A regressão logística só consegue separar grupos com uma linha reta (ou um plano, com mais features). Quando os grupos se misturam de um jeito curvo, é preciso um modelo mais flexível, e é aí que entram o k-NN (próxima aula) e as redes neurais.
6. Com o scikit-learn
O LogisticRegression faz tudo isso por você. Mas tem um detalhe: por padrão, ele aplica um freio nos pesos, chamado regularização, que os puxa um pouco na direção do zero pra evitar exageros. O parâmetro C controla o freio: quanto menor, mais forte. Com C=np.inf, não há freio, e os pesos batem com os nossos. A regularização é tema da aula 01.07.
from sklearn.linear_model import LogisticRegression

modelo_padrao = LogisticRegression().fit(X2z, y2)
modelo_sem_freio = LogisticRegression(C=np.inf).fit(X2z, y2)

print("nossos pesos:      ", w2.round(3), round(b2, 3))
print("sklearn sem freio: ", modelo_sem_freio.coef_[0].round(3), modelo_sem_freio.intercept_[0].round(3))
print("sklearn padrão:    ", modelo_padrao.coef_[0].round(3), modelo_padrao.intercept_[0].round(3), " <- pesos menores (freio)")
nossos pesos: [6.092 3.548] -1.582
sklearn sem freio: [6.09 3.548] -1.582
sklearn padrão: [3.011 1.62 ] -0.949 <- pesos menores (freio)O modelo tem dois jeitos de responder:
predict_proba(X)devolve as probabilidades, com uma coluna por classe, na ordem demodelo.classes_;predict(X)devolve a classe, usando o limiar de 0,5.
alunos = np.array([[4, 6], [5, 6], [6, 7]])          # (estudo, sono) de 3 alunos novos
alunos_z = (alunos - media) / desvio                    # a mesma padronização do treino!

print(modelo_sem_freio.classes_)
print(modelo_sem_freio.predict_proba(alunos_z).round(3))   # [P(reprovar), P(aprovar)] por aluno
print(modelo_sem_freio.predict(alunos_z))
[0 1]
[[0.918 0.082]
[0.596 0.404]
[0.023 0.977]]
[0 0 1]E com mais de duas classes? A ideia se estende: o modelo calcula uma pontuação por classe, e uma função chamada softmax (a “irmã” da sigmoide) transforma as pontuações em probabilidades que somam 1. O LogisticRegression faz isso sozinho. Com as 3 espécies da Iris (aula 01.01):
from sklearn.datasets import load_iris

iris = load_iris()
modelo_iris = LogisticRegression(max_iter=1000).fit(iris.data, iris.target)
flor = iris.data[[0, 75, 140]]                        # uma flor de cada espécie
print(modelo_iris.predict_proba(flor).round(3))       # 3 probabilidades por flor, somando 1
print(iris.target_names[modelo_iris.predict(flor)])
[[0.982 0.018 0. ]
[0.005 0.92 0.075]
[0. 0.02 0.98 ]]
['setosa' 'versicolor' 'virginica']Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado, tolerancia=1e-6):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido, dtype=float), np.asarray(esperado, dtype=float)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado, rtol=tolerancia, atol=tolerancia):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Log-loss à mão
Escreva log_loss(y, p): a média de sobre todos os exemplos, sem laço. O scikit-learn tem a mesma função pronta, e o teste compara as duas.
from sklearn.metrics import log_loss as log_loss_sklearn   # com outro nome, pra não brigar com a sua


def log_loss(y, p):
    ...  # seu código aqui


y_teste = np.array([1, 0, 1])
p_teste = np.array([0.9, 0.2, 0.6])
confere(log_loss(y_teste, p_teste), log_loss_sklearn(y_teste, p_teste))
confere(log_loss(np.array([1]), np.array([0.5])), np.log(2))    # "não sei" custa log(2) ≈ 0,69
Dica
É a fórmula da seção 3 escrita com arrays: np.log age em cada elemento, e np.mean tira a média. Não esqueça o sinal de menos.
Gabarito
def log_loss(y, p):
    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p))
Exercício 2 · Do “quanto” pro “qual”
Escreva prever_classe(p, limiar=0.5), que transforma probabilidades em classes: 1 se limiar, 0 caso contrário.
Por que mudar o limiar? Lembra do exame médico da aula 00.06? Num teste de doença grave, é melhor um alarme falso do que deixar um doente passar, então faz sentido dizer “positivo” já com , por exemplo. A escolha do limiar é uma decisão de negócio, e a aula 01.08 mostra como medir o efeito dela (precisão e recall).
def prever_classe(p, limiar=0.5):
    ...  # seu código aqui


probs = np.array([0.2, 0.5, 0.8])
confere(prever_classe(probs), [0, 1, 1])
confere(prever_classe(probs, limiar=0.9), [0, 0, 0])
confere(prever_classe(probs, limiar=0.1), [1, 1, 1])
Dica
Uma comparação gera uma máscara de True/False (aula 00.02), e .astype(int) transforma em 1/0.
Gabarito
def prever_classe(p, limiar=0.5):
    return (p >= limiar).astype(int)
Exercício 3 · Quantas horas pra ter 90% de chance?
Com o modelo , escreva horas_para_chance(p, w, b), que faz o caminho inverso: dada a probabilidade desejada, quantas horas de estudo são necessárias?
Faça em dois passos:
- Desfaça a sigmoide. Se , então . A fração é a chance a favor, como nas apostas: com , a chance é de 9 pra 1. O log dela se chama logit.
- Desfaça a reta. Se , então .
def horas_para_chance(p, w, b):
    ...  # seu código aqui


confere(horas_para_chance(0.5, 1.2, -6), 5.0)                              # a fronteira da seção 2
confere(horas_para_chance(np.array([0.1, 0.5, 0.9]), 1.2, -6), [3.16898, 5.0, 6.83102], tolerancia=1e-4)

if horas_para_chance(0.9, 1.2, -6) is not None:
    print(f"Com o modelo treinado na seção 4: {horas_para_chance(0.9, w1[0], b1):.1f} horas pra ter 90% de chance")
Dica
np.log(p / (1 - p)) funciona com um número ou com um array inteiro.
Gabarito
def horas_para_chance(p, w, b):
    z = np.log(p / (1 - p))      # desfaz a sigmoide
    return (z - b) / w           # desfaz a reta
Conferindo o passo 1: se , então , e . ✔
Exercício 4 · Desenhando a fronteira
Com duas features, a fronteira é a reta . Escreva fronteira_x2(x1, w, b), que isola : pra cada valor de x1 (horas de estudo), devolve o x2 (horas de sono) que fica exatamente na fronteira.
Quando acertar, a célula de baixo desenha a sua reta em cima dos dados da seção 5, usando os pesos na escala original (w_orig, b_orig). Ela precisa coincidir com a fronteira tracejada de lá.
def fronteira_x2(x1, w, b):
    ...  # seu código aqui


confere(fronteira_x2(np.array([0, 5, 10]), np.array([1.0, 0.8]), -11), [13.75, 7.5, 1.25])
# Depois de acertar: a sua fronteira nos dados da seção 5
x1 = np.linspace(0, 10, 50)
linha = fronteira_x2(x1, w_orig, b_orig)
if linha is not None:
fig, ax = plt.subplots(figsize=(7, 5))
ax.scatter(estudo[y2 == 1], sono[y2 == 1], color=AZUL, marker="o", label="aprovado")
ax.scatter(estudo[y2 == 0], sono[y2 == 0], color=LARANJA, marker="s", label="reprovado")
ax.plot(x1, linha, color="black", label="a sua fronteira")
ax.set_ylim(3, 9)
ax.set_title("Fronteira calculada à mão")
ax.set_xlabel("horas de estudo")
ax.set_ylabel("horas de sono")
ax.legend(loc="lower left")
ax.grid(alpha=0.3)
plt.show()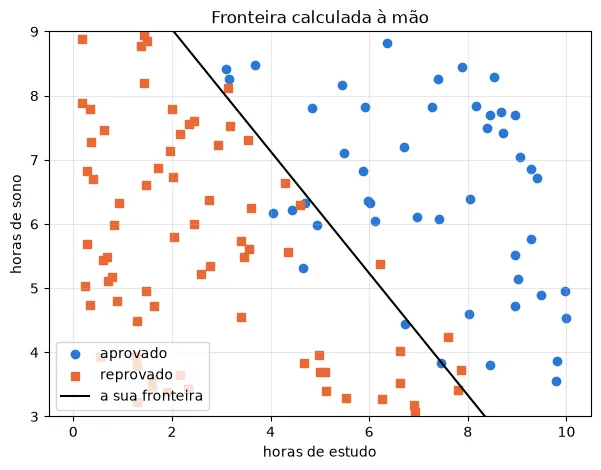
Dica
Resolva pra , como na escola: passe os outros termos pro outro lado e divida por . Com arrays, w[0] e w[1] são os dois pesos.
Gabarito
def fronteira_x2(x1, w, b):
    return -(w[0] * x1 + b) / w[1]
Exercício 5 (desafio) · Iris: versicolor × virginica
Na aula 01.01, você separou essas duas espécies com uma regra feita à mão. Agora é a vez da regressão logística: escreva classificar_iris(X, y), que treina um modelo com treinar_logistica (seção 4) e devolve as classes previstas (0 ou 1) para as flores de X.
Meta: acurácia de pelo menos 0,90. Não esqueça de padronizar!
(Estamos medindo nos mesmos dados do treino, o que é otimista. A aula 01.07 mostra o jeito certo.)
mascara = iris.target > 0                              # só versicolor (1) e virginica (2)
X_iris = iris.data[mascara][:, 2:4]                    # comprimento e largura da pétala
y_iris = (iris.target[mascara] == 2).astype(int)       # 1 = virginica, 0 = versicolor


def classificar_iris(X, y):
    ...  # seu código aqui


previsto = classificar_iris(X_iris, y_iris)
if previsto is None:
    print("⏳ ainda não implementado")
else:
    acuracia = np.mean(previsto == y_iris)
    print(("✅" if acuracia >= 0.9 else "❌") + f" acurácia = {acuracia:.2f} (meta: 0,90)")
⏳ ainda não implementadoDica
Três passos: padronize X com a média e o desvio de cada coluna (axis=0), treine com treinar_logistica(Xz, y, taxa=0.5, epocas=2000) e transforme as probabilidades em classes com o limiar de 0,5.
Gabarito
def classificar_iris(X, y):
    media, desvio = X.mean(axis=0), X.std(axis=0)
    Xz = (X - media) / desvio
    w, b, _ = treinar_logistica(Xz, y, taxa=0.5, epocas=2000)
    return (sigmoide(Xz @ w + b) >= 0.5).astype(int)
Dá 0,94, a mesma faixa da sua regra à mão na 01.01. A diferença é que aqui ninguém precisou olhar o gráfico: o modelo achou a fronteira sozinho, e o mesmo código funciona com 4, 40 ou 400 features.
Resumo
| Conceito | Em uma frase | Código |
|---|---|---|
| regressão logística | a reta de sempre dentro de uma sigmoide | p = sigmoide(X @ w + b) |
| probabilidade | a saída fica sempre entre 0 e 1 | p |
| fronteira de decisão | onde , ou seja, onde a reta de dentro vale zero | X @ w + b == 0 |
| log-loss | custo que pune muito a certeza errada | -np.mean(y*np.log(p) + (1-y)*np.log(1-p)) |
| gradiente | erro × entrada, igual ao da regressão linear | X.T @ (p - y) / n |
| limiar | a régua que transforma probabilidade em classe | (p >= limiar).astype(int) |
| scikit-learn | LogisticRegression, com regularização por padrão (C) |
predict_proba, predict |
A grande ideia: a regressão logística é um neurônio. Uma camada de rede neural é um monte deles lado a lado (X @ W + b, aula 00.04), com uma função de ativação depois.