Aula 5 de 13
k-NN (vizinhos mais próximos)
Objetivo: entender e implementar o k-NN, o classificador mais simples que existe: olhar os exemplos mais parecidos e seguir a maioria.
Por que isso importa: o k-NN junta tudo que você já viu (distância, broadcasting, fatiamento, argmax) num algoritmo completo de ML. Ele também mostra, de um jeito bem visual, duas ideias que vão te acompanhar sempre: o equilíbrio entre “decorar” e “generalizar” (o k) e a importância da escala das features. E buscar os vizinhos mais próximos é a base da busca por similaridade em embeddings (disciplina 04).
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
CORES = [AZUL, LARANJA, VERDE]
MARCADORES = ["o", "s", "^"]
1. A ideia: “diga-me com quem andas”
O problema: chegou uma fruta nova e você mediu a doçura e a acidez dela (de 0 a 10). É maçã ou laranja?
Você tem 30 frutas conhecidas. A ideia do k-NN é: olhe as k frutas conhecidas mais parecidas com a nova e siga a maioria. “Parecida” quer dizer perto, e perto quer dizer distância pequena, aquela da aula 00.04.
Você já fez metade disso: o mais_proximo das aulas 00.01 e 00.02 é o k-NN com k = 1.
rng = np.random.default_rng(seed=3)
macas = rng.normal([7, 3], 1.0, size=(15, 2))      # doçura ~7, acidez ~3
laranjas = rng.normal([5, 6], 1.0, size=(15, 2))   # doçura ~5, acidez ~6

X_frutas = np.vstack([macas, laranjas])            # empilha as linhas: (30, 2)
y_frutas = np.array([0] * 15 + [1] * 15)           # 0 = maçã, 1 = laranja
NOMES_FRUTAS = ["maçã", "laranja"]

nova = np.array([6.0, 4.8])

fig, ax = plt.subplots(figsize=(5.5, 5))
for classe in [0, 1]:
    pontos = X_frutas[y_frutas == classe]
    ax.scatter(pontos[:, 0], pontos[:, 1], color=CORES[classe], marker=MARCADORES[classe], label=NOMES_FRUTAS[classe])
ax.scatter(nova[0], nova[1], color="black", marker="*", s=250, label="fruta nova")
ax.set_title("Maçã ou laranja?")
ax.set_xlabel("doçura")
ax.set_ylabel("acidez")
ax.set_aspect("equal")
ax.legend(loc="lower left")
ax.grid(alpha=0.3)
plt.show()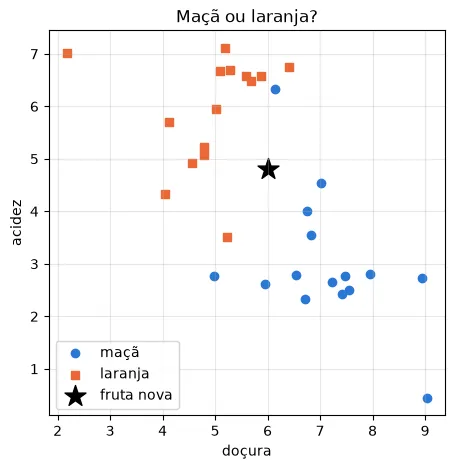
Um detalhe importante: o k-NN não treina. Nas aulas 01.02 e 01.03, treinar era achar os pesos w e b. Aqui não existe peso nenhum: o “treino” é só guardar os exemplos. Todo o trabalho acontece na hora de prever. Por isso se diz que o k-NN é um algoritmo “preguiçoso” (lazy learning).
Em TS, o modelo inteiro caberia nisto:
class KNN {
  fit(X: number[][], y: number[]) {
    this.X = X;          // "treinar" = guardar
    this.y = y;
  }
  predict(novo: number[]): number {
    // calcula a distância até todos, pega os k mais perto, faz a votação
  }
}
2. k-NN do zero, um passo por vez
Passo 1: a distância até todas as frutas
É o broadcasting da aula 00.02: X_frutas - nova é (30, 2) menos (2,), e a nova fruta é subtraída de cada linha.
distancias = np.sqrt(((X_frutas - nova) ** 2).sum(axis=1))
print(distancias.shape)          # uma distância por fruta conhecida
print(distancias[:5].round(2))
(30,)
[5.31 2.76 2.09 2.27 1.53]Passo 2: ordenar, mas guardando quem é quem
np.sort(distancias) ordena as distâncias, mas perde a informação de qual fruta é cada uma. O que a gente quer são os índices das frutas, em ordem de distância. É isso que o np.argsort devolve.
Num exemplo pequeno:
| índice | 0 | 1 | 2 |
|---|---|---|---|
| distância | 30 | 10 | 20 |
A mais perto é a de índice 1, depois a 2, depois a 0. Então np.argsort([30, 10, 20]) devolve [1, 2, 0]. Em TS:
const ordem = distancias.map((_, i) => i).sort((a, b) => distancias[a] - distancias[b]);print(np.argsort(np.array([30, 10, 20])))
k = 5
ordem = np.argsort(distancias)
vizinhos = ordem[:k] # fatiamento: os k primeiros índices = os k mais perto
print(vizinhos)[1 2 0]
[10 14 25 27 21]Passo 3: pegar os rótulos dos vizinhos
Um array de índices pode ser usado como índice: y_frutas[vizinhos] pega o rótulo de cada vizinho, na mesma ordem. Em TS, seria vizinhos.map(i => y[i]).
rotulos_vizinhos = y_frutas[vizinhos]
for i in vizinhos:
    print(f"fruta {i:2d}: distância {distancias[i]:.2f} -> {NOMES_FRUTAS[y_frutas[i]]}")
fruta 10: distância 1.06 -> maçã
fruta 14: distância 1.10 -> maçã
fruta 25: distância 1.24 -> laranja
fruta 27: distância 1.28 -> laranja
fruta 21: distância 1.45 -> laranjaPasso 4: a votação
np.bincount conta quantas vezes aparece cada número inteiro: np.bincount([1, 0, 1, 1]) devolve [1, 3] (um 0 e três 1s). O argmax da aula 00.02 diz qual posição tem a maior contagem, ou seja, a classe vencedora. Em TS:
const contagem = [0, 0];
for (const r of rotulos) contagem[r]++;
const vencedora = contagem.indexOf(Math.max(...contagem));
votos = np.bincount(rotulos_vizinhos)
print("votos:", votos)
print("com k = 5:", NOMES_FRUTAS[votos.argmax()])
print("com k = 1:", NOMES_FRUTAS[y_frutas[ordem[0]]])votos: [2 3]
com k = 5: laranja
com k = 1: maçãRepare: com k = 1, a fruta nova é maçã (a vizinha mais próxima é uma maçã). Com k = 5, vira laranja (3 votos contra 2). O k muda a resposta, e a próxima seção mostra o que isso significa.
Empates: com 2 classes e k par, pode dar empate (2 × 2). Nesse caso, o argmax fica com a primeira classe. Por isso, com 2 classes, costuma-se usar k ímpar.
3. O efeito do k
Para ver o que o k faz, vamos classificar todos os pontos de uma grade, com o meshgrid da aula 00.03, e pintar cada região com a cor da classe prevista. A linha onde a cor muda é a fronteira de decisão.
Pra desenhar, precisamos classificar dezenas de milhares de pontos. Então aqui usamos o k-NN pronto do scikit-learn, que faz exatamente as contas da seção 2. A seção 5 apresenta ele direito, e no exercício 4 você escreve o seu.
from sklearn.datasets import make_moons
from sklearn.neighbors import KNeighborsClassifier


def desenhar_regioes(ax, modelo, X, y, titulo):
    # uma grade de 200 × 200 pontos cobrindo os dados
    x0 = np.linspace(X[:, 0].min() - 0.5, X[:, 0].max() + 0.5, 200)
    x1 = np.linspace(X[:, 1].min() - 0.5, X[:, 1].max() + 0.5, 200)
    G0, G1 = np.meshgrid(x0, x1)
    # ravel "achata" cada grade (200, 200) numa lista de 40.000 valores;
    # column_stack junta as duas listas como colunas: 40.000 pontos (x0, x1)
    pontos = np.column_stack([G0.ravel(), G1.ravel()])
    classes = modelo.predict(pontos).reshape(G0.shape)
    n = len(np.unique(y))
    ax.contourf(G0, G1, classes, levels=np.arange(n + 1) - 0.5, colors=CORES[:n], alpha=0.18)
    for c in range(n):
        ax.scatter(X[y == c, 0], X[y == c, 1], color=CORES[c], marker=MARCADORES[c], s=18, label=f"classe {c}")
    ax.set_title(titulo)
    ax.set_xlabel("x₀")
    ax.set_ylabel("x₁")


X_luas, y_luas = make_moons(n_samples=200, noise=0.3, random_state=0)   # duas "meias-luas" com ruído

fig, axs = plt.subplots(1, 3, figsize=(15, 4.5))
for ax, k in zip(axs, [1, 5, 25]):
    modelo = KNeighborsClassifier(n_neighbors=k).fit(X_luas, y_luas)
    acerto = modelo.score(X_luas, y_luas)        # acurácia nos próprios dados
    desenhar_regioes(ax, modelo, X_luas, y_luas, f"k = {k}  (acerta {acerto:.0%} do treino)")
axs[0].legend(loc="lower right")
fig.tight_layout()
plt.show()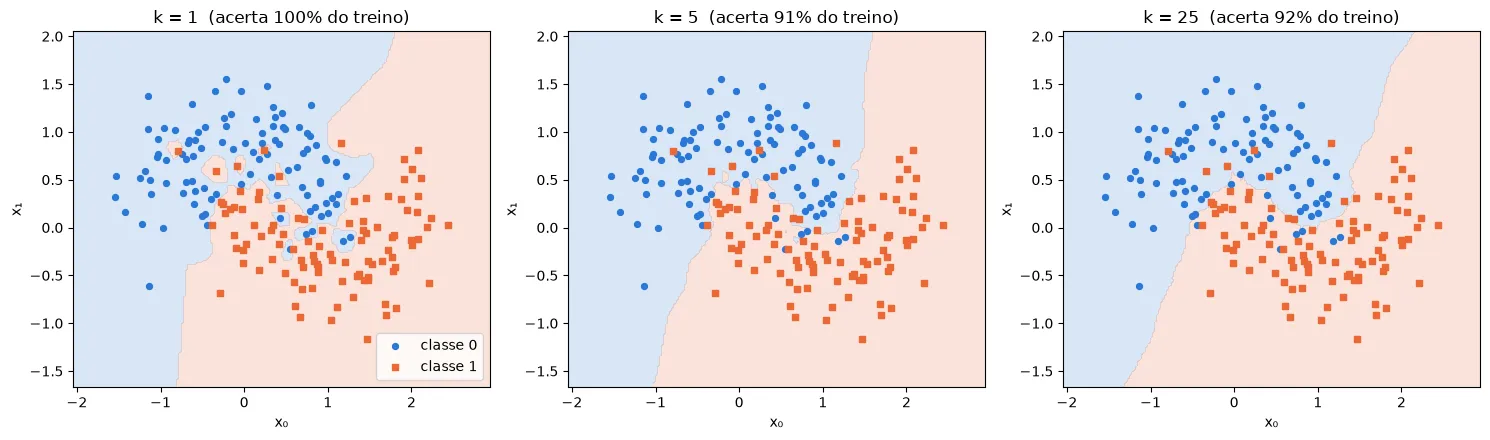
- k = 1: fronteira “nervosa”. Ela contorna cada ponto, até os que caíram “do lado errado” por causa do ruído. Acerta 100% dos dados que conhece, porque cada ponto é o vizinho mais próximo de si mesmo. Isso é decorar, não aprender: um ponto novo perto de um ruído vai ser classificado errado.
- k = 25: fronteira “preguiçosa”. Ela fica suave e ignora os detalhes. Se
kcrescer demais, no limite ela vota com todos os pontos e vira o “modelo burro” da 01.01. - O
kbom fica no meio, e não dá pra achá-lo olhando o acerto nos próprios dados de treino (o k = 1 sempre “ganharia”).
Esse equilíbrio entre decorar e generalizar tem nome, overfitting × underfitting, e é o assunto da aula 01.07.
4. A escala importa
O problema: uma fábrica quer separar dois tipos de peça. O que diferencia os tipos é o comprimento, medido em metros (a peça A tem ~0,30 m e a B, ~0,36 m). A espessura, em milímetros (de 10 a 60 mm), não tem nada a ver com o tipo.
def gerar_pecas(n, seed):
    rng = np.random.default_rng(seed)
    tipo = rng.integers(0, 2, size=n)                                                # 0 = peça A, 1 = peça B
    comprimento = np.where(tipo == 0, 0.30, 0.36) + rng.normal(0, 0.015, size=n)   # metros: é o que separa
    espessura = rng.uniform(10, 60, size=n)                                          # milímetros: não separa nada
    return np.column_stack([comprimento, espessura]), tipo


X_pecas, y_pecas = gerar_pecas(200, seed=1)    # peças conhecidas
X_novas, y_novas = gerar_pecas(100, seed=2)    # peças novas, pra medir o acerto

a, b = X_pecas[0], X_pecas[1]                  # uma peça A e uma peça B
print("peça A:", a.round(3), "   peça B:", b.round(3))
print(f"diferença de comprimento ao quadrado: {(a[0] - b[0]) ** 2:.4f}")
print(f"diferença de espessura ao quadrado:   {(a[1] - b[1]) ** 2:.1f}")
peça A: [ 0.305 31.223] peça B: [ 0.35 38.785]
diferença de comprimento ao quadrado: 0.0020
diferença de espessura ao quadrado: 57.2Dentro da distância, a espessura contribui com ~57 e o comprimento com ~0,002. A distância praticamente só enxerga a espessura, que é justamente a feature inútil. O comprimento, que decide tudo, some porque os números dele são pequenos.
A solução é a padronização (z-score) das aulas 00.02 e 00.06: cada feature vira “quantos desvios padrão acima ou abaixo da média”. Aí todas ficam na mesma escala.
Cuidado: a média e o desvio são calculados só com as peças conhecidas e depois aplicados às novas. As peças novas fazem o papel do mundo real, e no mundo real você não conhece os dados de amanhã.
media = X_pecas.mean(axis=0)
desvio = X_pecas.std(axis=0)
Z_pecas = (X_pecas - media) / desvio
Z_novas = (X_novas - media) / desvio            # a média e o desvio das peças CONHECIDAS

sem = KNeighborsClassifier(n_neighbors=5).fit(X_pecas, y_pecas).score(X_novas, y_novas)
com = KNeighborsClassifier(n_neighbors=5).fit(Z_pecas, y_pecas).score(Z_novas, y_novas)
print(f"acerto nas peças novas, sem padronizar: {sem:.0%}")
print(f"acerto nas peças novas, padronizado:    {com:.0%}")
acerto nas peças novas, sem padronizar: 50%
acerto nas peças novas, padronizado: 96%fig, axs = plt.subplots(1, 2, figsize=(11, 5))
for c, nome in enumerate(["peça A", "peça B"]):
axs[0].scatter(X_pecas[y_pecas == c, 0], X_pecas[y_pecas == c, 1], color=CORES[c], marker=MARCADORES[c], s=15, label=nome)
axs[1].scatter(Z_pecas[y_pecas == c, 0], Z_pecas[y_pecas == c, 1], color=CORES[c], marker=MARCADORES[c], s=15, label=nome)
axs[0].set_xlim(0.33 - 30, 0.33 + 30) # mesma escala nos dois eixos: é assim que a distância "vê"
axs[0].set_ylim(5, 65)
axs[0].set_aspect("equal")
axs[0].set_title("Sem padronizar: as classes ficam empilhadas")
axs[0].set_xlabel("comprimento (m)")
axs[0].set_ylabel("espessura (mm)")
axs[1].set_aspect("equal")
axs[1].set_title("Padronizado: o comprimento aparece")
axs[1].set_xlabel("comprimento (z-score)")
axs[1].set_ylabel("espessura (z-score)")
axs[0].legend(loc="upper right") # uma legenda basta: as classes são as mesmas nos dois
for ax in axs:
ax.grid(alpha=0.3)
fig.tight_layout()
plt.show()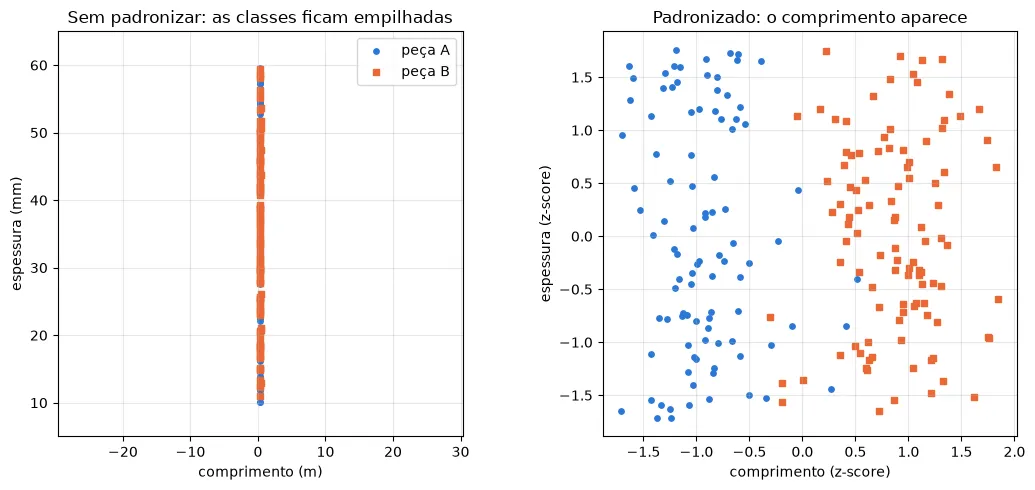
Na esquerda, os eixos estão na mesma escala, que é como a distância enxerga os dados. A diferença de 6 cm entre as peças A e B fica invisível perto dos 50 mm de variação da espessura. Na direita, depois do z-score, as duas classes se separam na horizontal.
Regra prática: qualquer algoritmo baseado em distância (k-NN, k-means, SVM…) precisa de features na mesma escala. Você viu o mesmo problema na 01.03, deixando o gradiente descendente lento.
5. Com o scikit-learn
O KNeighborsClassifier segue o padrão fit/predict da 01.01. Vamos usá-lo na Iris, com as 4 medidas de cada flor. Em 4 dimensões a distância é calculada do mesmo jeito, só com mais termos na soma (aula 00.04).
Desta vez, pra medir o acerto de forma honesta, separamos um pedaço das flores pra teste: o modelo aprende com 70% delas e é avaliado nos outros 30%, que ele nunca viu. A aula 01.07 explica essa separação em detalhe.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

iris = load_iris()

# devolve 4 arrays, que desempacotamos de uma vez (como a tupla da aula 00.01)
X_treino_iris, X_teste_iris, y_treino_iris, y_teste_iris = train_test_split(
    iris.data, iris.target, test_size=0.3, random_state=42, stratify=iris.target
)
print(X_treino_iris.shape, X_teste_iris.shape)

modelo = KNeighborsClassifier(n_neighbors=5)
modelo.fit(X_treino_iris, y_treino_iris)          # "treinar" = guardar as 105 flores
previstas = modelo.predict(X_teste_iris)
print("acerto no teste:", modelo.score(X_teste_iris, y_teste_iris))
(105, 4) (45, 4)
acerto no teste: 0.9777777777777777random_state=42fixa o sorteio, pra dar sempre a mesma separação (a mesma ideia daseed).stratify=iris.targetmantém a proporção das 3 espécies no treino e no teste.- Aqui não foi preciso padronizar, porque as 4 medidas da Iris estão em centímetros, com escalas parecidas.
No exercício 4 você vai conferir que o seu k-NN dá exatamente as mesmas previsões.
k-NN pra regressão
Pra prever um número, em vez de votar, tire a média dos vizinhos. O scikit-learn tem o KNeighborsRegressor. Com as casas das aulas anteriores, prevendo o preço pela área:
from sklearn.neighbors import KNeighborsRegressor


def gerar_casas(n=100, seed=42):
    rng = np.random.default_rng(seed)
    area = rng.uniform(40, 200, size=n)             # m²
    quartos = rng.integers(1, 5, size=n)            # 1 a 4
    idade = rng.uniform(0, 40, size=n)              # anos
    preco = 2.0 * area + 25 * quartos - 1.5 * idade + 50 + rng.normal(0, 20, size=n)   # mil R$
    return area, quartos, idade, preco


area, quartos, idade, preco = gerar_casas()
X_area = area.reshape(-1, 1)                        # o scikit-learn quer X em 2D: (n, 1)
grade = np.linspace(40, 200, 300).reshape(-1, 1)

fig, ax = plt.subplots(figsize=(7, 4.5))
ax.scatter(area, preco, color="gray", alpha=0.5, s=15, label="casas")
for k, cor in [(3, AZUL), (25, LARANJA)]:
    regressor = KNeighborsRegressor(n_neighbors=k).fit(X_area, preco)
    ax.plot(grade[:, 0], regressor.predict(grade), color=cor, linewidth=2, label=f"k = {k}")
ax.set_title("k-NN pra regressão: a média dos vizinhos")
ax.set_xlabel("área (m²)")
ax.set_ylabel("preço (mil R$)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()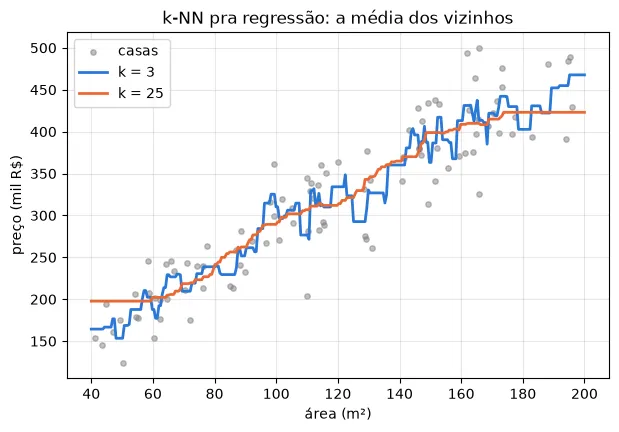
A previsão sai em “escadinha”: ela só muda quando o conjunto de vizinhos muda. Com k pequeno, a escada segue cada ruído; com k grande, fica mais lisa, mas “achata” as pontas, porque perto dos 200 m² todos os vizinhos são menores.
O preço de ser preguiçoso
O k-NN não gasta nada pra treinar, mas cada previsão compara o ponto novo com todos os exemplos guardados. Com 1 milhão de exemplos, são 1 milhão de distâncias por previsão. O scikit-learn usa estruturas de árvore (KD-tree, ball tree) pra evitar comparar com todos. Os sistemas de busca por embeddings (disciplina 04) usam buscas aproximadas de vizinhos, que trocam um pouco de precisão por muita velocidade.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Distância de Manhattan
A distância que usamos até agora (a euclidiana) é a linha reta. A distância de Manhattan é a do táxi numa cidade de quarteirões: só dá pra andar na horizontal e na vertical, então ela é a soma das diferenças em cada eixo, sem sinal:
De (0, 0) até (3, 4): em linha reta são 5, e de táxi são 3 + 4 = 7.
Escreva distancias_manhattan(ponto, X), que devolve a distância de Manhattan do ponto até cada linha de X, sem laço.
def distancias_manhattan(ponto, X):
    ...  # seu código aqui


confere(distancias_manhattan(np.array([0, 0]), np.array([[3, 4], [1, 1], [-2, 0]])), [7, 2, 2])
confere(distancias_manhattan(np.array([1, 2, 3]), np.array([[1, 2, 3], [0, 0, 0]])), [0, 6])
Dica
Igual à euclidiana, trocando “eleva ao quadrado, soma e tira a raiz” por “valor absoluto (np.abs) e soma”. Qual axis?
Gabarito
def distancias_manhattan(ponto, X):
    return np.abs(X - ponto).sum(axis=1)
O KNeighborsClassifier aceita essa distância com metric="manhattan".
Exercício 2 · Os k vizinhos
Escreva k_vizinhos(ponto, X, k), que devolve os índices das k linhas de X mais próximas do ponto (distância euclidiana), do mais perto pro mais longe. São os passos 1 e 2 da seção 2.
def k_vizinhos(ponto, X, k):
    ...  # seu código aqui


X_teste_ex = np.array([[5, 5], [1, 0], [0, 2], [-3, 0], [0.5, 0.5]])
confere(k_vizinhos(np.array([0, 0]), X_teste_ex, 3), [4, 1, 2])
confere(k_vizinhos(np.array([4, 4]), X_teste_ex, 1), [0])
Dica
Calcule as distâncias, use np.argsort e fatie os k primeiros.
Gabarito
def k_vizinhos(ponto, X, k):
    d = np.sqrt(((X - ponto) ** 2).sum(axis=1))
    return np.argsort(d, kind="stable")[:k]
O kind="stable" garante que, se duas distâncias forem iguais, fica na frente quem aparece antes em X. É o mesmo critério do scikit-learn, e é o que faz o exercício 4 dar exatamente o mesmo resultado dele.
Exercício 3 · A votação
Escreva votar(rotulos), que recebe os rótulos dos vizinhos (inteiros 0, 1, 2…) e devolve o que mais aparece. Em caso de empate, fica o menor rótulo.
def votar(rotulos):
    ...  # seu código aqui


confere(votar(np.array([1, 0, 1, 1])), 1)
confere(votar(np.array([2, 2, 0, 1, 2])), 2)
confere(votar(np.array([0, 1])), 0)        # empate: fica o menor
Dica
É o passo 4 da seção 2, e cabe numa linha. O argmax já devolve a primeira posição em caso de empate.
Gabarito
def votar(rotulos):
    return np.bincount(rotulos).argmax()
Exercício 4 · O seu k-NN completo
Junte as peças: escreva knn_prever(X_treino, y_treino, X_novos, k), que devolve a classe prevista para cada linha de X_novos. Use a sua k_vizinhos e a sua votar. Um laço (ou uma list comprehension) sobre os pontos novos está liberado.
A célula confere num exemplo pequeno e depois compara com o scikit-learn na Iris da seção 5.
def knn_prever(X_treino, y_treino, X_novos, k):
    ...  # seu código aqui


X_mini = np.array([[0, 0], [0, 1], [1, 0], [5, 5], [5, 6], [6, 5]])
y_mini = np.array([0, 0, 0, 1, 1, 1])
confere(knn_prever(X_mini, y_mini, np.array([[0.5, 0.5], [5.5, 5.5], [4, 4]]), 3), [0, 1, 1])

# o seu k-NN contra o do scikit-learn, na Iris
if knn_prever(X_mini, y_mini, X_mini[:1], 1) is not None:
    meu = knn_prever(X_treino_iris, y_treino_iris, X_teste_iris, 5)
    do_sklearn = KNeighborsClassifier(n_neighbors=5).fit(X_treino_iris, y_treino_iris).predict(X_teste_iris)
    confere(meu, do_sklearn)
    print("seu acerto na Iris:", (meu == y_teste_iris).mean())
Dica
Para cada ponto p de X_novos: ache os índices dos vizinhos com k_vizinhos(p, X_treino, k), pegue os rótulos deles com y_treino[...] e passe pra votar. No fim, transforme a lista em array com np.array(...).
Gabarito
def knn_prever(X_treino, y_treino, X_novos, k):
    return np.array([votar(y_treino[k_vizinhos(p, X_treino, k)]) for p in X_novos])
Exercício 5 (desafio) · k-NN pra regressão
Escreva knn_regressao(X_treino, y_treino, X_novos, k), que prevê um número para cada ponto novo: a média dos y dos k vizinhos. Reaproveite a sua k_vizinhos.
A célula confere num exemplo pequeno e depois compara com o KNeighborsRegressor nas casas.
def knn_regressao(X_treino, y_treino, X_novos, k):
    ...  # seu código aqui


X_r = np.array([[1], [2], [3], [10], [11]])
y_r = np.array([10, 20, 30, 100, 110])
# pra 2: vizinhos 2, 1 e 3 -> média de 20, 10 e 30 = 20
# pra 10.5: vizinhos 10, 11 e 3 -> média de 100, 110 e 30 = 80
confere(knn_regressao(X_r, y_r, np.array([[2], [10.5]]), 3), [20, 80])

if knn_regressao(X_r, y_r, X_r[:1], 1) is not None:
    novas_areas = np.array([[60], [100], [150], [190]])
    do_sklearn = KNeighborsRegressor(n_neighbors=5).fit(X_area, preco).predict(novas_areas)
    confere(knn_regressao(X_area, preco, novas_areas, 5), do_sklearn)
Dica
É o exercício 4 trocando a votar por .mean(). Repare que X_r tem formato (5, 1): a sua k_vizinhos precisa funcionar com uma feature só. Se você usou axis=1, já funciona.
Gabarito
def knn_regressao(X_treino, y_treino, X_novos, k):
    return np.array([y_treino[k_vizinhos(p, X_treino, k)].mean() for p in X_novos])
Resumo
| Ideia | Na prática |
|---|---|
| k-NN | olha os k exemplos mais próximos e segue a maioria (ou tira a média, na regressão) |
| “treinar” | só guardar os dados: todo o custo fica na hora de prever |
| do zero | distâncias → np.argsort → [:k] → y[vizinhos] → np.bincount(...).argmax() |
| k pequeno | fronteira “nervosa”: decora o ruído (overfitting) |
| k grande | fronteira “preguiçosa”: ignora os detalhes (underfitting) |
| escala | com distância, padronize as features (z-score com a média e o desvio do treino) |
| scikit-learn | KNeighborsClassifier(n_neighbors=k) e KNeighborsRegressor, com fit/predict/score |