Aula 1 de 13
O que é aprender com dados
Objetivo: entender o que “aprender” significa pra um computador, o vocabulário básico (exemplo, feature, rótulo, X e y) e os tipos de problema de ML.
Por que isso importa: todo o resto da disciplina (regressão, k-NN, k-means, métricas…) é variação das ideias desta aula. Com esse vocabulário, qualquer tutorial ou documentação de ML fica legível.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
1. Programar × aprender
O problema: escrever um filtro de spam. Do jeito tradicional, você mesmo escreve as regras:
function ehSpam(email: string): boolean {
  if (email.includes("GANHE DINHEIRO")) return true;
  if (email.includes("clique aqui") && email.includes("grátis")) return true;
  // ... e mais 500 regras, que os spammers aprendem a driblar
  return false;
}
Ninguém sabe de antemão quais são as regras certas, elas são centenas e mudam o tempo todo.
A ideia do ML é inverter o jogo: em vez de escrever a regra, você mostra exemplos com a resposta (e-mails já marcados como spam ou não), e um algoritmo encontra a regra sozinho.
| entra | sai | |
|---|---|---|
| programação tradicional | regras + dados | respostas |
| machine learning | dados + respostas | regras |
Um exemplo minúsculo
13 e-mails, e uma única informação sobre cada um: quantos “!” ele tem. O modelo é uma função simples: marca como spam quem tem mais “!” que um certo limite.
O limite é o parâmetro do modelo. Aprender é achar o valor do limite que erra menos nos exemplos.
exclamacoes = np.array([0, 1, 0, 7, 5, 0, 9, 2, 6, 1, 3, 4, 8])   # quantos "!" cada e-mail tem
spam        = np.array([0, 0, 0, 1, 1, 0, 1, 0, 1, 0, 0, 1, 0])   # a resposta: 1 = spam, 0 = não é spam


def modelo(exclamacoes, limite):
    # marca como spam (1) quem tem mais "!" que o limite
    return np.where(exclamacoes > limite, 1, 0)


# "aprender": testar cada limite possível e ficar com o que acerta mais
limites = np.arange(10)
acuracias = np.array([np.mean(modelo(exclamacoes, limite) == spam) for limite in limites])

for limite, acuracia in zip(limites, acuracias):
    print(f"limite {limite}: acertou {acuracia:.0%}")

melhor = limites[acuracias.argmax()]
print("\nAprendido: limite =", melhor)
limite 0: acertou 62%
limite 1: acertou 77%
limite 2: acertou 85%
limite 3: acertou 92%
limite 4: acertou 85%
limite 5: acertou 77%
limite 6: acertou 69%
limite 7: acertou 62%
limite 8: acertou 69%
limite 9: acertou 62%
Aprendido: limite = 3É isso. Com o limite aprendido, o modelo pode julgar e-mails novos, que ele nunca viu.
Três observações que valem pro ML inteiro:
- Nenhum limite acerta 100%. O último e-mail é de um amigo empolgado, com 8 “!”, e não é spam. Dados reais têm esse tipo de “ruído”, e um bom modelo erra pouco, não zero.
- Aqui deu pra testar todos os valores, porque só existe um parâmetro. Modelos de verdade têm milhares ou bilhões de parâmetros. Pra eles, o gradiente descendente (aula 01.03) encontra bons valores sem testar tudo.
- Vocabulário: o modelo é uma função com parâmetros. Treinar (ou aprender) é ajustar os parâmetros pra errar pouco nos exemplos. Os exemplos com resposta são os dados de treino.
2. Os dados: X e y
Pro resto da aula, vamos usar a base Iris, a mais clássica de ML (é de 1936!). São 150 flores de 3 espécies de íris, com 4 medidas de cada flor.
O load_iris() do scikit-learn devolve um objeto com os dados e alguns nomes. Ele funciona como um objeto do TS:
const iris = {
  data: [[5.1, 3.5, 1.4, 0.2], /* ... 150 linhas */],
  target: [0, 0, 0, /* ... */],
  feature_names: ["sepal length (cm)", /* ... */],
  target_names: ["setosa", "versicolor", "virginica"],
};
Dá pra acessar os campos com ponto (iris.data) ou com colchete (iris["data"]).
A base Iris (Fisher, 1936) vem com o scikit-learn e está no UCI Machine Learning Repository sob licença CC BY 4.0.
from sklearn.datasets import load_iris

iris = load_iris()
X = iris.data        # as medidas: uma linha por flor, uma coluna por medida
y = iris.target      # a espécie de cada flor, como número: 0, 1 ou 2

print(X.shape, y.shape)
print(iris.feature_names)
print(iris.target_names)

for i in [0, 50, 100]:                  # uma flor de cada espécie
    print(X[i], "->", y[i], iris.target_names[y[i]])
(150, 4) (150,)
['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
['setosa' 'versicolor' 'virginica']
[5.1 3.5 1.4 0.2] -> 0 setosa
[7. 3.2 4.7 1.4] -> 1 versicolor
[6.3 3.3 6. 2.5] -> 2 virginicaÉ exatamente o X e o y da aula 00.02 (as casas):
| Termo | O que é | Na íris |
|---|---|---|
| exemplo (ou amostra) | uma linha | uma flor |
| feature | uma coluna de X |
o comprimento da pétala, por exemplo |
X |
a tabela das features, formato (n, d) | (150, 4): 150 flores, 4 medidas |
rótulo (ou alvo) y |
a resposta de cada exemplo | a espécie: 0, 1 ou 2 |
As espécies viram números porque modelos só trabalham com números. O target_names guarda o nome de cada número.
Quantas flores tem de cada espécie? O np.bincount conta quantas vezes cada inteiro aparece. Em TS, seria:
const contagem = [0, 0, 0];
for (const especie of y) contagem[especie]++;print(np.bincount(y)) # 50 setosas, 50 versicolores, 50 virginicas[50 50 50]3. Tipos de problema
Regressão × classificação
O tipo do y define o tipo do problema:
- Regressão: o
yé um número, e errar por pouco é melhor que errar por muito. Exemplo: o preço de uma casa. - Classificação: o
yé uma categoria. Exemplo: a espécie de uma flor. Mesmo guardada como 0, 1 e 2, não faz sentido dizer que a espécie 2 está “mais perto” da 1 que da 0.
As casas abaixo vão aparecer de novo nas aulas 01.02 e 01.03:
def gerar_casas(n=100, seed=42):
    rng = np.random.default_rng(seed)
    area = rng.uniform(40, 200, size=n)             # m²
    quartos = rng.integers(1, 5, size=n)            # 1 a 4
    idade = rng.uniform(0, 40, size=n)              # anos
    preco = 2.0 * area + 25 * quartos - 1.5 * idade + 50 + rng.normal(0, 20, size=n)   # mil R$
    return area, quartos, idade, preco


area, quartos, idade, preco = gerar_casas()
print("regressão, y = preço:", preco[:5].round(1))
print("classificação, y = espécie:", y[:5], y[50:55], y[100:105])
regressão, y = preço: [376.2 281.5 417. 437.5 177.9]
classificação, y = espécie: [0 0 0 0 0] [1 1 1 1 1] [2 2 2 2 2]Supervisionado × não supervisionado
- Supervisionado: os exemplos vêm com o
y. Alguém rotulou cada exemplo, e o modelo aprende a prever o rótulo. É o caso das casas e das flores. - Não supervisionado: só existe o
X. O objetivo é achar estrutura nos dados, como grupos de exemplos parecidos.
Veja as flores com e sem os rótulos:
comprimento, largura = X[:, 2], X[:, 3]      # as medidas da pétala
cores = [AZUL, LARANJA, VERDE]
marcadores = ["o", "s", "^"]

fig, axs = plt.subplots(1, 2, figsize=(11, 4.5), sharex=True, sharey=True)

axs[0].scatter(comprimento, largura, color="gray", alpha=0.6)
axs[0].set_title("Sem rótulos: só o X")

for especie in range(3):
    mascara = y == especie
    axs[1].scatter(comprimento[mascara], largura[mascara], color=cores[especie],
                   marker=marcadores[especie], alpha=0.8, label=iris.target_names[especie])
axs[1].set_title("Com rótulos: X e y")
axs[1].legend()

for ax in axs:
    ax.set_xlabel("comprimento da pétala (cm)")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("largura da pétala (cm)")
plt.show()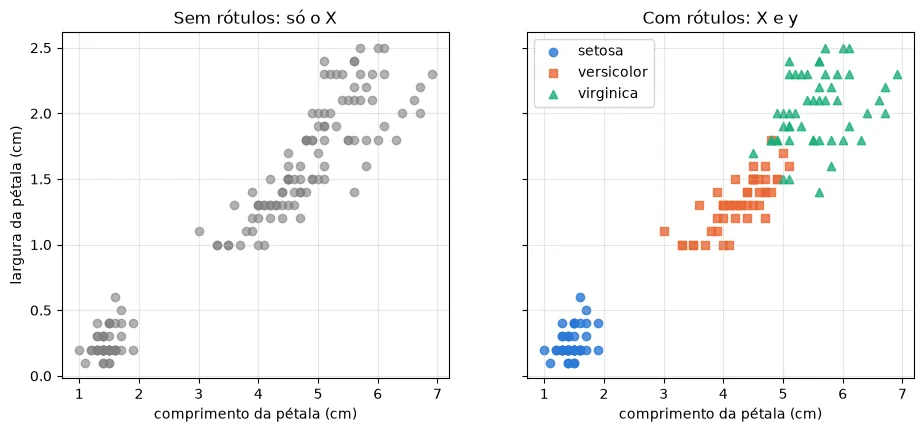
Mesmo sem rótulos, dá pra ver pelo menos dois grupos: um pequeno, embaixo à esquerda, e um grande, à direita. O k-means (aula 01.06) é um algoritmo não supervisionado que encontra grupos assim sozinho.
4. Você é o algoritmo
O problema: separar as setosas das outras duas espécies. No gráfico, as pétalas das setosas (azul) são bem menores que as outras. Uma regra feita à mão resolve: se o comprimento da pétala for menor que 2,5 cm, é setosa.
fig, ax = plt.subplots(figsize=(6, 4.5))
for especie in range(3):
    mascara = y == especie
    ax.scatter(comprimento[mascara], largura[mascara], color=cores[especie],
               marker=marcadores[especie], alpha=0.8, label=iris.target_names[especie])
ax.axvline(2.5, color="gray", linestyle="--", label="comprimento = 2,5 cm")
ax.set_title("Uma regra feita à mão")
ax.set_xlabel("comprimento da pétala (cm)")
ax.set_ylabel("largura da pétala (cm)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()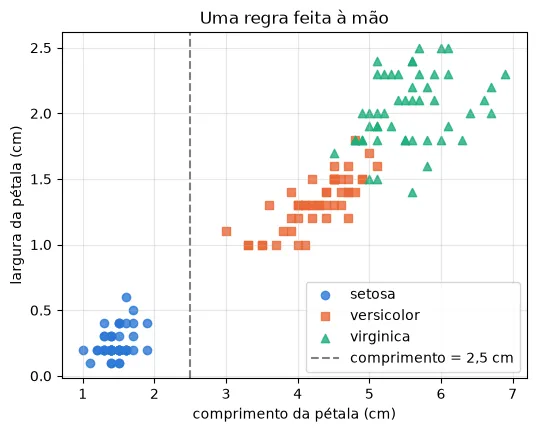
eh_setosa = (y == 0).astype(int)                 # a resposta certa: 1 se é setosa, 0 se não é
previsto = np.where(comprimento < 2.5, 1, 0)     # a sua regra

print("acurácia:", np.mean(previsto == eh_setosa))
acurácia: 1.0100%! Separar a setosa é fácil. A versicolor e a virginica se misturam um pouco no gráfico, e separar as duas fica pro exercício 3.
5. Linha de base: o modelo burro
O problema: um modelo acertou 67%. Isso é bom ou ruim?
Depende. No problema “é setosa ou não?”, 2 de cada 3 flores não são setosa. Um “modelo” que responde sempre “não é setosa”, sem olhar nada, já acerta 67%:
chute_burro = np.zeros_like(eh_setosa)          # sempre 0: "não é setosa"
print("acurácia do modelo burro:", np.mean(chute_burro == eh_setosa))
acurácia do modelo burro: 0.6666666666666666Então 67% não vale nada nesse problema. O modelo burro é a linha de base (baseline): o mínimo que qualquer modelo precisa superar pra ter algum mérito. Calcule sempre a linha de base primeiro.
No mundo real a armadilha é pior. Em fraude de cartão, 99,9% das compras são legítimas, e o modelo que diz “nunca é fraude” tem 99,9% de acurácia sem servir pra nada. A aula 01.08 mostra métricas melhores que a acurácia pra esses casos.
6. O padrão do scikit-learn: fit e predict
Todo modelo do scikit-learn tem os mesmos dois métodos: fit(X, y) treina e predict(X) prevê. É como se todos implementassem a mesma interface:
interface Modelo {
  fit(X: number[][], y: number[]): this;     // treinar: ajusta os parâmetros olhando X e y
  predict(X: number[][]): number[];          // prever: aplica o modelo treinado
}
Trocar de modelo é trocar uma linha. Aqui vai uma árvore de decisão, por enquanto como caixa-preta. Ela aprende exatamente o tipo de regra que você escreveu à mão: uma sequência de ifs com limites.
from sklearn.tree import DecisionTreeClassifier

modelo = DecisionTreeClassifier(random_state=0)   # random_state = seed, pra dar sempre o mesmo resultado
modelo.fit(X, y)                                  # treinar
previsto = modelo.predict(X)                      # prever
print("acurácia:", np.mean(previsto == y))

flor_nova = np.array([[5.0, 3.4, 1.5, 0.2]])      # uma flor que não está na base
print("flor nova:", iris.target_names[modelo.predict(flor_nova)])
acurácia: 1.0
flor nova: ['setosa']100% de acurácia! Mas desconfie: medimos nas mesmas flores que o modelo usou pra treinar. É como corrigir a prova com as mesmas questões que o aluno decorou. Pra saber se um modelo funciona com dados novos, é preciso testar em exemplos que ele nunca viu. A aula 01.07 trata disso.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")


def confere_acuracia(previsto, real, minimo):
    if previsto is None:
        print("⏳ ainda não implementado")
        return
    acuracia = np.mean(np.asarray(previsto) == real)
    if acuracia >= minimo:
        print(f"✅ acurácia de {acuracia:.0%} (meta: pelo menos {minimo:.0%})")
    else:
        print(f"❌ acurácia de {acuracia:.0%}, a meta é pelo menos {minimo:.0%}")


_QUIZ = ["regressão", "classificação", "regressão", "classificação", "classificação"]

def confere_quiz(respostas):
    for (pergunta, resposta), certa in zip(respostas.items(), _QUIZ):
        if resposta is ...:
            print(f"⏳ {pergunta}")
        elif str(resposta).strip().lower().replace("ã", "a").replace("ç", "c") == certa.replace("ã", "a").replace("ç", "c"):
            print(f"✅ {pergunta}")
        else:
            print(f"❌ {pergunta}")
Exercício 1 · Separar X e y
Cada linha da tabela é uma casa, com as colunas área (m²), quartos, idade (anos) e preço (mil R$). Queremos prever o preço. Escreva separar_X (as três primeiras colunas) e separar_y (a última).
tabela = np.array([
    [ 80, 2, 10, 260],
    [120, 3,  5, 370],
    [ 55, 1, 30, 150],
    [150, 4, 12, 420],
])


def separar_X(tabela):
    ...  # seu código aqui


def separar_y(tabela):
    ...  # seu código aqui


confere(separar_X(tabela), [[80, 2, 10], [120, 3, 5], [55, 1, 30], [150, 4, 12]])
confere(separar_y(tabela), [260, 370, 150, 420])
Dica
É o fatiamento 2D da aula 00.02: tabela[linhas, colunas].
Gabarito
def separar_X(tabela):
    return tabela[:, :3]    # todas as linhas, colunas 0, 1 e 2

def separar_y(tabela):
    return tabela[:, 3]     # todas as linhas, coluna 3
Exercício 2 · Regressão ou classificação?
Troque cada ... por "regressão" ou "classificação".
respostas = {
    "prever a temperatura de amanhã (em °C)": ...,
    "dizer se uma compra no cartão é fraude ou não": ...,
    "estimar quantos minutos um pedido de delivery vai demorar": ...,
    "reconhecer qual dígito (0 a 9) está escrito numa imagem": ...,
    "dizer qual objeto está na frente da webcam (pessoa, xícara, celular...)": ...,
}

confere_quiz(respostas)
Dica
Pergunte: errar por pouco é melhor que errar por muito? Se a resposta é 21 °C, prever 20 °C é quase certo. Mas se o dígito é 7, dizer 8 é tão errado quanto dizer 1.
Gabarito
respostas = {
    "prever a temperatura de amanhã (em °C)": "regressão",
    "dizer se uma compra no cartão é fraude ou não": "classificação",
    "estimar quantos minutos um pedido de delivery vai demorar": "regressão",
    "reconhecer qual dígito (0 a 9) está escrito numa imagem": "classificação",
    "dizer qual objeto está na frente da webcam (pessoa, xícara, celular...)": "classificação",
}
O dígito é a pegadinha: ele é um número, mas funciona como categoria. O último item é o que um detector como o YOLO faz (junto com dizer onde está o objeto).
Exercício 3 · Versicolor ou virginica?
Agora a parte difícil: separar versicolor (1) de virginica (2), que se misturam um pouco. Olhe o gráfico, invente uma regra e escreva minha_regra(petalas), que devolve 1 ou 2 pra cada flor. petalas tem duas colunas: o comprimento e a largura da pétala.
Meta: pelo menos 90% de acurácia.
duas = y > 0                         # só versicolor (1) e virginica (2)
petalas = X[duas][:, 2:4]            # colunas: comprimento e largura da pétala
especie = y[duas]

fig, ax = plt.subplots(figsize=(6, 4.5))
for e, cor, marcador in [(1, LARANJA, "s"), (2, VERDE, "^")]:
    mascara = especie == e
    ax.scatter(petalas[mascara, 0], petalas[mascara, 1], color=cor, marker=marcador, alpha=0.8,
               label=iris.target_names[e])
ax.set_title("Versicolor × virginica")
ax.set_xlabel("comprimento da pétala (cm)")
ax.set_ylabel("largura da pétala (cm)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()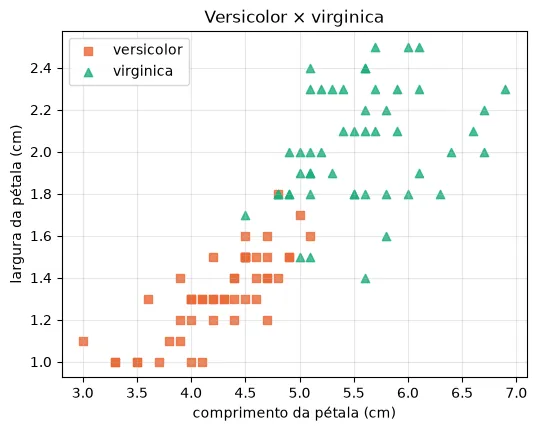
def minha_regra(petalas):
    ...  # seu código aqui


confere_acuracia(minha_regra(petalas), especie, minimo=0.9)
Dica
Procure uma linha horizontal ou vertical que deixe quase todos os quadrados de um lado e quase todos os triângulos do outro. Depois é um np.where, como na seção 4.
Gabarito
Uma regra possível (94%):
def minha_regra(petalas):
    largura = petalas[:, 1]
    return np.where(largura < 1.75, 1, 2)
Cortar pelo comprimento, em 4,8 cm, também passa da meta. Nenhuma regra acerta 100%, porque algumas flores das duas espécies ficam no mesmo lugar do gráfico.
Exercício 4 · A linha de base
Escreva acuracia_modelo_burro(y): a acurácia de um modelo que chuta sempre a classe que mais aparece em y.
def acuracia_modelo_burro(y):
    ...  # seu código aqui


confere(acuracia_modelo_burro(np.array([0, 0, 0, 1, 2])), 0.6)
confere(acuracia_modelo_burro(eh_setosa), 2 / 3)
confere(acuracia_modelo_burro(y), 1 / 3)
Dica
O np.bincount (seção 2) conta cada classe, e o argmax (aula 00.02) diz qual contagem é a maior.
Gabarito
def acuracia_modelo_burro(y):
    mais_comum = np.bincount(y).argmax()    # a classe que mais aparece
    return np.mean(y == mais_comum)         # a acurácia de chutar sempre ela
Repare no último teste: na íris completa, com 3 espécies de 50 flores, o modelo burro acerta só 33%. Qualquer regra que passe bem disso está aprendendo alguma coisa.
Exercício 5 (desafio) · Você contra a árvore
Junte as regras da seção 4 e do exercício 3 numa só: regra_tres_especies(petalas), que devolve 0, 1 ou 2 pra todas as 150 flores. petalas tem as mesmas duas colunas de antes.
Meta: pelo menos 95%. Depois, rode a célula seguinte pra comparar com uma árvore de decisão.
def regra_tres_especies(petalas):
    ...  # seu código aqui


confere_acuracia(regra_tres_especies(X[:, 2:4]), y, minimo=0.95)
from sklearn.tree import export_text
arvore = DecisionTreeClassifier(max_depth=2, random_state=0) # no máximo 2 "if"s em sequência
arvore.fit(X[:, 2:4], y)
print("acurácia da árvore:", np.mean(arvore.predict(X[:, 2:4]) == y))
print()
print(export_text(arvore, feature_names=iris.feature_names[2:4])) # as regras que ela aprendeuacurácia da árvore: 0.96
|--- petal width (cm) <= 0.80
| |--- class: 0
|--- petal width (cm) > 0.80
| |--- petal width (cm) <= 1.75
| | |--- class: 1
| |--- petal width (cm) > 1.75
| | |--- class: 2Dica
Dá pra colocar um np.where dentro do outro: “se for setosa, 0; senão, (se for versicolor, 1; senão, 2)”.
Gabarito
def regra_tres_especies(petalas):
    comprimento, largura = petalas[:, 0], petalas[:, 1]
    return np.where(comprimento < 2.5, 0, np.where(largura < 1.75, 1, 2))
A árvore chega a 96%, o mesmo que essa regra, e com praticamente as mesmas decisões. Pra setosa ela cortou pela largura (0,8 cm) em vez do comprimento, mas as duas separam perfeitamente. Pra versicolor × virginica, ela escolheu o mesmo corte de 1,75 cm. A diferença é que a árvore achou tudo isso sozinha, olhando só X e y.
Resumo
| Conceito | O que é |
|---|---|
| modelo | uma função com parâmetros |
| treinar (aprender) | ajustar os parâmetros pra errar pouco nos exemplos |
| exemplo, feature | uma linha, uma coluna de X |
X |
a tabela das features, formato (n, d) |
y (rótulo, alvo) |
a resposta de cada exemplo |
| regressão | o y é um número |
| classificação | o y é uma categoria |
| supervisionado | os exemplos têm y |
| não supervisionado | só existe X; o objetivo é achar estrutura |
| linha de base | o modelo burro que todo modelo precisa superar |
fit / predict |
treinar / prever, em qualquer modelo do scikit-learn |