Aula 6 de 13
k-means (agrupamento)
Objetivo: entender e implementar o k-means, o algoritmo clássico pra achar grupos em dados sem rótulo.
Por que isso importa: nem todo dado vem com a resposta certa ao lado. Agrupar é o primeiro passo pra entender um conjunto de dados novo: tipos de cliente, documentos parecidos, as cores principais de uma imagem. E o k-means só usa coisas que você já sabe: distância (aula 00.04), média (00.06) e vetorização (00.02).
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
CORES = [AZUL, LARANJA, VERDE]
MARCADORES = ["o", "s", "^"]      # marcador diferente por grupo, além da cor
1. O problema: dados sem rótulo
Até agora, todo problema tinha um X (as features) e um y (a resposta certa). Aqui só existe o X: 120 pontos com duas features, e ninguém disse a que grupo cada um pertence.
def gerar_grupos(seed=1):
    rng = np.random.default_rng(seed)
    centros_reais = np.array([[0, 0], [4, 1], [1, 4]])
    return np.vstack([c + rng.normal(0, 0.7, size=(40, 2)) for c in centros_reais])   # 3 grupos de 40 pontos, empilhados


pontos = gerar_grupos()
print(pontos.shape)

fig, ax = plt.subplots(figsize=(5, 5))
ax.scatter(pontos[:, 0], pontos[:, 1], color="gray", alpha=0.7)
ax.set_title("120 pontos, sem rótulo")
ax.set_xlabel("x₁")
ax.set_ylabel("x₂")
ax.set_aspect("equal")
ax.grid(alpha=0.3)
plt.show()
(120, 2)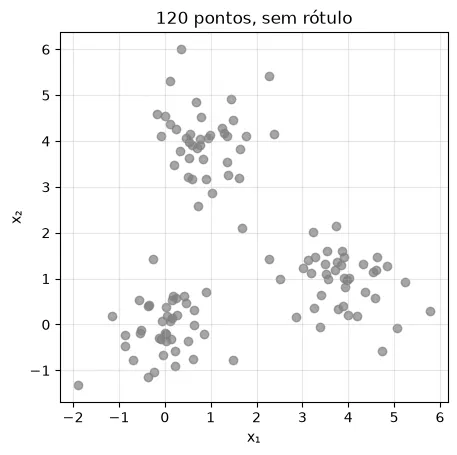
A olho, dá pra ver 3 grupos. Mas com 50 features não dá pra desenhar, e “a olho” não escala. Queremos um algoritmo que ache os grupos sozinho.
Tem y? |
Exemplo | |
|---|---|---|
| supervisionado | sim | prever o preço (01.02), a espécie da íris (01.01) |
| não supervisionado | não | achar grupos de clientes parecidos, esta aula |
2. O algoritmo, passo a passo
O k-means representa cada grupo por um centro, que é um ponto. Você escolhe quantos grupos quer (o k), e ele alterna dois passos:
- Atribuir: cada ponto vai pro grupo do centro mais próximo, usando a distância da aula 00.04.
- Atualizar: cada centro vai pra média dos pontos do seu grupo, como na aula 00.06.
E repete até nada mudar. Em TS:
let centros = sortearKPontos(pontos, k);
while (true) {
  // 1) atribuir: o índice do centro mais perto de cada ponto
  const grupos = pontos.map(p => indiceDoMenor(centros.map(c => distancia2(p, c))));
  // 2) atualizar: cada centro vai pra média dos pontos do seu grupo
  const novos = centros.map((_, j) => media(pontos.filter((_, i) => grupos[i] === j)));
  if (iguais(novos, centros)) break;   // nada mudou: terminou
  centros = novos;
}
O distancia2 é a distância ao quadrado, sem a raiz. Quem está mais perto continua mais perto, e a conta fica mais barata.
A mesma coisa em Python, com laços, do jeito mais direto:
def passo_direto(pontos, centros):
    # um passo do k-means, com laços, igualzinho ao TS acima
    grupos = []
    for p in pontos:                                                 # 1) atribuir
        distancias = [np.sum((p - c) ** 2) for c in centros]
        grupos.append(int(np.argmin(distancias)))
    grupos = np.array(grupos)
    novos = np.array([pontos[grupos == j].mean(axis=0) for j in range(len(centros))])   # 2) atualizar
    return grupos, novos
O pontos[grupos == j] é a máscara da aula 00.02: “os pontos do grupo j”. Agora vamos rodar a partir de 3 pontos sorteados e guardar cada passo pra desenhar:
rng = np.random.default_rng(10)
centros = pontos[rng.choice(len(pontos), size=3, replace=False)]    # sorteia 3 pontos pra começar

passos = []                                 # guarda (centros usados, grupos) de cada passo
while True:
    grupos, novos = passo_direto(pontos, centros)
    passos.append((centros, grupos))
    if np.allclose(novos, centros):         # os centros não se mexeram: terminou
        break
    centros = novos
print(f"parou depois de {len(passos)} passos")

mostrar = [0, 1, 2, len(passos) - 1]
fig, axs = plt.subplots(1, 4, figsize=(16, 4.4), sharex=True, sharey=True)
for ax, i in zip(axs, mostrar):
    centros_i, grupos_i = passos[i]
    for j in range(3):
        pts = pontos[grupos_i == j]
        ax.scatter(pts[:, 0], pts[:, 1], color=CORES[j], marker=MARCADORES[j], alpha=0.6, label=f"grupo {j}")
    trilha = np.array([c for c, _ in passos[: i + 1]])   # (passos, 3, 2): por onde cada centro já passou
    for j in range(3):
        ax.plot(trilha[:, j, 0], trilha[:, j, 1], color="black", linestyle=":", linewidth=1)
    ax.scatter(centros_i[:, 0], centros_i[:, 1], color="black", marker="X", s=150, label="centros")
    ax.set_title(f"passo {i + 1}" + (": centros sorteados" if i == 0 else ": nada mudou, parou" if i == len(passos) - 1 else ""))
    ax.set_xlabel("x₁")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("x₂")
axs[0].legend(loc="upper right", fontsize=8)
fig.tight_layout()
plt.show()
parou depois de 7 passos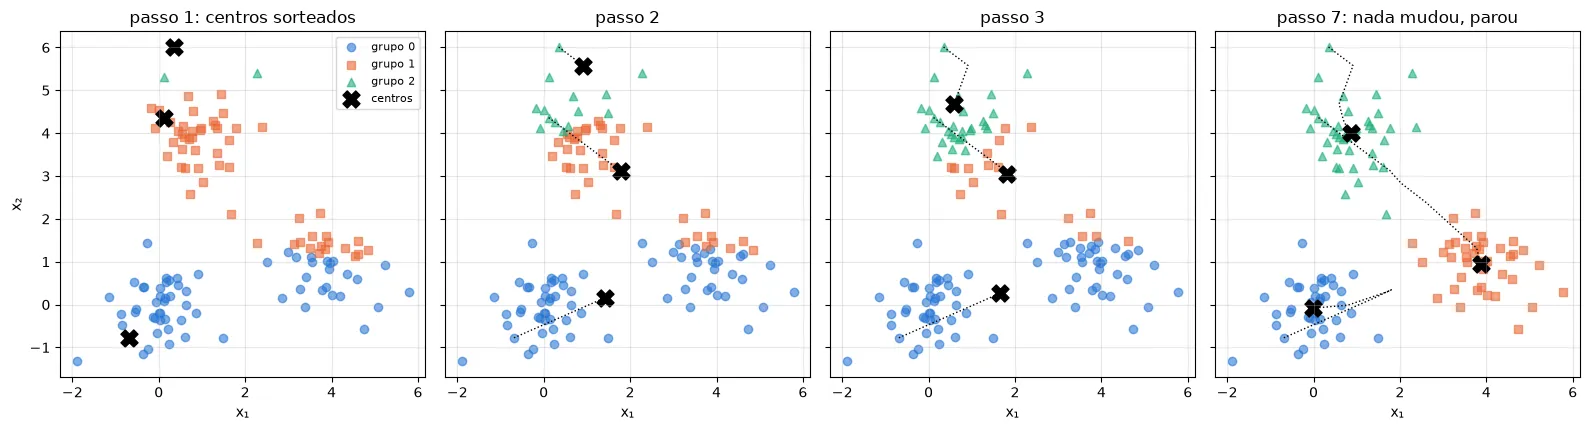
O pontilhado é o caminho de cada centro. No começo os grupos estão errados, mas cada passo melhora um pouco: os centros “escorregam” pro meio dos seus pontos, e os pontos trocam de grupo conforme os centros se mexem.
3. k-means do zero, vetorizado
O problema: o passo_direto faz um laço por ponto. Na seção 6 vamos agrupar dezenas de milhares de pixels, e o laço do Python fica lento (aula 00.02). O que precisamos é de uma tabela de distâncias, com uma linha por ponto e uma coluna por centro:
pontos  = [[0, 0], [1, 0], [5, 5]]       centros = [[0, 0], [5, 5]]

                  centro 0   centro 1
ponto [0, 0]          0         50
ponto [1, 0]          1         41
ponto [5, 5]         50          0
(São distâncias ao quadrado. Por exemplo, de [1, 0] até [5, 5]: 4² + 5² = 41.) O grupo de cada ponto é a coluna do menor valor da linha, o argmin(axis=1): [0, 0, 1].
Pra montar essa tabela sem laço, use broadcasting (aula 00.02) com um eixo novo:
| Expressão | Formato | O que é |
|---|---|---|
pontos[:, None, :] |
(3, 1, 2) | cada ponto na sua “linha” |
centros[None, :, :] |
(1, 2, 2) | os centros nas “colunas” |
| a diferença dos dois | (3, 2, 2) | ponto − centro, pra todo par |
(dif ** 2).sum(axis=2) |
(3, 2) | a tabela de distâncias² |
O None no índice quer dizer “crie aqui um eixo de tamanho 1”. É o mesmo que um reshape, só que no lugar. Pela regra da aula 00.02 (comparar da direita pra esquerda), (3, 1, 2) e (1, 2, 2) viram (3, 2, 2). É a tabuada da aula 00.02, com uma dimensão a mais.
p = np.array([[0, 0], [1, 0], [5, 5]])
c = np.array([[0, 0], [5, 5]])

dif = p[:, None, :] - c[None, :, :]
print(dif.shape)

distancias2 = (dif ** 2).sum(axis=2)
print(distancias2)
print(distancias2.argmin(axis=1))
(3, 2, 2)
[[ 0 50]
[ 1 41]
[50 0]]
[0 0 1]O passo de atualizar tem um laço sobre os k grupos. Não tem problema: k é pequeno (3). O laço que queremos evitar é o que passa por cada ponto.
Juntando tudo, com o mesmo sorteio inicial da seção 2:
k = 3
rng = np.random.default_rng(10)
centros = pontos[rng.choice(len(pontos), size=k, replace=False)]
grupos_antes = np.full(len(pontos), -1)            # nenhum grupo ainda

for passo in range(1, 101):
    distancias2 = ((pontos[:, None, :] - centros[None, :, :]) ** 2).sum(axis=2)   # (120, 3)
    grupos = distancias2.argmin(axis=1)                                            # 1) atribuir
    novos = np.array([pontos[grupos == j].mean(axis=0) for j in range(k)])         # 2) atualizar
    print(f"passo {passo}: {np.sum(grupos != grupos_antes)} pontos mudaram de grupo")
    if np.allclose(novos, centros):
        break
    centros, grupos_antes = novos, grupos

print(centros.round(3))
passo 1: 120 pontos mudaram de grupo
passo 2: 18 pontos mudaram de grupo
passo 3: 19 pontos mudaram de grupo
passo 4: 7 pontos mudaram de grupo
passo 5: 27 pontos mudaram de grupo
passo 6: 13 pontos mudaram de grupo
passo 7: 0 pontos mudaram de grupo
[[-0.017 -0.084]
[ 3.87 0.953]
[ 0.873 3.995]]Com o scikit-learn
O scikit-learn tem o k-means pronto. Repare que o fit recebe só o X: não existe y.
from sklearn.cluster import KMeans

km = KMeans(n_clusters=3, n_init=10, random_state=0)
km.fit(pontos)

print(km.cluster_centers_.round(3))    # os centros
print(km.labels_[:12])                 # o grupo de cada ponto (os 12 primeiros)
[[ 3.87 0.953]
[ 0.873 3.995]
[-0.017 -0.084]]
[2 2 2 2 2 2 2 2 2 2 2 2]Os centros são os mesmos que os nossos, mas talvez em outra ordem. A numeração dos grupos é arbitrária: o “grupo 0” de um pode ser o “grupo 2” do outro. Pra comparar, ordenamos os centros pela primeira coordenada:
ordem_nossa = np.argsort(centros[:, 0])
ordem_sklearn = np.argsort(km.cluster_centers_[:, 0])
print(np.allclose(centros[ordem_nossa], km.cluster_centers_[ordem_sklearn]))True4. Os problemas do k-means
O começo importa
O resultado depende dos centros sorteados no início. Veja dois sorteios diferentes, com uma única rodada cada (n_init=1) e começo aleatório (init="random"):
fig, axs = plt.subplots(1, 2, figsize=(10, 4.6), sharex=True, sharey=True)
for ax, seed in zip(axs, [0, 14]):
    modelo = KMeans(n_clusters=3, init="random", n_init=1, random_state=seed).fit(pontos)
    for j in range(3):
        pts = pontos[modelo.labels_ == j]
        ax.scatter(pts[:, 0], pts[:, 1], color=CORES[j], marker=MARCADORES[j], alpha=0.6, label=f"grupo {j}")
    ax.scatter(modelo.cluster_centers_[:, 0], modelo.cluster_centers_[:, 1], color="black", marker="X", s=150, label="centros")
    ax.set_title(f"sorteio {seed}: inércia = {modelo.inertia_:.0f}")
    ax.set_xlabel("x₁")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("x₂")
axs[0].legend(loc="upper right", fontsize=8)
fig.tight_layout()
plt.show()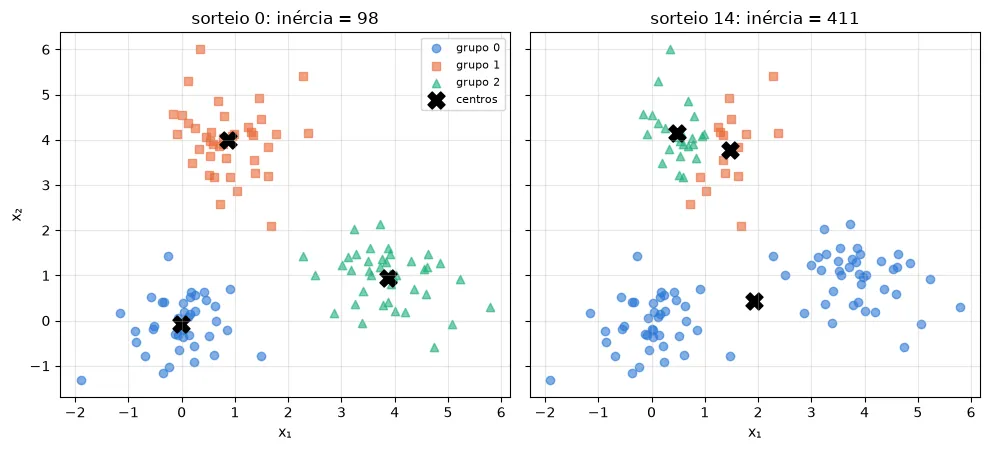
No sorteio 14, dois centros dividiram um grupo e um centro ficou com dois grupos. O k-means “empacou”: cada passo só melhora localmente, e daqui nenhum passo melhora. É um mínimo local, igual a uma bolinha presa no vale errado de um terreno com mais de um vale (aulas 00.05 e 01.03). A inércia (seção 5) mede o quanto os pontos ficam longe dos seus centros: 98 no sorteio bom, 411 no ruim.
A solução é rodar várias vezes com sorteios diferentes e ficar com a de menor inércia. É o n_init. O scikit-learn também sorteia os centros de um jeito mais esperto por padrão, o k-means++, que prefere começar com centros longe uns dos outros.
melhor = km.inertia_
ruins_1 = sum(KMeans(n_clusters=3, init="random", n_init=1, random_state=s).fit(pontos).inertia_ > 1.05 * melhor for s in range(50))
ruins_10 = sum(KMeans(n_clusters=3, init="random", n_init=10, random_state=s).fit(pontos).inertia_ > 1.05 * melhor for s in range(50))

print(f"1 rodada:   {ruins_1} de 50 sorteios caíram num mínimo local")   # True vale 1, então sum() conta
print(f"10 rodadas: {ruins_10} de 50")
1 rodada: 4 de 50 sorteios caíram num mínimo local
10 rodadas: 0 de 50Ele só enxerga grupos “redondos”
O k-means decide pela distância até o centro. Por isso, a fronteira entre dois grupos é sempre uma reta, no meio do caminho entre os dois centros. Grupos com outros formatos quebram a ideia:
from sklearn.datasets import make_moons

X_luas, y_luas = make_moons(n_samples=200, noise=0.06, random_state=0)
grupos_luas = KMeans(n_clusters=2, n_init=10, random_state=0).fit(X_luas).labels_

fig, axs = plt.subplots(1, 2, figsize=(10, 4), sharex=True, sharey=True)
for ax, rotulos, titulo in zip(axs, [y_luas, grupos_luas], ["os grupos de verdade", "o que o k-means achou"]):
    for j in range(2):
        pts = X_luas[rotulos == j]
        ax.scatter(pts[:, 0], pts[:, 1], color=CORES[j], marker=MARCADORES[j], alpha=0.7, label=f"grupo {j}")
    ax.set_title(titulo)
    ax.set_xlabel("x₁")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("x₂")
axs[0].legend(loc="lower left", fontsize=8)
fig.tight_layout()
plt.show()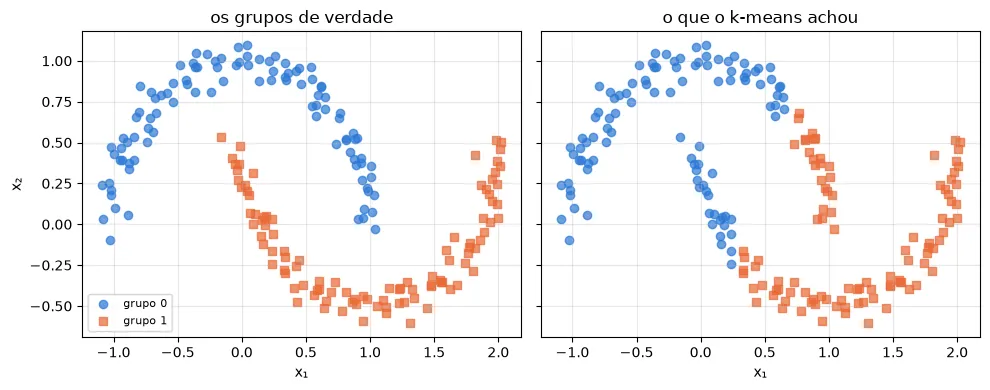
As duas “luas” se encaixam uma na outra, e nenhuma reta separa as duas. Pra formatos assim existem outros algoritmos de agrupamento, como o DBSCAN e o agrupamento espectral, que também estão no scikit-learn.
5. Qual k escolher?
O problema: o k-means acha k grupos, mas quem escolhe o k é você. Pra comparar escolhas, usamos a inércia: a soma das distâncias ao quadrado de cada ponto até o centro do seu grupo.
onde é o centro do grupo do ponto . Só que mais grupos sempre diminuem a inércia: com k igual ao número de pontos, cada ponto vira o próprio centro e a inércia é zero. Então não dá pra só minimizar. O truque é procurar o cotovelo, o ponto em que acrescentar um grupo deixa de ajudar muito:
ks = range(1, 9)
inercias = [KMeans(n_clusters=k, n_init=10, random_state=0).fit(pontos).inertia_ for k in ks]

fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(ks, inercias, color=AZUL, marker="o")
ax.annotate("cotovelo", xy=(3, inercias[2]), xytext=(4.5, inercias[1]),
            arrowprops={"arrowstyle": "->", "color": "#222222"}, color="#222222")
ax.set_title("Inércia × número de grupos")
ax.set_xlabel("k")
ax.set_ylabel("inércia")
ax.grid(alpha=0.3)
plt.show()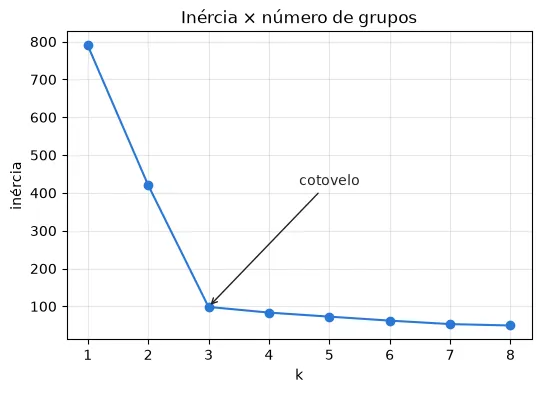
De 1 pra 2 e de 2 pra 3 grupos a inércia despenca. Depois de 3, cai pouco. Isso bate com os 3 grupos que dá pra ver.
Cuidado: o cotovelo é uma heurística. Com dados reais ele muitas vezes não é nítido, e a escolha acaba dependendo do uso: se os grupos viram tamanhos de camiseta, talvez você queira 5 porque a fábrica faz 5. Existem outras medidas, como a silhueta, mas nenhuma é mágica.
6. Aplicação: reduzir as cores de uma imagem
O problema: uma foto tem dezenas de milhares de cores diferentes. E se quisermos representar a foto com só k cores, como os GIFs antigos ou uma paleta de pôster?
Cada pixel é um ponto em 3D, (R, G, B). O k-means junta as cores parecidas em k grupos, e depois cada pixel é trocado pela cor do centro do seu grupo.
A foto é a mesma da aula 00.02: china.jpg, de danielbuechele, licença CC BY 2.0, distribuída com o scikit-learn.
from pathlib import Path
import cv2
import sklearn.datasets

# __file__ é onde o módulo está instalado; as fotos de exemplo ficam na pasta images, ao lado dele
CAMINHO_FOTO = Path(sklearn.datasets.__file__).parent / "images" / "china.jpg"
foto = cv2.imread(str(CAMINHO_FOTO))
assert foto is not None, f"não achei a imagem em {CAMINHO_FOTO}"
foto = foto[:, :, ::-1]                       # BGR -> RGB (aula 00.02)

imagem = foto[::4, ::4]                     # 1 pixel a cada 4, em cada direção: 16x menos pixels
pixels = imagem.reshape(-1, 3).astype(float)  # (altura, largura, 3) -> (altura × largura, 3): uma linha por pixel

print(imagem.shape, "->", pixels.shape)
print("cores diferentes:", len(np.unique(pixels, axis=0)))
(107, 160, 3) -> (17120, 3)
cores diferentes: 11033Pra ficar rápido, o k-means aprende as cores numa amostra de 5.000 pixels. Depois, o predict diz a qual grupo cada um dos pixels pertence.
Pra reconstruir a imagem, centros[grupos] troca cada índice pela cor do centro dele. É uma tabela de consulta, como grupos.map(g => centros[g]) em TS.
rng = np.random.default_rng(0)
amostra = pixels[rng.choice(len(pixels), size=5000, replace=False)]

fig, axs = plt.subplots(1, 4, figsize=(16, 5.6))
axs[0].imshow(imagem)
axs[0].set_title(f"original: {len(np.unique(pixels, axis=0))} cores")

for ax, k in zip(axs[1:], [4, 8, 16]):
    modelo = KMeans(n_clusters=k, n_init=4, random_state=0).fit(amostra)
    grupos = modelo.predict(pixels)
    reconstruida = modelo.cluster_centers_[grupos].reshape(imagem.shape).astype(np.uint8)
    ax.imshow(reconstruida)
    ax.set_title(f"k = {k} cores")

for ax in axs:
    ax.axis("off")
fig.tight_layout()
plt.show()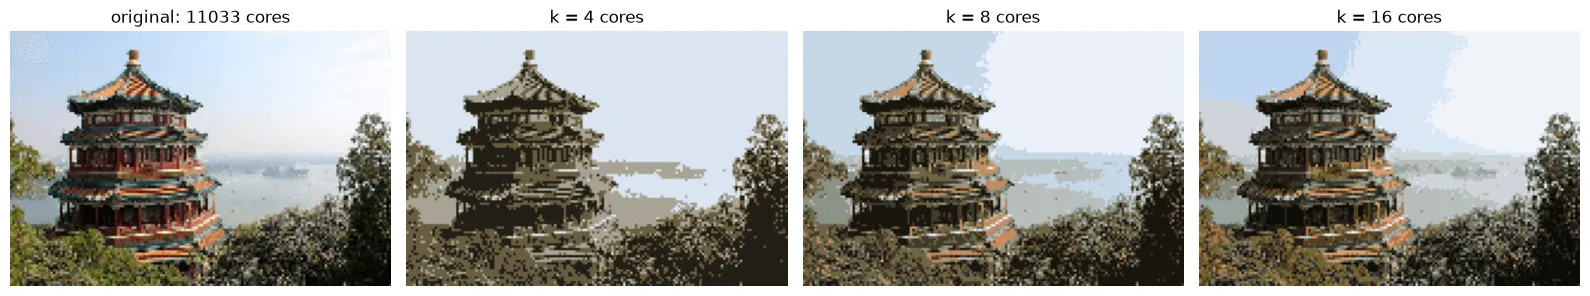
Com 16 cores já fica parecido com a original, e com 4 vira um pôster. Repare que, com 4 cores, o vermelho e o laranja do templo somem: eles ocupam poucos pixels perto do céu, do lago e das árvores escuras, então não ganham um grupo só pra eles. O k-means gasta os centros onde há mais pontos. É compressão com perda: cada pixel da original precisa de 24 bits (3 cores × 8 bits), e com 16 cores basta um índice de 4 bits por pixel (2⁴ = 16), mais a tabela das 16 cores. É uns 6x menos.
Exercícios
Código de apoio dos exercícios
from sklearn.metrics import adjusted_rand_score


def confere(obtido, esperado, tolerancia=1e-6):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido, dtype=float), np.asarray(esperado, dtype=float)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado, rtol=tolerancia, atol=tolerancia):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")


def ordenar_centros(centros):
    # ordena os centros pela 1ª coordenada (e, no empate, pela 2ª), pra comparar sem depender da numeração
    centros = np.asarray(centros)
    return centros[np.lexsort(centros.T[::-1])]


def confere_grupos(obtido, esperado):
    # [0, 0, 1] e [1, 1, 0] são o MESMO agrupamento: só a numeração muda
    if obtido is None:
        print("⏳ ainda não implementado")
    elif adjusted_rand_score(esperado, obtido) > 0.999:
        print("✅ mesmos grupos (a numeração pode ser diferente)")
    else:
        print("❌ os grupos não batem")


def confere_imagem(resultado, original, k, erro_maximo):
    if resultado is None:
        print("⏳ ainda não implementado")
        return
    resultado = np.asarray(resultado)
    n_cores = len(np.unique(resultado.reshape(-1, 3), axis=0))
    erro = np.abs(resultado.astype(int) - original.astype(int)).mean()
    itens = {
        f"mesmo formato da original {original.shape}": resultado.shape == original.shape,
        "tipo uint8 (o tipo de imagem)": resultado.dtype == np.uint8,
        f"no máximo {k} cores (tem {n_cores})": n_cores <= k,
        f"erro médio por pixel {erro:.1f} (limite {erro_maximo})": erro <= erro_maximo,
    }
    for descricao, ok in itens.items():
        print(("✅ " if ok else "❌ ") + descricao)


referencia = KMeans(n_clusters=3, n_init=10, random_state=0).fit(pontos)   # a resposta de referência pros testes
Exercício 1 · Atribuir
Escreva atribuir(pontos, centros), que devolve, pra cada ponto, o índice do centro mais próximo, sem laço. Tem que funcionar pra qualquer número de dimensões: o segundo teste usa cores (R, G, B).
def atribuir(pontos, centros):
    ...  # seu código aqui


confere(atribuir(np.array([[0, 0], [1, 0], [5, 5], [6, 5], [0, 6]]),
                 np.array([[0, 0], [5, 5], [0, 5]])),
        [0, 0, 1, 1, 2])
confere(atribuir(np.array([[255, 0, 0], [250, 10, 5], [0, 0, 255]]),       # dois vermelhos e um azul
                 np.array([[0, 0, 250], [255, 0, 0]])),                      # centro 0 = azul, centro 1 = vermelho
        [1, 1, 0])
Dica
É a tabela de distâncias² da seção 3, com None e broadcasting. Depois, argmin em qual eixo?
Gabarito
def atribuir(pontos, centros):
    distancias2 = ((pontos[:, None, :] - centros[None, :, :]) ** 2).sum(axis=2)   # (n, k)
    return distancias2.argmin(axis=1)
Exercício 2 · Atualizar os centros
Escreva atualizar_centros(pontos, grupos, k), que devolve os k novos centros, cada um sendo a média dos pontos do seu grupo, no formato (k, dimensões). Nos testes, nenhum grupo fica vazio.
def atualizar_centros(pontos, grupos, k):
    ...  # seu código aqui


confere(atualizar_centros(np.array([[0, 0], [2, 0], [5, 5], [7, 5], [0, 6]]),
                          np.array([0, 0, 1, 1, 2]), 3),
        [[1, 0], [6, 5], [0, 6]])
Dica
Um laço sobre os k grupos (tudo bem, k é pequeno) com a máscara pontos[grupos == j] e .mean(axis=0).
Gabarito
def atualizar_centros(pontos, grupos, k):
    return np.array([pontos[grupos == j].mean(axis=0) for j in range(k)])
Se um grupo ficasse vazio, a média de nada daria nan. O KMeans do scikit-learn trata esse caso, realocando o centro.
Exercício 3 · Inércia
Escreva inercia(pontos, centros, grupos): a soma das distâncias ao quadrado de cada ponto até o centro do seu grupo, sem laço. O segundo teste compara com o inertia_ do scikit-learn.
def inercia(pontos, centros, grupos):
    ...  # seu código aqui


confere(inercia(np.array([[0, 0], [2, 0], [5, 5], [7, 5], [0, 6]]),
                np.array([[1, 0], [6, 5], [0, 6]]),
                np.array([0, 0, 1, 1, 2])),
        4)
confere(inercia(pontos, referencia.cluster_centers_, referencia.labels_), referencia.inertia_)
Dica
centros[grupos] dá, pra cada ponto, o centro do seu grupo, com o mesmo formato de pontos (a tabela de consulta da seção 6). Depois é diferença, quadrado e soma.
Gabarito
def inercia(pontos, centros, grupos):
    return ((pontos - centros[grupos]) ** 2).sum()
Exercício 4 · O k-means completo
Junte as suas funções em kmeans(pontos, k, seed=0, max_iter=100), que devolve (centros, grupos). Pra conferência bater, comece exatamente assim:
rng = np.random.default_rng(seed)
centros = pontos[rng.choice(len(pontos), size=k, replace=False)]
Depois, alterne atribuir e atualizar até os centros pararem de mudar (np.allclose) ou até max_iter passos.
O último teste usa a seed 6, que cai no mínimo local da seção 4. A sua implementação tem que reproduzir isso.
def kmeans(pontos, k, seed=0, max_iter=100):
    ...  # seu código aqui


resultado = kmeans(pontos, 3, seed=0)
if resultado is None:
    print("⏳ ainda não implementado")
else:
    centros_obtidos, grupos_obtidos = resultado
    confere(ordenar_centros(centros_obtidos), ordenar_centros(referencia.cluster_centers_))
    confere_grupos(grupos_obtidos, referencia.labels_)

    centros_6, grupos_6 = kmeans(pontos, 3, seed=6)
    confere(inercia(pontos, centros_6, grupos_6), 431.1213, tolerancia=1e-4)
Dica
Siga o TS da seção 2, trocando as partes pelas suas funções atribuir e atualizar_centros. Pra parar: if np.allclose(novos, centros): break.
Gabarito
def kmeans(pontos, k, seed=0, max_iter=100):
    rng = np.random.default_rng(seed)
    centros = pontos[rng.choice(len(pontos), size=k, replace=False)]
    for _ in range(max_iter):          # "_" = variável que não vai ser usada
        grupos = atribuir(pontos, centros)
        novos = atualizar_centros(pontos, grupos, k)
        if np.allclose(novos, centros):
            break
        centros = novos
    return centros, grupos
Exercício 5 (desafio) · Compressão de cores com o seu k-means
Escreva comprimir_cores(imagem, k, seed=0) usando o seu kmeans. A função recebe uma imagem RGB (altura, largura, 3) e devolve a mesma imagem com no máximo k cores, no tipo np.uint8.
O teste usa a foto bem pequena (1 pixel a cada 8), pra rodar rápido mesmo sem amostragem.
def comprimir_cores(imagem, k, seed=0):
    ...  # seu código aqui


pequena = foto[::8, ::8]
comprimida = comprimir_cores(pequena, 8)
confere_imagem(comprimida, pequena, k=8, erro_maximo=15)

if comprimida is not None:
    fig, axs = plt.subplots(1, 2, figsize=(8, 5))
    for ax, img, titulo in zip(axs, [pequena, comprimida], ["original", "o seu k-means, k = 8"]):
        ax.imshow(img)
        ax.set_title(titulo)
        ax.axis("off")
    plt.show()
Dica
Três passos: reshape(-1, 3) pra virar uma tabela de pixels (em float), o seu kmeans, e centros[grupos] pra reconstruir (seção 6). No fim, .round().astype(np.uint8) e .reshape(imagem.shape).
Gabarito
def comprimir_cores(imagem, k, seed=0):
    pixels = imagem.reshape(-1, 3).astype(float)          # uma linha por pixel
    centros, grupos = kmeans(pixels, k, seed=seed)
    return centros[grupos].round().astype(np.uint8).reshape(imagem.shape)
Resumo
| Conceito | A ideia | Em código |
|---|---|---|
| não supervisionado | só X, sem y |
KMeans(n_clusters=k).fit(X) |
| atribuir | cada ponto vai pro centro mais próximo | distancias2.argmin(axis=1) |
| atualizar | cada centro vai pra média do seu grupo | pontos[grupos == j].mean(axis=0) |
| tabela de distâncias | broadcasting (n, 1, d) − (1, k, d) | ((p[:, None, :] - c[None, :, :]) ** 2).sum(axis=2) |
| mínimo local | o resultado depende do sorteio inicial | n_init=10 e k-means++ |
| escolher k | o cotovelo da inércia (uma heurística) | km.inertia_ |
| limitação | só acha grupos “redondos” | pra outros formatos: DBSCAN, agrupamento espectral |