Aula 7 de 13
Overfitting e a divisão em treino, validação e teste
Objetivo: entender por que acertar nos dados de treino não prova nada e como medir de verdade se um modelo aprendeu: separando os dados em treino, validação e teste, e usando validação cruzada.
Por que isso importa: este é o erro mais comum em ML. Todo número que você vai ver daqui pra frente, seja numa aula, num artigo ou num anúncio de modelo novo, só vale alguma coisa se foi medido em dados que o modelo nunca viu.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
1. O problema: decorar × aprender
Na aula 01.01, a árvore de decisão acertou 100% das flores. Só que ela foi avaliada nas mesmas flores que usou pra aprender.
É como avaliar um aluno com a mesma prova que ele usou pra estudar: quem decorou as respostas tira 10 sem ter aprendido a matéria. A única prova justa é uma prova nova.
Em ML, a prova nova são dados que o modelo nunca viu. Vamos esconder 30% das flores durante o treino e medir o acerto nelas, com dois conjuntos de medidas:
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split

iris = load_iris()

for nome, X_iris in [("pétalas e sépalas", iris.data), ("só as sépalas", iris.data[:, :2])]:
    # separa 30% das flores pra avaliar depois (a seção 3 explica esta linha)
    X_tr, X_te, y_tr, y_te = train_test_split(X_iris, iris.target, test_size=0.3, random_state=0)
    arvore = DecisionTreeClassifier(random_state=0).fit(X_tr, y_tr)
    # score = acurácia (a fração de acertos)
    print(f"{nome:18}  acerto no treino: {arvore.score(X_tr, y_tr):.0%}   acerto em flores novas: {arvore.score(X_te, y_te):.0%}")
pétalas e sépalas acerto no treino: 100% acerto em flores novas: 98%
só as sépalas acerto no treino: 94% acerto em flores novas: 64%- Com as 4 medidas, a árvore aprendeu de verdade: continua acertando quase tudo nas flores novas.
- Só com as sépalas, que se misturam bastante entre as espécies, ela decorou: criou regras tão específicas pras flores do treino que não servem pras outras.
Esse fenômeno se chama overfitting (sobreajuste). Repare que, olhando só o acerto no treino, os dois casos pareciam bons.
2. Underfitting × overfitting
O problema: temos 16 medições com ruído de uma curva e queremos um polinômio que as descreva. Qual grau usar?
Regressão polinomial é a regressão linear da aula 01.02 com colunas extras: além do 1 e do x, entram x², x³ e assim por diante.
| x | 1 | x | x² | x³ |
|---|---|---|---|---|
| 2 | 1 | 2 | 4 | 8 |
| 3 | 1 | 3 | 9 | 27 |
O np.polyfit(x, y, grau) monta essas colunas e resolve por mínimos quadrados, igual ao lstsq da 01.02. O np.polyval(coeficientes, x) calcula o polinômio nos pontos que você passar.
def f_verdadeira(x):
    return np.sin(2.5 * x)       # a regra que gerou os dados (na vida real, ninguém conhece)


rng = np.random.default_rng(seed=0)
x_poucos = np.linspace(-1, 1, 16)                                  # 16 medições, espaçadas por igual
y_poucos = f_verdadeira(x_poucos) + rng.normal(0, 0.25, size=16)   # com ruído de medição

x_curva = np.linspace(-1, 1, 400)    # pontos pra desenhar as curvas

fig, axs = plt.subplots(1, 3, figsize=(14, 4.2), sharey=True)
for ax, grau, titulo in zip(axs, [1, 3, 15], ["rígido demais", "na medida", "decorou"]):
    coef = np.polyfit(x_poucos, y_poucos, grau)
    mse_treino = np.mean((np.polyval(coef, x_poucos) - y_poucos) ** 2)
    ax.plot(x_curva, f_verdadeira(x_curva), color="gray", linestyle="--", label="regra verdadeira")
    ax.plot(x_curva, np.polyval(coef, x_curva), color=LARANJA, linewidth=2, label="polinômio")
    ax.scatter(x_poucos, y_poucos, color=AZUL, zorder=3, label="medições")
    ax.set_title(f"grau {grau}: {titulo}\nMSE no treino = {mse_treino:.3f}")
    ax.set_ylim(-2.5, 2.5)
    ax.set_xlabel("x")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("y")
axs[0].legend(loc="lower right")
plt.show()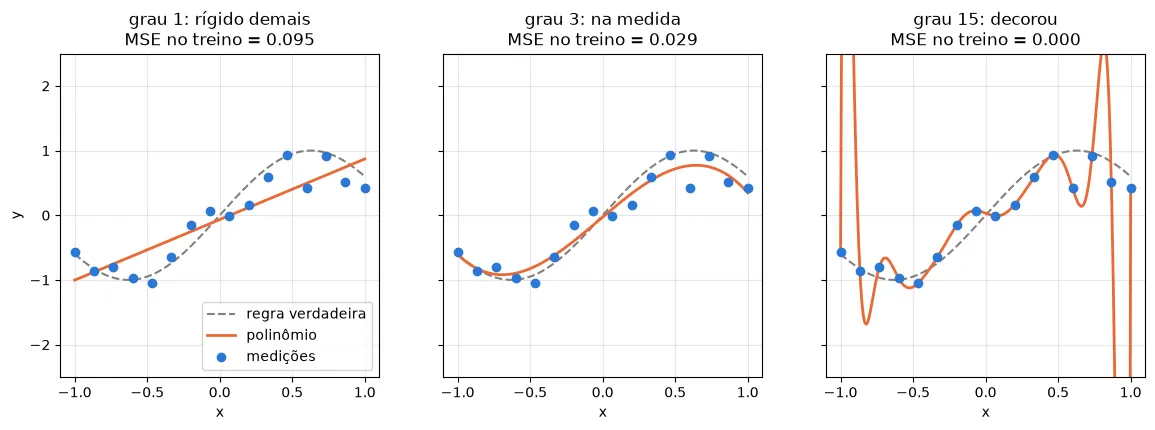
| Grau | No treino | Em dados novos | O que aconteceu |
|---|---|---|---|
| 1 | erra | erra | simples demais: nem segue os dados (underfitting) |
| 3 | erra um pouco | erra um pouco | pegou a tendência e ignorou o ruído |
| 15 | erro zero | erra muito | passou por todos os pontos, inclusive pelo ruído (overfitting) |
O grau 15 tem 16 coeficientes pra 16 pontos, então consegue passar exatamente por todos. O preço disso são as oscilações entre os pontos e perto das bordas, onde a curva chega a sair do gráfico. Ele aprendeu o ruído.
3. Separar treino e teste
O problema: pra saber qual grau funciona em dados novos, precisamos de dados novos.
A solução: antes de treinar, separar um pedaço dos dados (por exemplo, 30%) e não tocar nele até o fim. Esse pedaço é o conjunto de teste.
O train_test_split faz isso numa linha, mas não tem mágica: ele embaralha os índices e corta. Primeiro à mão, com 40 medições:
rng = np.random.default_rng(seed=1)
x = rng.uniform(-1, 1, size=40)                        # 40 medições, agora em posições aleatórias
y = f_verdadeira(x) + rng.normal(0, 0.25, size=40)

rng_divisao = np.random.default_rng(seed=0)
indices = rng_divisao.permutation(len(x))    # os números de 0 a 39, em ordem aleatória
n_teste = round(0.3 * len(x))                # 30% pro teste: 12
i_teste, i_treino = indices[:n_teste], indices[n_teste:]

print("índices do teste:", np.sort(i_teste))
print(len(i_treino), "no treino,", len(i_teste), "no teste")
índices do teste: [ 1 2 3 4 10 11 18 22 23 24 27 34]
28 no treino, 12 no testePor que embaralhar? Dados costumam vir em ordem: por data, por classe, por cliente. Na base Iris, por exemplo, as 50 últimas flores são todas virginica. Cortar sem embaralhar poderia deixar uma espécie inteira de fora do treino.
O rng.permutation é o embaralhamento de Fisher–Yates. Em TypeScript:
const indices = [...Array(40).keys()];              // [0, 1, ..., 39]
for (let i = indices.length - 1; i > 0; i--) {
  const j = Math.floor(Math.random() * (i + 1));    // sorteia uma posição de 0 a i
  [indices[i], indices[j]] = [indices[j], indices[i]];
}
const teste = indices.slice(0, 12);
const treino = indices.slice(12);
Com o scikit-learn:
from sklearn.model_selection import train_test_split

x_tr, x_te, y_tr, y_te = train_test_split(x, y, test_size=0.3, random_state=0)
print(len(x_tr), "no treino,", len(x_te), "no teste")
28 no treino, 12 no teste- O
random_stateé a seed. A biblioteca usa outro gerador, então os grupos saem diferentes dos nossos, mas a receita é a mesma. - A ordem da resposta é X de treino, X de teste, y de treino, y de teste. É fácil trocar sem querer.
A curva em U
Agora dá pra comparar os graus de um jeito justo: cada polinômio aprende só com o treino e é medido nos dois conjuntos.
graus = np.arange(1, 16)
erros_treino, erros_teste = [], []
for grau in graus:
    coef = np.polyfit(x_tr, y_tr, grau)                                   # aprende SÓ com o treino
    erros_treino.append(np.mean((np.polyval(coef, x_tr) - y_tr) ** 2))
    erros_teste.append(np.mean((np.polyval(coef, x_te) - y_te) ** 2))     # mede em dados novos

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(graus, erros_treino, color=AZUL, marker="o", label="erro no treino")
ax.plot(graus, erros_teste, color=LARANJA, marker="s", label="erro no teste")
ax.set_yscale("log")
ax.minorticks_off()                                               # tira as marcas "2×10⁻²" etc.
ax.set_yticks([0.02, 0.05, 0.1, 0.2, 0.5], ["0,02", "0,05", "0,1", "0,2", "0,5"])
ax.set_title("Mais complexo nem sempre é melhor")
ax.set_xlabel("grau do polinômio (complexidade do modelo)")
ax.set_ylabel("MSE (escala log)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()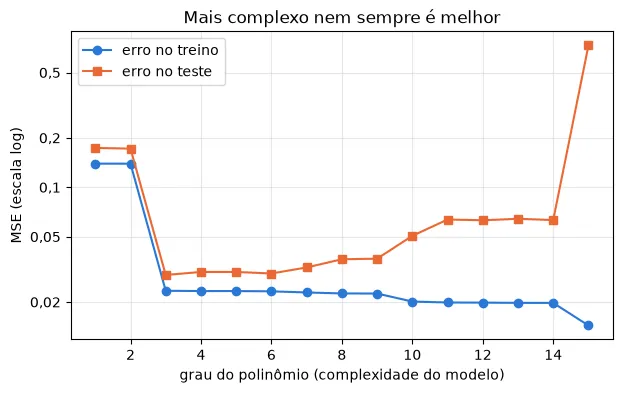
- O erro no treino só desce. Um modelo mais flexível sempre consegue se ajustar melhor aos dados que viu.
- O erro no teste desce, estabiliza e depois sobe. Primeiro o modelo aprende a tendência verdadeira; depois começa a decorar o ruído.
O melhor modelo está no fundo do “U”. A escala é logarítmica porque o grau 15 erra muito mais que os outros no teste.
4. Por que existe validação, além do teste
O problema: se você escolher o grau olhando o erro no teste, o teste passa a influenciar a escolha e deixa de ser uma prova nova. Testando 100 modelos e ficando com o de melhor nota, você acaba escolhendo o que deu sorte naqueles dados.
É como um professor deixar você refazer a prova final quantas vezes quiser e valer a melhor nota: a nota deixa de medir o que você sabe.
A solução: dividir os dados em três partes.
| Conjunto | Pra que serve | Quando olhar |
|---|---|---|
| treino (~60%) | o modelo aprende os parâmetros (os coeficientes) | o tempo todo |
| validação (~20%) | você escolhe entre modelos e configurações (o grau, por exemplo) | a cada tentativa |
| teste (~20%) | a nota final, honesta | uma vez, no fim |
O grau é um hiperparâmetro: uma escolha sua, e não algo que o polyfit aprende sozinho.
# primeiro separa o teste (20%) e guarda na gaveta
x_resto, x_teste, y_resto, y_teste = train_test_split(x, y, test_size=0.2, random_state=0)
# depois divide o resto em treino e validação (25% de 80% = 20% do total)
x_treino, x_val, y_treino, y_val = train_test_split(x_resto, y_resto, test_size=0.25, random_state=0)
print(len(x_treino), "no treino,", len(x_val), "na validação,", len(x_teste), "no teste")

erros_val = []
for grau in range(1, 13):
    coef = np.polyfit(x_treino, y_treino, grau)                             # aprende no treino
    erros_val.append(np.mean((np.polyval(coef, x_val) - y_val) ** 2))       # compara na validação
escolhido = 1 + int(np.argmin(erros_val))       # +1 porque a lista começa no grau 1
print("grau escolhido pela validação:", escolhido)

coef = np.polyfit(x_treino, y_treino, escolhido)
mse_final = np.mean((np.polyval(coef, x_teste) - y_teste) ** 2)             # agora sim: olha o teste UMA vez
print(f"nota final no teste: MSE = {mse_final:.3f}")
24 no treino, 8 na validação, 8 no teste
grau escolhido pela validação: 3
nota final no teste: MSE = 0.0395. Validação cruzada
O problema: com 40 medições, a validação fica com só 8. Aí a escolha depende de quais 8 caíram lá. Veja o grau escolhido mudando só por trocar a seed da divisão:
for seed in range(6):
    x_r, _, y_r, _ = train_test_split(x, y, test_size=0.2, random_state=seed)
    x_t, x_v, y_t, y_v = train_test_split(x_r, y_r, test_size=0.25, random_state=seed)
    erros = [np.mean((np.polyval(np.polyfit(x_t, y_t, g), x_v) - y_v) ** 2) for g in range(1, 13)]
    print(f"seed {seed}: grau escolhido = {1 + int(np.argmin(erros))}")
seed 0: grau escolhido = 3
seed 1: grau escolhido = 3
seed 2: grau escolhido = 3
seed 3: grau escolhido = 4
seed 4: grau escolhido = 5
seed 5: grau escolhido = 6A solução: k-fold. Divida os dados em k partes (as dobras). Em cada rodada, uma parte é a validação e as outras são o treino. No fim, tire a média dos k erros. Assim, cada exemplo é validação exatamente uma vez, e a nota não depende da sorte de uma divisão só.
k, n = 5, 40
blocos = np.array_split(np.arange(n), k)      # 5 blocos seguidos de 8 índices

fig, ax = plt.subplots(figsize=(9, 3))
for rodada, bloco in enumerate(blocos):
    ax.barh(rodada, n, color=AZUL, label="treino" if rodada == 0 else None)
    ax.barh(rodada, len(bloco), left=bloco[0], color=LARANJA, label="validação" if rodada == 0 else None)
ax.set_yticks(range(k), [f"rodada {i + 1}" for i in range(k)])
ax.invert_yaxis()                             # rodada 1 em cima
ax.set_xlabel("exemplos (depois de embaralhar)")
ax.set_title("Validação cruzada com 5 dobras")
ax.legend(loc="upper left", bbox_to_anchor=(1.01, 1))    # legenda do lado de fora, pra não cobrir as barras
plt.show()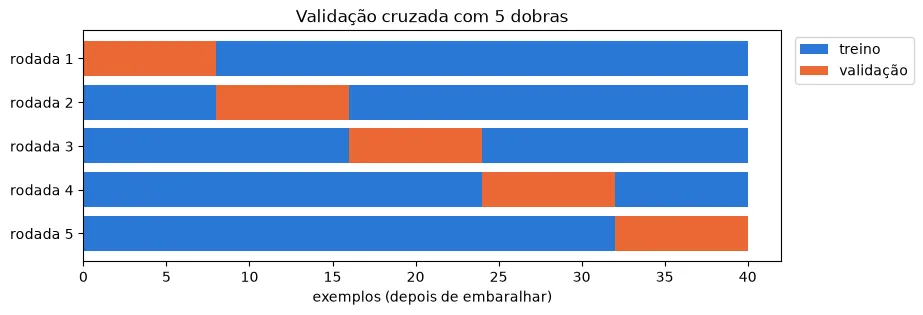
No scikit-learn, quem faz as rodadas é o cross_val_score. Três detalhes que parecem mágica:
make_pipeline(PolynomialFeatures(grau), LinearRegression())encadeia dois passos: montar as colunas 1, x, x², … e depois fazer a regressão. É uma composição de funções, comox => regressao(colunas(x))em TS.X = x.reshape(-1, 1): o scikit-learn quer X como tabela(n, 1), e não como vetor(n,)(aula 00.02).scoring="neg_mean_squared_error": pro scikit-learn, nota maior é sempre melhor. Por isso ele devolve o MSE negativo, e a gente troca o sinal.
from sklearn.model_selection import KFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression

X = x.reshape(-1, 1)
dobras = KFold(n_splits=5, shuffle=True, random_state=0)    # 5 dobras, embaralhando antes

graus_cv = np.arange(1, 13)
medias, desvios = [], []
for grau in graus_cv:
    modelo = make_pipeline(PolynomialFeatures(grau), LinearRegression())
    notas = cross_val_score(modelo, X, y, cv=dobras, scoring="neg_mean_squared_error")   # 5 notas, uma por rodada
    medias.append(-notas.mean())
    desvios.append(notas.std())

melhor = graus_cv[int(np.argmin(medias))]

fig, ax = plt.subplots(figsize=(7, 4))
ax.errorbar(graus_cv, medias, yerr=desvios, color=AZUL, marker="o", capsize=3, label="MSE médio ± desvio")
ax.plot(melhor, min(medias), marker="*", markersize=16, color=LARANJA, linestyle="none", label=f"melhor: grau {melhor}")
ax.set_yscale("log")
ax.minorticks_off()
ax.set_yticks([0.03, 0.05, 0.1, 0.2], ["0,03", "0,05", "0,1", "0,2"])
ax.set_title("Validação cruzada: uma nota por grau")
ax.set_xlabel("grau do polinômio")
ax.set_ylabel("MSE na validação (escala log)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()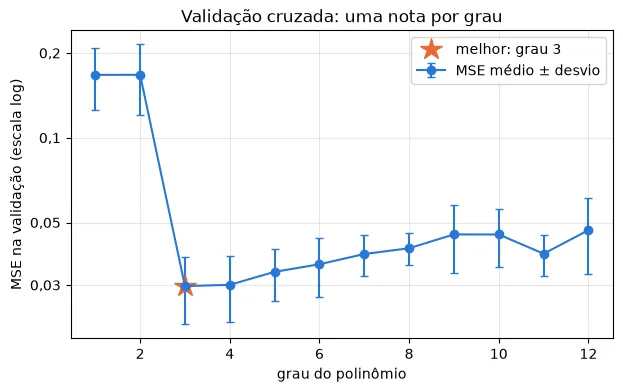
O grau com a menor média é a escolha. O desvio mostra o quanto a nota variou entre as rodadas: barra grande significa um resultado que depende muito de quais dados caíram na validação.
A validação cruzada custa k treinos em vez de um. Com modelos rápidos como esses, compensa. Com redes neurais que levam horas pra treinar, costuma-se usar uma validação só.
6. Regularização (só a ideia)
O problema: pra fazer aquelas curvas malucas, o polinômio de grau 15 precisou de coeficientes enormes.
A solução: multar pesos grandes. A regressão Ridge minimiza outro custo:
O (alpha) é o valor da multa, e é mais um hiperparâmetro:
- alpha 0: sem multa, o modelo decora (overfitting);
- alpha enorme: os pesos são esmagados e o modelo vira quase uma reta (underfitting);
- no meio: uma curva suave.
Voltando às 16 medições da seção 2, sempre com grau 15:
from sklearn.linear_model import Ridge

fig, axs = plt.subplots(1, 4, figsize=(16, 4), sharey=True)
for ax, alpha in zip(axs, [0, 0.001, 0.1, 10]):
    regressao = LinearRegression() if alpha == 0 else Ridge(alpha=alpha)
    modelo = make_pipeline(PolynomialFeatures(15), regressao).fit(x_poucos.reshape(-1, 1), y_poucos)
    maior_peso = np.abs(modelo[-1].coef_).max()      # modelo[-1] é o último passo do pipeline: a regressão
    ax.plot(x_curva, f_verdadeira(x_curva), color="gray", linestyle="--", label="regra verdadeira")
    ax.plot(x_curva, modelo.predict(x_curva.reshape(-1, 1)), color=LARANJA, linewidth=2, label="grau 15")
    ax.scatter(x_poucos, y_poucos, color=AZUL, zorder=3, label="medições")
    ax.set_title(f"alpha = {alpha}\nmaior peso = {maior_peso:.1f}")
    ax.set_ylim(-2.5, 2.5)
    ax.set_xlabel("x")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("y")
axs[0].legend(loc="lower right")
plt.show()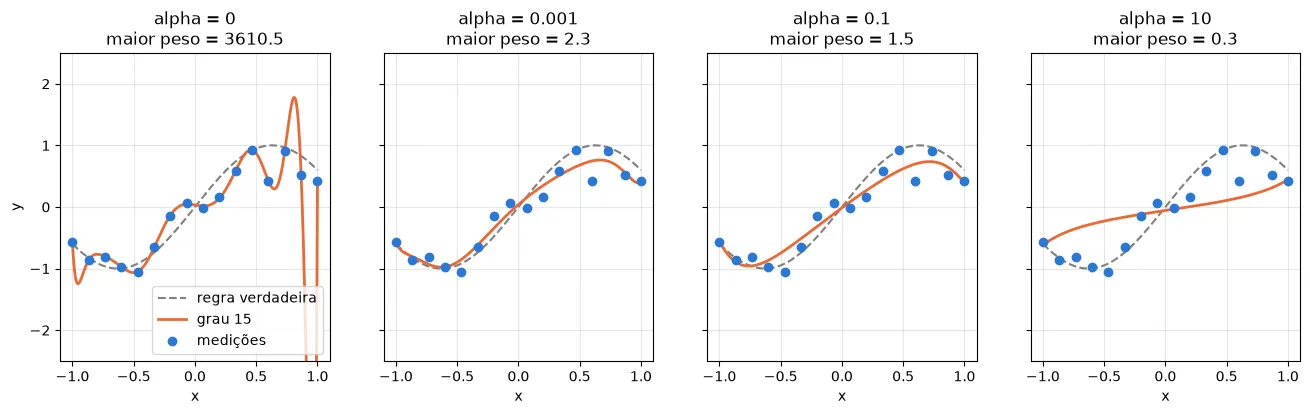
Com a multa, o maior peso cai de milhares pra perto de 1, e a curva se comporta. Como escolher o alpha? Com validação, claro: é o exercício 5.
Pra levar pras próximas disciplinas:
- Nas redes neurais, essa mesma multa se chama weight decay.
- O dropout é outra técnica contra overfitting, própria das redes neurais (disciplina 02).
- O remédio mais eficaz, quando é possível, continua sendo mais dados.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado, tolerancia=1e-6):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido, dtype=float), np.asarray(esperado, dtype=float)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado, rtol=tolerancia, atol=tolerancia):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Dividir à mão
Escreva dividir(X, y, fracao_teste, seed), que devolve X_treino, X_teste, y_treino, y_teste, na mesma ordem do train_test_split. Siga exatamente esta receita, pra dar o mesmo resultado do teste:
rng = np.random.default_rng(seed)eindices = rng.permutation(len(X));n_teste = round(len(X) * fracao_teste);- os primeiros
n_testeíndices vão pro teste, e o resto vai pro treino.
def dividir(X, y, fracao_teste, seed):
    ...  # seu código aqui


X_ex = np.arange(10) * 1.0
y_ex = X_ex * 10
resultado = dividir(X_ex, y_ex, 0.3, seed=0)

if resultado is None:
    print("⏳ ainda não implementado")
else:
    X_treino_ex, X_teste_ex, y_treino_ex, y_teste_ex = resultado
    confere(X_teste_ex, [4.0, 6.0, 2.0])
    confere(X_treino_ex, [7.0, 3.0, 5.0, 9.0, 0.0, 8.0, 1.0])
    confere(y_teste_ex, X_teste_ex * 10)     # cada y tem que continuar junto do seu X
Dica
Com os índices embaralhados em mãos, é só fatiar (indices[:n_teste]) e usar o resultado como índice: X[i_teste] pega várias posições de uma vez (aula 00.02).
Gabarito
def dividir(X, y, fracao_teste, seed):
    rng = np.random.default_rng(seed)
    indices = rng.permutation(len(X))
    n_teste = round(len(X) * fracao_teste)
    i_teste, i_treino = indices[:n_teste], indices[n_teste:]
    return X[i_treino], X[i_teste], y[i_treino], y[i_teste]
Exercício 2 · Erro no treino e no teste
Escreva mse_treino_teste(grau, x_tr, y_tr, x_te, y_te): ajuste um polinômio do grau pedido só com o treino e devolva o par (mse_treino, mse_teste).
O teste usa a divisão da seção 3 (x_tr, x_te, y_tr, y_te).
def mse_treino_teste(grau, x_tr, y_tr, x_te, y_te):
    ...  # seu código aqui


confere(mse_treino_teste(1, x_tr, y_tr, x_te, y_te), [0.13927982394452948, 0.17368026403892456])
confere(mse_treino_teste(3, x_tr, y_tr, x_te, y_te), [0.02341986806294411, 0.029221335701197667])
Dica
np.polyfit(x_tr, y_tr, grau) dá os coeficientes, e np.polyval(coef, x) faz as previsões. O MSE é np.mean((previsto - real) ** 2), uma vez com o treino e outra com o teste.
Gabarito
def mse_treino_teste(grau, x_tr, y_tr, x_te, y_te):
    coef = np.polyfit(x_tr, y_tr, grau)                      # aprende só com o treino
    mse_treino = np.mean((np.polyval(coef, x_tr) - y_tr) ** 2)
    mse_teste = np.mean((np.polyval(coef, x_te) - y_te) ** 2)
    return mse_treino, mse_teste
Exercício 3 · As dobras do k-fold
Escreva k_fold_indices(n, k), que devolve uma lista com k pares (treino, validacao) de arrays de índices:
- divida os índices de
0an - 1emkblocos seguidos, comnp.array_split(np.arange(n), k); - na rodada
i, o blocoié a validação e os outros blocos, juntos, são o treino.
Sem embaralhar, pra ficar fácil de conferir.
def k_fold_indices(n, k):
    ...  # seu código aqui


rodadas = k_fold_indices(10, 3)
if rodadas is None:
    print("⏳ ainda não implementado")
else:
    confere([len(validacao) for _, validacao in rodadas], [4, 3, 3])              # tamanhos das validações
    confere(rodadas[0][0], [4, 5, 6, 7, 8, 9])                                     # treino da rodada 1
    confere(rodadas[2][0], [0, 1, 2, 3, 4, 5, 6])                                  # treino da rodada 3
    confere(np.sort(np.concatenate([v for _, v in rodadas])), np.arange(10))       # todo índice é validação uma vez
Dica
Pra juntar os blocos do treino: np.concatenate([blocos[j] for j in range(k) if j != i]). É o filter + flat do TS: blocos.filter((_, j) => j !== i).flat().
Gabarito
def k_fold_indices(n, k):
    blocos = np.array_split(np.arange(n), k)
    rodadas = []
    for i in range(k):
        validacao = blocos[i]
        treino = np.concatenate([blocos[j] for j in range(k) if j != i])
        rodadas.append((treino, validacao))
    return rodadas
Exercício 4 · Validação cruzada à mão
Escreva erro_cv(grau, x, y, k): usando a sua k_fold_indices, ajuste o polinômio no treino de cada rodada, meça o MSE na validação daquela rodada e devolva a média dos k erros.
Os dados x da seção 3 já estão em ordem aleatória, então dá pra usar os blocos seguidos sem embaralhar.
def erro_cv(grau, x, y, k):
    ...  # seu código aqui


confere(erro_cv(1, x, y, 5), 0.1714774630719848)
confere(erro_cv(3, x, y, 5), 0.030025748315466887)

if erro_cv(3, x, y, 5) is not None:
    notas = cross_val_score(make_pipeline(PolynomialFeatures(3), LinearRegression()), X, y,
                            cv=KFold(n_splits=5), scoring="neg_mean_squared_error")    # KFold sem embaralhar
    print(f"o mesmo com o scikit-learn: {-notas.mean():.6f}")
Dica
for treino, validacao in k_fold_indices(len(x), k): percorre as rodadas. Dentro do laço, x[treino] e x[validacao] pegam os pedaços certos. Guarde os erros numa lista e tire np.mean no fim.
Gabarito
def erro_cv(grau, x, y, k):
    erros = []
    for treino, validacao in k_fold_indices(len(x), k):
        coef = np.polyfit(x[treino], y[treino], grau)
        erros.append(np.mean((np.polyval(coef, x[validacao]) - y[validacao]) ** 2))
    return np.mean(erros)
Exercício 5 (desafio) · Escolhendo o alpha
Escreva escolher_alpha(x, y, alphas, k). Para cada alpha da lista:
- monte o modelo
make_pipeline(PolynomialFeatures(15), Ridge(alpha=alpha)); - faça a validação cruzada com
KFold(n_splits=k, shuffle=True, random_state=0)ecross_val_score, e guarde o MSE médio.
Devolva o alpha com o menor MSE médio.
def escolher_alpha(x, y, alphas, k):
    ...  # seu código aqui


alphas = [0.0001, 0.001, 0.01, 0.1, 1, 10]
confere(escolher_alpha(x, y, alphas, 5), 0.01)
# Depois de acertar: o polinômio de grau 15 com o alpha escolhido, nos 40 pontos
alpha_escolhido = escolher_alpha(x, y, alphas, 5)
if alpha_escolhido is not None:
modelo = make_pipeline(PolynomialFeatures(15), Ridge(alpha=alpha_escolhido)).fit(X, y)
fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(x_curva, f_verdadeira(x_curva), color="gray", linestyle="--", label="regra verdadeira")
ax.plot(x_curva, modelo.predict(x_curva.reshape(-1, 1)), color=LARANJA, linewidth=2, label=f"grau 15, alpha = {alpha_escolhido}")
ax.scatter(x, y, color=AZUL, zorder=3, label="medições")
ax.set_title("Grau 15 domado pela regularização")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.legend()
ax.grid(alpha=0.3)
plt.show()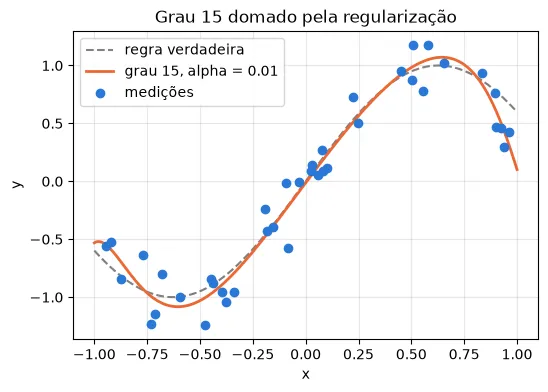
Dica
É a mesma receita da seção 5, trocando o laço dos graus por um laço dos alphas. Não esqueça: o cross_val_score devolve o MSE negativo. Pra achar a posição do menor valor, use np.argmin.
Gabarito
def escolher_alpha(x, y, alphas, k):
    X = x.reshape(-1, 1)
    dobras = KFold(n_splits=k, shuffle=True, random_state=0)
    medias = []
    for alpha in alphas:
        modelo = make_pipeline(PolynomialFeatures(15), Ridge(alpha=alpha))
        notas = cross_val_score(modelo, X, y, cv=dobras, scoring="neg_mean_squared_error")
        medias.append(-notas.mean())
    return alphas[int(np.argmin(medias))]
Resumo
| Conceito | Em uma frase |
|---|---|
| overfitting | o modelo decora os dados de treino, inclusive o ruído, e erra em dados novos |
| underfitting | o modelo é simples demais e erra até nos dados de treino |
| conjunto de teste | dados escondidos até o fim, pra dar uma nota honesta, uma vez |
| conjunto de validação | dados pra escolher entre modelos e hiperparâmetros |
| hiperparâmetro | uma escolha sua (o grau, o alpha), e não algo que o modelo aprende |
| validação cruzada (k-fold) | k rodadas, cada parte vira validação uma vez, e tira-se a média |
| regularização (Ridge) | multar pesos grandes pra domar um modelo flexível demais |
No código: train_test_split(X, y, test_size=0.3, random_state=0) e cross_val_score(modelo, X, y, cv=KFold(5, shuffle=True, random_state=0), scoring="neg_mean_squared_error"), lembrando de trocar o sinal.