Aula 2 de 13
Regressão linear e função de custo
Objetivo: construir o primeiro modelo de ML de verdade: uma reta que prevê o preço de uma casa. No caminho, entender o que é uma função de custo e o que significa “achar os melhores parâmetros”.
Por que isso importa: quase todo modelo de ML segue a mesma receita desta aula: (1) um modelo com parâmetros, (2) um número que mede o quanto ele erra (o custo) e (3) um jeito de achar os parâmetros que deixam esse número o menor possível. Numa rede neural, só muda o tamanho de cada peça.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"


# Os mesmos dados de casas das aulas 01.01 e 01.03 (fictícios, mas com uma regra escondida)
def gerar_casas(n=100, seed=42):
    rng = np.random.default_rng(seed)
    area = rng.uniform(40, 200, size=n)             # m²
    quartos = rng.integers(1, 5, size=n)            # 1 a 4
    idade = rng.uniform(0, 40, size=n)              # anos
    preco = 2.0 * area + 25 * quartos - 1.5 * idade + 50 + rng.normal(0, 20, size=n)   # mil R$
    return area, quartos, idade, preco


area, quartos, idade, preco = gerar_casas()
print(area.shape, preco.shape)
(100,) (100,)1. O problema: prever o preço pela área
Temos 100 casas com área e preço. Queremos uma regra que, dada a área de uma casa nova, diga um preço razoável. Olhando o gráfico, os pontos seguem mais ou menos uma reta.
fig, ax = plt.subplots(figsize=(6, 4))
ax.scatter(area, preco, color=AZUL, alpha=0.7)
ax.set_title("100 casas")
ax.set_xlabel("área (m²)")
ax.set_ylabel("preço (mil R$)")
ax.grid(alpha=0.3)
plt.show()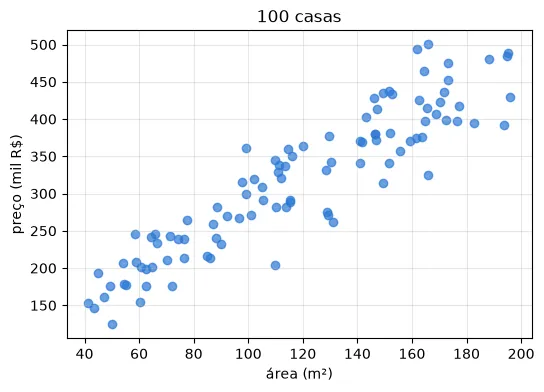
O modelo é uma reta:
Em TypeScript, seria só uma função:
function modelo(area: number, w: number, b: number): number {
  return w * area + b;
}w(de weight, peso) é a inclinação: quantos mil reais cada m² acrescenta.b(de bias) é o deslocamento: o preço “de partida”.
w e b são os parâmetros. Aprender, aqui, é só isto: escolher w e b. Veja dois chutes:
x_reta = np.linspace(40, 200, 2)    # pra desenhar uma reta, 2 pontos bastam

fig, ax = plt.subplots(figsize=(6, 4))
ax.scatter(area, preco, color=AZUL, alpha=0.7, label="casas")
ax.plot(x_reta, 1.5 * x_reta + 150, color=LARANJA, label="chute A: w = 1.5, b = 150")
ax.plot(x_reta, 2.5 * x_reta + 0, color=VERDE, linestyle="--", label="chute B: w = 2.5, b = 0")
ax.set_title("Qual reta é melhor?")
ax.set_xlabel("área (m²)")
ax.set_ylabel("preço (mil R$)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()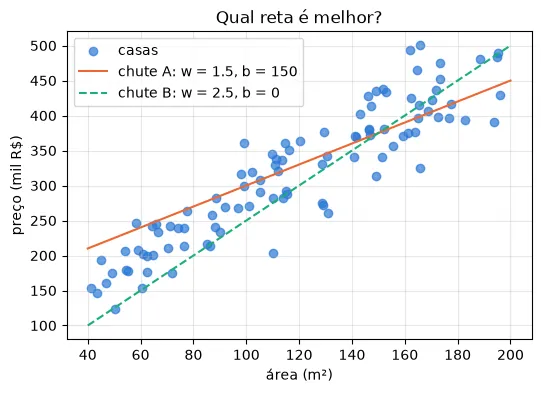
No olho, fica difícil decidir. Precisamos de um número que diga o quanto cada reta erra.
2. Medindo o erro: a função de custo
Para cada casa, o erro (ou resíduo) é real − previsto: os tracinhos que você desenhou na aula 00.03. Precisamos juntar os 100 erros num número só.
Por que não a média dos erros? Porque os sinais se cancelam. Com duas casas:
| Casa | Real | Previsto | Erro | Erro² |
|---|---|---|---|---|
| A | 300 | 280 | +20 | 400 |
| B | 250 | 270 | −20 | 400 |
| média | 0 | 400 |
A média dos erros deu 0, como se o modelo fosse perfeito, e ele errou as duas! Elevando ao quadrado, todo erro vira positivo. Esse é o erro quadrático médio (MSE), a função de custo da regressão linear:
O quadrado tem um efeito colateral: pune mais os erros grandes. Um erro de 60 vira 3600, ou seja, pesa 9 vezes um erro de 20, e não só 3 vezes.
A alternativa sem quadrado é o MAE, a média do erro absoluto. Ele se incomoda menos com erros grandes, parecido com a mediana da aula 00.06. Você vai implementá-lo no exercício 2.
def mse(y, y_prev):
    return np.mean((y - y_prev) ** 2)


print("chute A:", mse(preco, 1.5 * area + 150))
print("chute B:", mse(preco, 2.5 * area + 0))
chute A: 1970.6197926853883
chute B: 2360.445476067646Agora dá pra comparar: o chute A erra menos. Mas será que existe uma reta ainda melhor? E qual é a melhor de todas?
3. O custo como função dos parâmetros
Mudou a ideia: agora os dados estão fixos, e quem varia são w e b. Para cada escolha de (w, b), o MSE dá um número. Ou seja, o custo é uma função dos parâmetros.
Pra começar simples, deixe b fixo em 81 e varie só w:
ws = np.linspace(1, 3, 200)
custos = np.array([mse(preco, w * area + 81) for w in ws])   # um MSE para cada w

fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(ws, custos, color=AZUL)
ax.plot(ws[custos.argmin()], custos.min(), marker="*", markersize=15, color=LARANJA, linestyle="none",
        label=f"mínimo: w ≈ {ws[custos.argmin()]:.2f}")
ax.set_title("Custo × w (com b = 81)")
ax.set_xlabel("w")
ax.set_ylabel("MSE")
ax.legend()
ax.grid(alpha=0.3)
plt.show()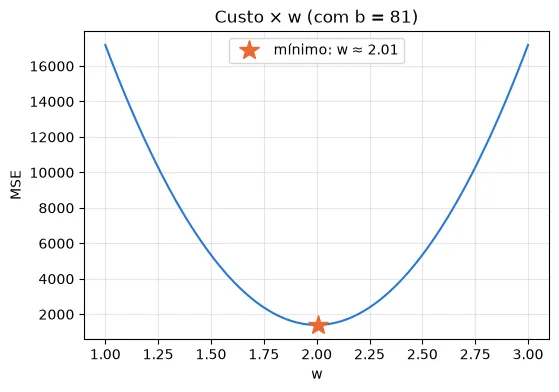
Uma parábola! O melhor w fica no fundo, onde a derivada vale zero, como na aula 00.05. O w que gerou os dados era 2.0.
Com os dois parâmetros variando, o custo vira um terreno, igual aos das aulas 00.03 e 00.05. Pra calcular o MSE em cada ponto da grade, um for aninhado basta. São só 22.500 pontos, e assim fica claro o que está acontecendo:
W, B = np.meshgrid(np.linspace(1, 3, 150), np.linspace(-100, 250, 150))
Z = np.zeros_like(W)
for i in range(W.shape[0]):
    for j in range(W.shape[1]):
        Z[i, j] = mse(preco, W[i, j] * area + B[i, j])   # o custo de cada reta (w, b) da grade

fig, ax = plt.subplots(figsize=(6.5, 4.5))
niveis = [1400, 1500, 2000, 3000, 5000, 10000, 20000, 40000]
mapa = ax.contourf(W, B, Z, levels=niveis, cmap="Blues", extend="max")
fig.colorbar(mapa, ax=ax, label="MSE")
ax.plot(2.0, 81, marker="*", markersize=15, color=LARANJA, linestyle="none", label="perto do mínimo")
ax.set_title("O terreno do custo")
ax.set_xlabel("w")
ax.set_ylabel("b")
ax.legend(loc="upper right")
plt.show()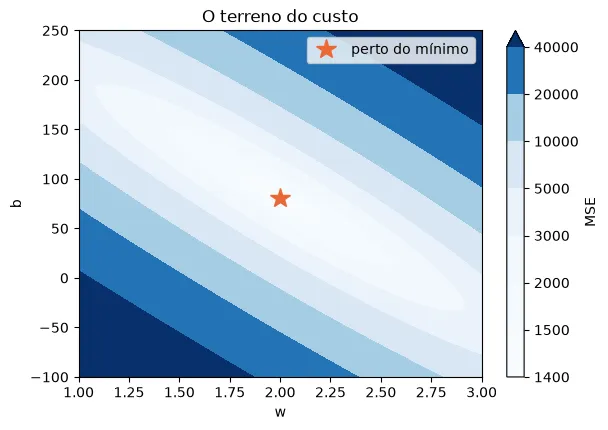
Repare que o “vale” é estreito e inclinado. Aumentar w um pouquinho pode ser compensado diminuindo bastante o b, porque as áreas estão em torno de 120 m². Guarde isso: esse formato de vale vai dar trabalho pro gradiente descendente na aula 01.03, e lá você vai ver como resolver.
4. Achando o fundo do vale de uma vez: mínimos quadrados
Pra reta (e pra qualquer modelo linear), existe um jeito de achar o fundo do vale direto, sem descer passo a passo: o método dos mínimos quadrados. O NumPy tem pronto: np.linalg.lstsq (least squares).
O lstsq resolve um problema no formato A @ coef ≈ y: acha o coef que deixa o erro quadrático o menor possível. Mas o nosso modelo tem aquele + b sozinho… O truque é a coluna de 1s. Escreva o b como b × 1:
Então cada casa vira uma linha [área, 1], e coef = [w, b]:
| A (uma linha por casa) | × | coef | = | previsão |
|---|---|---|---|---|
[163.8, 1] |
[w, b] |
w × 163.8 + b × 1 |
||
[110.2, 1] |
w × 110.2 + b × 1 |
|||
| … | … |
É um produto de matriz por vetor, como na aula 00.04.
A = np.column_stack([area, np.ones(len(area))])   # junta as colunas lado a lado: (100, 2)
print(A[:3])

resultado = np.linalg.lstsq(A, preco, rcond=None)  # o lstsq devolve 4 coisas; a primeira são os coeficientes
w, b = resultado[0]
print(f"w = {w:.3f}, b = {b:.2f}, MSE = {mse(preco, w * area + b):.0f}")
[[163.83296777 1. ]
[110.22055036 1. ]
[177.37566719 1. ]]
w = 1.999, b = 81.12, MSE = 1397fig, ax = plt.subplots(figsize=(6, 4))
ax.scatter(area, preco, color=AZUL, alpha=0.7, label="casas")
ax.plot(x_reta, w * x_reta + b, color=LARANJA, linewidth=2, label=f"melhor reta: w = {w:.2f}, b = {b:.1f}")
ax.set_title("A reta de mínimos quadrados")
ax.set_xlabel("área (m²)")
ax.set_ylabel("preço (mil R$)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()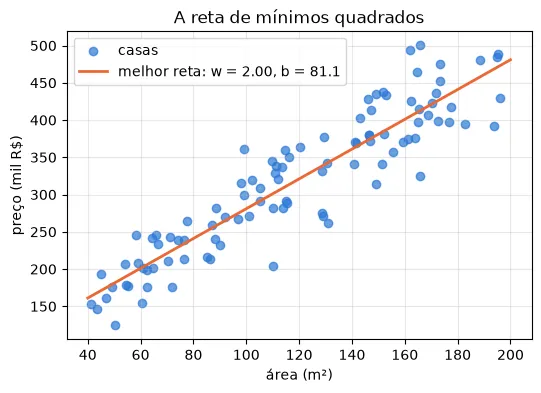
Menor que o MSE dos dois chutes, e não existe reta com MSE menor que essa.
Existe até uma fórmula fechada pra isso, as “equações normais”, que você vai implementar no exercício 5. Então pra que a aula 01.03 vai ensinar gradiente descendente? Porque essa fórmula só existe pra modelos lineares. Numa rede neural não tem fórmula, e o único jeito é descer a ladeira. Na 01.03, você vai chegar exatamente nesses mesmos w e b descendo passo a passo.
🧪 Um outlier puxa a reta
O quadrado do MSE pune muito os erros grandes, e isso tem um preço. Veja o que acontece quando entra uma casa absurda: 60 m² por 1,5 milhão.
area_out = np.append(area, 60)        # np.append devolve um array novo com o valor no fim
preco_out = np.append(preco, 1500)
A_out = np.column_stack([area_out, np.ones(len(area_out))])
w_out, b_out = np.linalg.lstsq(A_out, preco_out, rcond=None)[0]
print(f"sem o outlier: w = {w:.2f}, b = {b:.1f}")
print(f"com o outlier: w = {w_out:.2f}, b = {b_out:.1f}")

fig, axs = plt.subplots(1, 2, figsize=(12, 4))
for ax, titulo in zip(axs, ["Todas as casas", "Zoom nas retas"]):
    ax.scatter(area_out, preco_out, color=AZUL, alpha=0.7, label="casas")
    ax.plot(x_reta, w * x_reta + b, color=LARANJA, linewidth=2, label="sem o outlier")
    ax.plot(x_reta, w_out * x_reta + b_out, color=VERDE, linewidth=2, linestyle="--", label="com o outlier")
    ax.set_title(titulo)
    ax.set_xlabel("área (m²)")
    ax.set_ylabel("preço (mil R$)")
    ax.grid(alpha=0.3)
axs[0].annotate("o outlier", xy=(60, 1500), xytext=(90, 1300), arrowprops={"arrowstyle": "->", "color": "#222222"})
axs[1].set_ylim(100, 550)    # corta o outlier pra enxergar a diferença entre as retas
axs[1].legend(loc="upper left")
fig.suptitle("Uma única casa absurda entorta a reta")
fig.tight_layout()
plt.show()
sem o outlier: w = 2.00, b = 81.1
com o outlier: w = 1.61, b = 139.2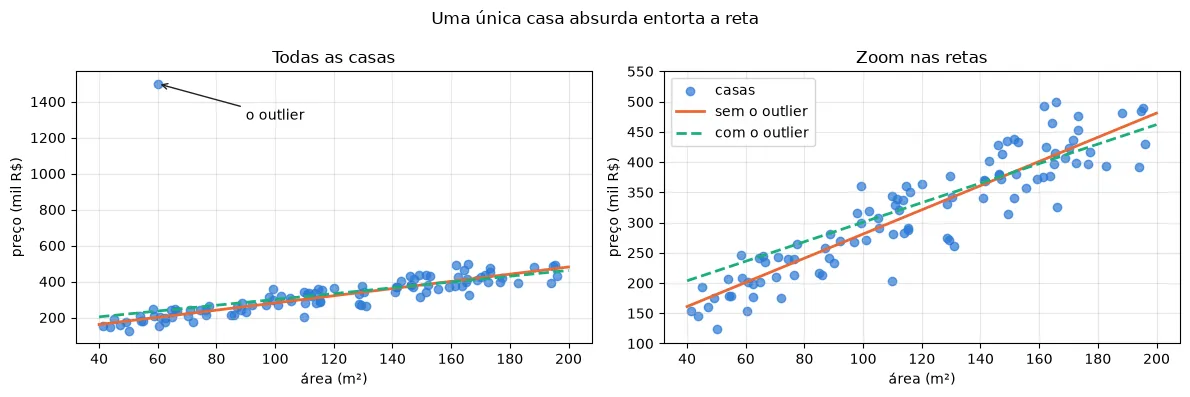
Uma casa entre 101 bastou pra achatar a reta. O erro enorme dessa casa, elevado ao quadrado, “grita” mais alto que as outras 100. Por isso, em dados reais, vale olhar os dados antes (um scatter como esse já denuncia o problema) e, às vezes, usar custos mais tolerantes, como o MAE.
5. Várias features: X @ w + b
O preço não depende só da área. Com quartos e idade, o modelo vira:
É o produto escalar da aula 00.04. Com as casas numa matriz X (uma linha por casa, uma coluna por feature), a previsão de todas é X @ w + b. O truque da coluna de 1s continua valendo:
X = np.column_stack([area, quartos, idade])       # (100, 3)
A3 = np.column_stack([X, np.ones(len(X))])        # (100, 4): a última coluna multiplica o b
coef = np.linalg.lstsq(A3, preco, rcond=None)[0]
w3, b3 = coef[:3], coef[3]                         # os 3 pesos e, no fim, o b

print("pesos:", w3.round(2), " b:", round(b3, 2))
print(f"MSE com 1 feature:  {mse(preco, w * area + b):.0f}")
print(f"MSE com 3 features: {mse(preco, X @ w3 + b3):.0f}")
pesos: [ 1.94 26.45 -1.64] b: 57.27
MSE com 1 feature: 1397
MSE com 3 features: 424O erro caiu bastante: mais informação, previsão melhor. E como os dados são fictícios, dá pra comparar com a regra escondida que os gerou:
| Parâmetro | Regra que gerou os dados | O que o modelo achou | Leitura |
|---|---|---|---|
| área | 2.0 | 1.94 | cada m² vale ~2 mil |
| quartos | 25 | 26.45 | cada quarto vale ~25 mil |
| idade | −1.5 | −1.64 | cada ano de idade tira ~1,5 mil |
| b | 50 | 57.27 | preço “de partida” |
Não bate exato por causa do ruído: o rng.normal(0, 20) somou uns ±20 mil aleatórios a cada preço, e com só 100 casas o modelo não tem como separar tudo. Com mais casas, os valores chegariam mais perto.
Repare também no b: com só a área, ele era 81; agora é 57. A reta simples “escondia” no b o efeito médio dos quartos e da idade.
6. Com o scikit-learn
O scikit-learn é a biblioteca padrão de ML “clássico” em Python. Todo modelo dele segue o mesmo formato: um objeto com fit (aprender) e predict (prever). Em TypeScript, seria algo assim:
class RegressaoLinear {
  coef: number[] = [];
  intercept = 0;
  fit(X: number[][], y: number[]) { /* acha coef e intercept */ return this; }
  predict(X: number[][]) { return X.map(linha => dot(linha, this.coef) + this.intercept); }
}
O _ no fim de coef_ e intercept_ é uma convenção do scikit-learn: marca o que foi aprendido no fit.
from sklearn.linear_model import LinearRegression

modelo = LinearRegression()
modelo.fit(X, preco)

print("coef_:", modelo.coef_.round(2), " intercept_:", round(modelo.intercept_, 2))
print("igual ao lstsq?", np.allclose(modelo.coef_, w3), np.isclose(modelo.intercept_, b3))

previsto = modelo.predict(X)
coef_: [ 1.94 26.45 -1.64] intercept_: 57.27
igual ao lstsq? True TrueQuão bom é o modelo?
- MSE: está em “mil R$ ao quadrado”, uma unidade difícil de imaginar.
- RMSE (a raiz do MSE): volta pra unidade do preço. “O modelo erra, tipicamente, uns 20 mil.”
- R²: compara o modelo com a linha de base mais ingênua possível, que é chutar sempre o preço médio.
| Modelo | MSE | R² |
|---|---|---|
| chutar sempre a média | ~8980 | 0 |
| reta com 1 feature | ~1397 | 0.84 |
| 3 features | ~424 | 0.95 |
R² = 0.95 quer dizer que o modelo eliminou 95% do erro do chute ingênuo. R² = 1 seria perfeito, e um R² negativo significaria que o modelo é pior que chutar a média.
from sklearn.metrics import mean_squared_error, r2_score

erro = mean_squared_error(preco, previsto)
print(f"MSE:  {erro:.0f}")
print(f"RMSE: {np.sqrt(erro):.1f} mil R$")
print(f"R²:   {r2_score(preco, previsto):.3f}")

fig, ax = plt.subplots(figsize=(5, 5))
ax.scatter(preco, previsto, color=AZUL, alpha=0.7, label="casas")
ax.plot([100, 520], [100, 520], color="gray", linestyle="--", label="previsão perfeita")
ax.set_title("Previsto × real")
ax.set_xlabel("preço real (mil R$)")
ax.set_ylabel("preço previsto (mil R$)")
ax.set_aspect("equal")
ax.legend()
ax.grid(alpha=0.3)
plt.show()
MSE: 424
RMSE: 20.6 mil R$
R²: 0.953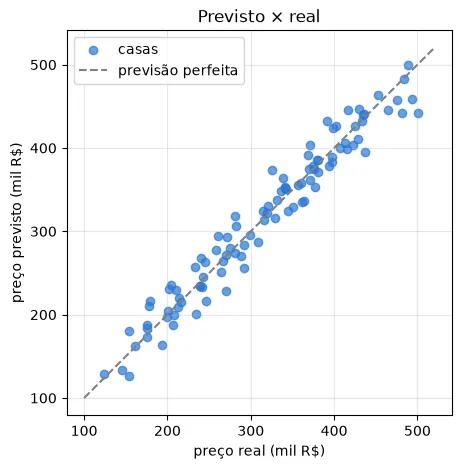
No gráfico “previsto × real”, cada ponto é uma casa. Quanto mais perto da diagonal, melhor.
⚠️ Um aviso honesto: medimos o erro nas mesmas casas usadas pra ajustar o modelo, e isso é otimista, como corrigir a prova com o gabarito na mão. O jeito certo (separar casas de treino e de teste) é o assunto da aula 01.07.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · O modelo
Escreva prever(area, w, b), que devolve o preço previsto. Tem que funcionar tanto com um número quanto com um array de áreas, sem laço.
def prever(area, w, b):
    ...  # seu código aqui


confere(prever(50, 1.5, 10), 85)
confere(prever(np.array([100, 150]), 2.0, 80), [280, 380])
Dica
É uma linha. Operações do NumPy com um array funcionam elemento a elemento (aula 00.02), então a mesma conta serve pros dois casos.
Gabarito
def prever(area, w, b):
    return w * area + b
Exercício 2 · Outras medidas de erro
Escreva:
mae(y, y_prev): a média do erro absoluto (np.abs);rmse(y, y_prev): a raiz do MSE.
def mae(y, y_prev):
    ...  # seu código aqui


def rmse(y, y_prev):
    ...  # seu código aqui


y_teste = np.array([3, 5, 7])
previsto_teste = np.array([2, 5, 9])    # erros: 1, 0, -2
confere(mae(y_teste, previsto_teste), 1.0)
confere(rmse(y_teste, previsto_teste), np.sqrt(5 / 3))
Dica
O MAE é a média de np.abs(y - y_prev). O RMSE é np.sqrt do MSE da seção 2.
Gabarito
def mae(y, y_prev):
    return np.mean(np.abs(y - y_prev))

def rmse(y, y_prev):
    return np.sqrt(np.mean((y - y_prev) ** 2))
Exercício 3 · R² à mão
Escreva r2(y, y_prev) com a fórmula da seção 6 e compare com o r2_score do scikit-learn.
def r2(y, y_prev):
    ...  # seu código aqui


confere(r2(np.array([1.0, 2.0, 3.0]), np.array([1.0, 2.0, 3.0])), 1.0)   # previsão perfeita
confere(r2(np.array([1.0, 2.0, 3.0]), np.array([2.0, 2.0, 2.0])), 0.0)   # chutou sempre a média
confere(r2(preco, previsto), r2_score(preco, previsto))                     # igual ao scikit-learn
Dica
“Chutar a média” é prever y.mean() pra todo mundo. O MSE desse chute é np.mean((y - y.mean()) ** 2), que é a variância da aula 00.06.
Gabarito
def r2(y, y_prev):
    mse_modelo = np.mean((y - y_prev) ** 2)
    mse_media = np.mean((y - y.mean()) ** 2)    # o erro de chutar sempre a média
    return 1 - mse_modelo / mse_media
Exercício 4 · Seu próprio fit
Escreva ajustar(X, y), que acha os melhores pesos com np.linalg.lstsq e o truque da coluna de 1s. Devolva um array só, com os pesos e, no fim, o b, que é exatamente o formato que o lstsq devolve.
Tem que funcionar com qualquer número de features: X pode ter 1 coluna ou várias.
def ajustar(X, y):
    ...  # seu código aqui


confere(ajustar(area.reshape(-1, 1), preco), [1.99913008, 81.1184772])                 # só a área
confere(ajustar(X, preco), [1.9438651, 26.44724326, -1.64075002, 57.26893827])      # área, quartos e idade
Dica
np.column_stack([X, np.ones(len(X))]) acrescenta a coluna de 1s à direita, e o resultado do lstsq que interessa é o [0]. O area.reshape(-1, 1) do teste transforma o vetor de áreas numa matriz de uma coluna só.
Gabarito
def ajustar(X, y):
    A = np.column_stack([X, np.ones(len(X))])    # a coluna de 1s é a que multiplica o b
    return np.linalg.lstsq(A, y, rcond=None)[0]
Exercício 5 (desafio) · A fórmula fechada
Existe uma fórmula que dá o fundo do vale direto. São as equações normais:
em que A é a matriz com a coluna de 1s. Ela vem de igualar a zero as derivadas parciais do MSE (aula 00.05): no fundo do vale, a inclinação é zero em todas as direções.
Escreva ajustar_formula(X, y), que resolve esse sistema e devolve o mesmo formato do exercício 4. Os resultados precisam bater com os do lstsq.
def ajustar_formula(X, y):
    ...  # seu código aqui


confere(ajustar_formula(area.reshape(-1, 1), preco), [1.99913008, 81.1184772])
confere(ajustar_formula(X, preco), [1.9438651, 26.44724326, -1.64075002, 57.26893827])
Dica
np.linalg.solve(M, v) resolve o sistema M @ x = v. Aqui, M é A.T @ A e v é A.T @ y (a transposta e o @ da aula 00.04). Seria possível calcular a inversa de M e multiplicar, mas o solve é mais rápido e mais preciso.
Gabarito
def ajustar_formula(X, y):
    A = np.column_stack([X, np.ones(len(X))])
    return np.linalg.solve(A.T @ A, A.T @ y)     # resolve (AᵀA) · coef = Aᵀy
Por que o lstsq existe, se a fórmula é tão curta? Porque, quando as colunas de A são quase iguais entre si, o A.T @ A fica “mal condicionado” e os erros de arredondamento do float crescem. O lstsq usa um método mais estável.
Resumo
| Peça | Nesta aula | Em geral |
|---|---|---|
| modelo | preço = w × área + b (ou X @ w + b) |
uma função com parâmetros |
| parâmetros | w e b |
os pesos que o treino ajusta |
| função de custo | MSE: | o número que mede o erro |
| treino | achar o fundo do vale (lstsq) |
minimizar o custo |
| avaliação | RMSE (na unidade de y) e R² (comparado com chutar a média) | comparar com uma linha de base |
- O custo é uma função dos parâmetros: um terreno em que o melhor modelo é o ponto mais baixo.
- O quadrado do MSE pune erros grandes, e por isso um outlier pode entortar a reta.
- Com o scikit-learn:
LinearRegression().fit(X, y), depois.predict(X),.coef_e.intercept_.