Aula 3 de 13
Gradiente descendente
Objetivo: treinar a regressão linear “descendo a ladeira” do custo, do zero em NumPy, e entender por que padronizar os dados muda tudo.
Por que isso importa: é assim que praticamente todo modelo moderno é treinado, de uma reta até um modelo de linguagem com bilhões de parâmetros. A receita é sempre a mesma: calcular o gradiente do custo e dar um passinho na direção contrária, milhões de vezes.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"


def gerar_casas(n=100, seed=42):
    rng = np.random.default_rng(seed)
    area = rng.uniform(40, 200, size=n)             # m²
    quartos = rng.integers(1, 5, size=n)            # 1 a 4
    idade = rng.uniform(0, 40, size=n)              # anos
    preco = 2.0 * area + 25 * quartos - 1.5 * idade + 50 + rng.normal(0, 20, size=n)   # mil R$
    return area, quartos, idade, preco
1. O problema: nem todo modelo tem fórmula
Na aula 01.02, a melhor reta saiu de uma fórmula pronta (lstsq e LinearRegression). Só que essa fórmula só existe para modelos lineares com custo MSE. Uma rede neural não tem fórmula nenhuma, e o único jeito é procurar.
A procura é a bolinha da aula 00.05: começar num chute e dar passos morro abaixo no terreno do custo.
Pra isso, falta uma peça: a derivada do MSE em relação a cada parâmetro. Primeiro, a resposta da fórmula, pra comparar no fim:
area, quartos, idade, preco = gerar_casas()

# o scikit-learn quer uma TABELA (n linhas, 1 coluna por feature), mesmo com uma feature só: daí o reshape(-1, 1)
lr1 = LinearRegression().fit(area.reshape(-1, 1), preco)
mse_minimo_1 = np.mean((lr1.predict(area.reshape(-1, 1)) - preco) ** 2)

print(f"pela fórmula: preço = {lr1.coef_[0]:.3f} × área + {lr1.intercept_:.2f}")
print(f"MSE mínimo possível: {mse_minimo_1:.0f}")
pela fórmula: preço = 1.999 × área + 81.12
MSE mínimo possível: 13972. O gradiente do MSE
O modelo é . Para uma casa, o erro é , e o custo dela é .
O custo depende do erro, que depende de . É a regra da cadeia da aula 00.05: derivada de fora vezes derivada de dentro.
O MSE é a média dos custos das casas, então o gradiente também é a média:
Com 3 casas e o chute , :
| área | real | previsto (2 × área) | erro | erro × área |
|---|---|---|---|---|
| 50 | 150 | 100 | −50 | −2500 |
| 100 | 250 | 200 | −50 | −5000 |
| 150 | 300 | 300 | 0 | 0 |
Os dois são negativos, ou seja, aumentar e diminui o custo. Faz sentido: o modelo está prevendo abaixo do real.
area3 = np.array([50, 100, 150])
preco3 = np.array([150, 250, 300])
w, b = 2.0, 0.0

erro = (w * area3 + b) - preco3
print("erro:", erro)
print("dMSE/dw:", 2 / len(area3) * np.sum(erro * area3))
print("dMSE/db:", 2 / len(area3) * np.sum(erro))


# conferindo com a derivada numérica da aula 00.05 (diferença central)
def mse3(w, b):
    return np.mean((w * area3 + b - preco3) ** 2)

h = 1e-5
print("numérica w:", (mse3(w + h, b) - mse3(w - h, b)) / (2 * h))
print("numérica b:", (mse3(w, b + h) - mse3(w, b - h)) / (2 * h))
erro: [-50. -50. 0.]
dMSE/dw: -5000.0
dMSE/db: -66.66666666666666
numérica w: -5000.000000029559
numérica b: -66.666666680248453. O laço de treino
Juntando as peças: calcular o erro, calcular o gradiente, dar o passo, e repetir. Cada repetição que passa por todos os dados se chama época. Em TypeScript:
let w = 0, b = 0;
for (let epoca = 0; epoca < epocas; epoca++) {
  let dw = 0, db = 0;
  for (let i = 0; i < n; i++) {
    const erro = (w * area[i] + b) - preco[i];
    dw += (2 / n) * erro * area[i];
    db += (2 / n) * erro;
  }
  w -= taxa * dw;
  b -= taxa * db;
}
Em NumPy, o laço de dentro some (vetorização):
def treinar_1d(x, y, taxa, epocas, guardar=(1, 2, 5)):
    w, b = 0.0, 0.0                  # chute inicial
    historico = []                   # MSE de cada época, pra desenhar a curva
    retas = {}                       # (w, b) de algumas épocas, pra ver a reta mudando
    for epoca in range(epocas):
        if epoca in guardar:
            retas[epoca] = (w, b)
        erro = (w * x + b) - y
        historico.append(np.mean(erro ** 2))
        dw = 2 * np.mean(erro * x)   # = (2/n) × soma(erro × x)
        db = 2 * np.mean(erro)
        w -= taxa * dw
        b -= taxa * db
    retas[epocas] = (w, b)
    return w, b, historico, retas


w, b, historico, retas = treinar_1d(area, preco, taxa=1e-5, epocas=200)
print(f"depois de 200 épocas: preço = {w:.3f} × área + {b:.2f}   (MSE {historico[-1]:.0f})")
depois de 200 épocas: preço = 2.604 × área + 0.06 (MSE 2186)A taxa é um número minúsculo (0,00001), e o motivo aparece na seção 4. Primeiro, o resultado:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4.2))

ax1.plot(historico, color=AZUL)
ax1.axhline(mse_minimo_1, color=LARANJA, linestyle="--", label="mínimo (fórmula)")
ax1.set_yscale("log")                     # o custo cai de 100 mil pra 2 mil: a escala log mostra as duas pontas
ax1.set_title("Custo a cada época")
ax1.set_xlabel("época")
ax1.set_ylabel("MSE (escala log)")
ax1.legend()
ax1.grid(alpha=0.3)

x_reta = np.array([40, 200])
cores = plt.cm.Blues(np.linspace(0.35, 1, len(retas)))    # épocas mais novas = azul mais escuro
ax2.scatter(area, preco, color="gray", alpha=0.5, label="casas")
for (epoca, (w_e, b_e)), cor in zip(retas.items(), cores):
    ax2.plot(x_reta, w_e * x_reta + b_e, color=cor, label=f"época {epoca}")
ax2.plot(x_reta, lr1.predict(x_reta.reshape(-1, 1)), color=LARANJA, linestyle="--", label="fórmula (01.02)")
ax2.set_title("A reta ao longo do treino")
ax2.set_xlabel("área (m²)")
ax2.set_ylabel("preço (mil R$)")
ax2.legend(fontsize=9)
ax2.grid(alpha=0.3)

fig.tight_layout()
plt.show()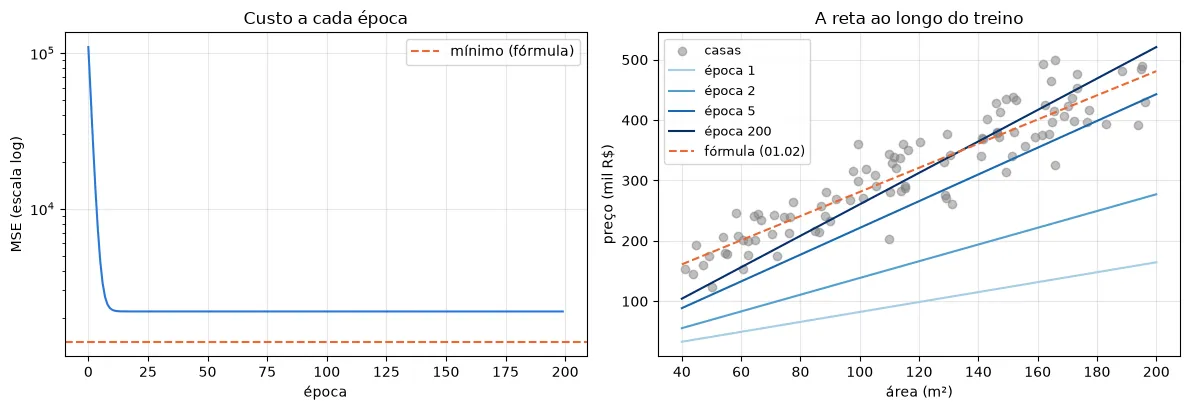
O custo despencou nas primeiras épocas e depois empacou num valor acima do mínimo. A reta de 200 épocas ficou mais inclinada que a da fórmula e passa perto da origem, porque o b quase não saiu do zero. O que aconteceu?
4. O problema da escala
Compare os dois gradientes: o de w tem erro × área, com área na casa de 120, e o de b tem só erro. Por causa disso, o terreno do custo é dezenas de milhares de vezes mais íngreme na direção do w do que na do b. É o “vale estreito” do desafio da aula 00.05.
- Com uma taxa um pouco maior, o
wpassa do ponto e o treino explode. - Com a taxa pequena que o
waguenta, obanda a passos de formiga.
w, b, historico_lento, _ = treinar_1d(area, preco, taxa=5e-5, epocas=100_000)    # demora alguns segundos
print(f"100 mil épocas: preço = {w:.3f} × área + {b:.2f}   (MSE {historico_lento[-1]:.0f}; o mínimo é {mse_minimo_1:.0f})")

with np.errstate(over="ignore", invalid="ignore"):     # esconde o aviso de "número grande demais"
    _, _, historico_explode, _ = treinar_1d(area, preco, taxa=7e-5, epocas=30)
print(f"taxa 7e-5: MSE depois de 30 épocas = {historico_explode[-1]:.1e}   (explodiu)")
100 mil épocas: preço = 2.181 × área + 56.73 (MSE 1468; o mínimo é 1397)
taxa 7e-5: MSE depois de 30 épocas = 7.1e+09 (explodiu)A solução é padronizar, com o z-score das aulas 00.02 e 00.06: . Depois disso, a feature tem média 0 e desvio 1, na mesma escala que o b, e o terreno vira uma tigela redonda:
media_area, desvio_area = area.mean(), area.std()
z = (area - media_area) / desvio_area


def caminho(x, y, taxa, epocas):
    # os (w, b) visitados pelo gradiente descendente, época a época
    w, b, pontos = 0.0, 0.0, [(0.0, 0.0)]
    for _ in range(epocas):
        erro = (w * x + b) - y
        w, b = w - taxa * 2 * np.mean(erro * x), b - taxa * 2 * np.mean(erro)   # atualiza os dois ao mesmo tempo
        pontos.append((w, b))
    return np.array(pontos)


def terreno(x, y, ws, bs):
    # MSE para cada combinação (w, b) de uma grade (o meshgrid da aula 00.03)
    W, B = np.meshgrid(ws, bs)
    Z = np.zeros_like(W)
    for i in range(len(x)):                       # soma o erro² de cada casa na grade inteira
        Z += (W * x[i] + B - y[i]) ** 2
    return W, B, Z / len(x)


lr_z = LinearRegression().fit(z.reshape(-1, 1), preco)    # o mínimo, na escala padronizada
paineis = [
    ("sem padronizar: vale estreito", area, 5e-5, 2000, np.linspace(0, 4.5, 200), np.linspace(-20, 120, 200), (lr1.coef_[0], lr1.intercept_)),
    ("padronizado: tigela redonda", z, 0.3, 30, np.linspace(-100, 320, 200), np.linspace(-20, 400, 200), (lr_z.coef_[0], lr_z.intercept_)),
]

fig, axs = plt.subplots(1, 2, figsize=(12, 4.8))
for ax, (titulo, x, taxa, epocas, ws, bs, minimo) in zip(axs, paineis):
    W, B, Z = terreno(x, preco, ws, bs)
    ax.contourf(W, B, np.log10(Z), levels=20, cmap="Blues")      # log10: senão só o fundo do vale aparece
    pts = caminho(x, preco, taxa, epocas)
    ax.plot(pts[:, 0], pts[:, 1], color=LARANJA, marker=".", markersize=4, label=f"{epocas} épocas (taxa {taxa})")
    ax.plot(*minimo, marker="*", markersize=16, color="black", linestyle="none", label="mínimo")
    ax.set_title(titulo)
    ax.set_xlabel("w")
    ax.set_ylabel("b")
    ax.legend(loc="upper right", fontsize=9)
axs[1].set_aspect("equal")     # mesma escala nos dois eixos, pra ver que a tigela é redonda
fig.tight_layout()
plt.show()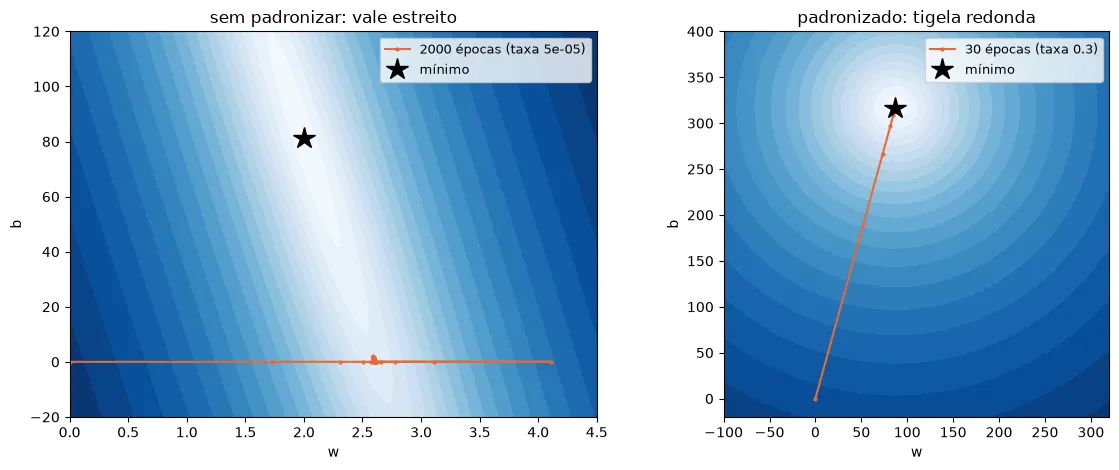
À esquerda, a bolinha cai no fundo do vale logo nos primeiros passos. Nas 2.000 épocas seguintes, quase não anda, porque o fundo do vale é quase plano na direção do b, e a estrela continua longe. À direita, em 30 épocas, ela vai direto.
Comparando as curvas de custo:
w_pad, b_pad, historico_pad, _ = treinar_1d(z, preco, taxa=0.3, epocas=50)
print(f"padronizado, 50 épocas: preço = {w_pad:.3f} × z + {b_pad:.2f}   (MSE {historico_pad[-1]:.0f})")

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(historico_lento[:50], color=AZUL, label="área original (taxa 5e-5)")
ax.plot(historico_pad, color=VERDE, label="área padronizada (taxa 0.3)")
ax.axhline(mse_minimo_1, color=LARANJA, linestyle="--", label="mínimo")
ax.set_yscale("log")
ax.set_title("As primeiras 50 épocas")
ax.set_xlabel("época")
ax.set_ylabel("MSE (escala log)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()
padronizado, 50 épocas: preço = 87.081 × z + 316.77 (MSE 1397)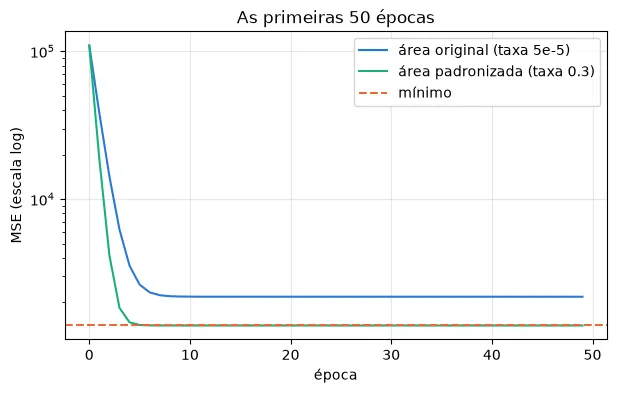
Um detalhe: o modelo padronizado recebe z, e não a área. Pra usar com a área de verdade, é preciso desfazer a padronização e converter o w e o b de volta. Essa conversão é o exercício 2.
Padronizar as features antes de treinar é regra em ML, e não só pra regressão linear: redes neurais sofrem do mesmo jeito.
5. Várias features
Agora o preço depende de área, quartos e idade. O modelo é o da aula 00.04: , com um peso por coluna de .
O gradiente de cada peso é a mesma conta de antes, usando a coluna :
Em TypeScript, seriam dois laços:
const dw = new Array(d).fill(0);
for (let i = 0; i < n; i++)
  for (let j = 0; j < d; j++)
    dw[j] += (2 / n) * erro[i] * X[i][j];
Para cada coluna , a soma é um produto escalar entre a coluna e o vetor de erros. Todas as colunas de uma vez: X.T @ erro. Pela regra dos formatos da aula 00.04, X.T é (3, n) e erro é (n,), então o resultado é (3,): um gradiente por peso.
X = np.column_stack([area, quartos, idade])     # junta os vetores como colunas: (100, 3)
media, desvio = X.mean(axis=0), X.std(axis=0)    # uma média e um desvio por coluna
Xz = (X - media) / desvio                        # padroniza cada coluna (broadcasting)

w = np.zeros(3)
b = 0.0
for epoca in range(300):
    erro = (Xz @ w + b) - preco
    w -= 0.1 * (2 / len(preco)) * (Xz.T @ erro)
    b -= 0.1 * 2 * np.mean(erro)

lr = LinearRegression().fit(Xz, preco)
mse_minimo = np.mean((lr.predict(Xz) - preco) ** 2)

print("gradiente descendente:", w.round(3), round(b, 3))
print("LinearRegression:     ", lr.coef_.round(3), round(lr.intercept_, 3))
gradiente descendente: [ 84.674 27.531 -19.663] 316.766
LinearRegression: [ 84.674 27.531 -19.663] 316.766Os mesmos pesos, até a terceira casa decimal. Voltando para a escala original, dá pra comparar com os números que geraram os dados em gerar_casas:
w_original = w / desvio
b_original = b - np.sum(w * media / desvio)

print("aprendido: ", w_original.round(2), round(b_original, 1))
print("verdadeiro:", np.array([2.0, 25.0, -1.5]), 50.0)
aprendido: [ 1.94 26.45 -1.64] 57.3
verdadeiro: [ 2. 25. -1.5] 50.0Perto, mas não iguais. A diferença vem do ruído (rng.normal) que colocamos nos preços: com 100 casas, ele ainda atrapalha um pouco. Com mais casas, o modelo chegaria mais perto dos números verdadeiros.
6. Mini-batch: um pedaço dos dados por passo
O problema: aqui cada passo olha as 100 casas. Um modelo de linguagem treina com bilhões de exemplos, e olhar todos a cada passo seria caro demais.
A ideia: estimar o gradiente com um pedaço aleatório dos dados, um mini-batch de, por exemplo, 10 casas. A estimativa tem ruído, mas custa 10 vezes menos. Isso se chama gradiente descendente estocástico (estocástico = aleatório).
def custo(w, b):
    return np.mean((Xz @ w + b - preco) ** 2)


# com todas as casas em cada passo
w, b = np.zeros(3), 0.0
custo_completo = [custo(w, b)]
for passo in range(10):
    erro = (Xz @ w + b) - preco
    w -= 0.1 * (2 / len(preco)) * (Xz.T @ erro)
    b -= 0.1 * 2 * np.mean(erro)
    custo_completo.append(custo(w, b))

# com mini-batches de 10 casas
rng = np.random.default_rng(seed=0)
w, b = np.zeros(3), 0.0
custo_mb = [custo(w, b)]
for epoca in range(10):
    ordem = rng.permutation(len(preco))              # embaralha a ordem das casas a cada época
    for inicio in range(0, len(preco), 10):
        lote = ordem[inicio:inicio + 10]              # os índices das 10 casas deste passo
        erro = (Xz[lote] @ w + b) - preco[lote]       # Xz[lote] pega só as linhas desses índices
        w -= 0.1 * (2 / len(lote)) * (Xz[lote].T @ erro)
        b -= 0.1 * 2 * np.mean(erro)
        custo_mb.append(custo(w, b))

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(np.arange(len(custo_completo)) * 100, custo_completo, color=AZUL, marker="o", label="todas as casas (100 por passo)")
ax.plot(np.arange(len(custo_mb)) * 10, custo_mb, color=VERDE, label="mini-batch (10 por passo)")
ax.axhline(mse_minimo, color=LARANJA, linestyle="--", label="mínimo")
ax.set_yscale("log")
ax.set_title("Mesmo esforço: 1.000 casas lidas")
ax.set_xlabel("casas usadas nos cálculos até agora")
ax.set_ylabel("MSE (escala log)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()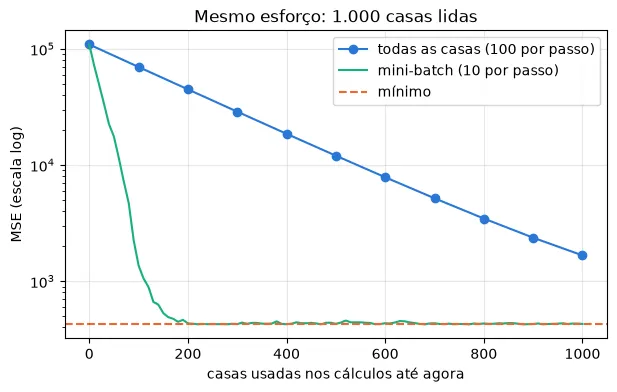
Lendo a mesma quantidade de casas, o mini-batch deu 100 passos (contra 10) e chegou bem mais perto do mínimo. A curva treme, porque cada lote puxa pra um lado, mas a tendência é descer.
É exatamente assim que as redes neurais são treinadas. No PyTorch, o DataLoader(dados, batch_size=32, shuffle=True) faz o embaralhamento e o corte em lotes (disciplina 02). No scikit-learn, o SGDRegressor é esta regressão linear treinada com mini-batch.
Exercícios
Os exercícios usam Xz, preco, lr e outras variáveis das seções anteriores, então elas precisam ter rodado antes. A célula abaixo cria as funções de conferência.
Código de apoio dos exercícios
def confere(obtido, esperado, tolerancia=1e-6):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido, dtype=float), np.asarray(esperado, dtype=float)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado, rtol=tolerancia, atol=tolerancia):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")


def confere_taxa(taxa, epocas=20):
    if taxa is None:
        print("⏳ ainda não escolheu a taxa")
        return
    w, b = np.zeros(Xz.shape[1]), 0.0
    custos = []
    with np.errstate(over="ignore", invalid="ignore"):
        for _ in range(epocas + 1):
            erro = (Xz @ w + b) - preco
            custos.append(np.mean(erro ** 2))
            w = w - taxa * (2 / len(preco)) * (Xz.T @ erro)
            b = b - taxa * 2 * np.mean(erro)
    fig, ax = plt.subplots(figsize=(6, 3.5))
    ax.plot(custos, color=AZUL, marker="o", markersize=3, label=f"taxa = {taxa}")
    ax.axhline(mse_minimo, color=LARANJA, linestyle="--", label="mínimo")
    ax.set_yscale("log")
    ax.set_title(f"{epocas} épocas com a sua taxa")
    ax.set_xlabel("época")
    ax.set_ylabel("MSE (escala log)")
    ax.legend()
    ax.grid(alpha=0.3)
    plt.show()
    razao = custos[-1] / mse_minimo
    if not np.isfinite(razao) or custos[-1] > custos[0]:
        print("❌ divergiu: a taxa é grande demais")
    elif razao > 1.01:
        print(f"❌ depois de {epocas} épocas, ainda está {100 * (razao - 1):.1f}% acima do mínimo: a taxa é pequena demais")
    else:
        print(f"✅ certo! chegou a {100 * (razao - 1):.2f}% do mínimo")
Exercício 1 · Os gradientes
Escreva gradientes(area, preco, w, b), que devolve (dw, db): as derivadas do MSE em relação a w e a b, para o modelo previsto = w × área + b. Sem laço.
def gradientes(area, preco, w, b):
    ...  # seu código aqui


confere(gradientes(np.array([50, 100, 150]), np.array([150, 250, 300]), 2.0, 0.0), [-5000, -200 / 3])   # a tabela da seção 2
confere(gradientes(np.array([1, 2, 3]), np.array([2, 4, 6]), 2.0, 0.0), [0, 0])                         # reta perfeita: nada a corrigir
Dica
Siga a tabela da seção 2: primeiro erro = previsto - real, depois as duas médias.
Gabarito
def gradientes(area, preco, w, b):
    erro = (w * area + b) - preco
    dw = 2 * np.mean(erro * area)
    db = 2 * np.mean(erro)
    return dw, db
Exercício 2 · Voltando para a escala original
O modelo padronizado da seção 4 é , com .
Escreva voltar_escala(w_z, b_z, media, desvio), que devolve (w, b) tais que dê exatamente a mesma previsão.
def voltar_escala(w_z, b_z, media, desvio):
    ...  # seu código aqui


confere(voltar_escala(10, 300, 100, 50), [0.2, 280])
confere(voltar_escala(w_pad, b_pad, media_area, desvio_area), [lr1.coef_[0], lr1.intercept_], tolerancia=1e-4)   # tem que bater com a fórmula
Dica
Substitua o no modelo e abra a conta:
Gabarito
def voltar_escala(w_z, b_z, media, desvio):
    w = w_z / desvio
    b = b_z - w_z * media / desvio
    return w, b
Exercício 3 · O treino completo
Escreva treinar(X, y, taxa, epocas) para qualquer número de features:
wcomeça com um zero por coluna deX, ebcomeça em 0;- a cada época, guarda o MSE antes do passo numa lista
historico(entãohistorico[0]é o custo do chute inicial); - devolve
(w, b, historico).
def treinar(X, y, taxa, epocas):
    ...  # seu código aqui


resultado = treinar(Xz, preco, taxa=0.1, epocas=300)
if resultado is None:
    confere(None, None)
else:
    w, b, historico = resultado
    confere(w, lr.coef_, tolerancia=1e-4)                      # os mesmos pesos do LinearRegression
    confere(b, lr.intercept_, tolerancia=1e-4)
    confere(len(historico), 300)
    confere(historico[0], np.mean(preco ** 2))                 # com w = 0 e b = 0, o erro é -preço
Dica
É o laço da seção 5 dentro de uma função. Um peso por coluna: np.zeros(X.shape[1]).
Gabarito
def treinar(X, y, taxa, epocas):
    w = np.zeros(X.shape[1])
    b = 0.0
    historico = []
    for _ in range(epocas):
        erro = (X @ w + b) - y
        historico.append(np.mean(erro ** 2))
        w = w - taxa * (2 / len(y)) * (X.T @ erro)
        b = b - taxa * 2 * np.mean(erro)
    return w, b, historico
O _ no for _ in range(epocas) é o nome que se usa em Python para uma variável que não vai ser usada: aqui, só importa repetir.
Exercício 4 · Escolhendo a taxa de aprendizado
Com os dados padronizados (Xz), escolha uma taxa que chegue a no máximo 1% acima do mínimo em só 20 épocas, sem divergir. A conferência desenha a curva de custo com a sua taxa: experimente, olhe a curva e ajuste.
Escolher a taxa é uma das tarefas mais comuns (e mais chatas) de quem treina modelos.
taxa_escolhida = None   # troque por um número, por exemplo 0.01, e vá ajustando

confere_taxa(taxa_escolhida)
Dica
Comece com 0.01 e vá multiplicando por 3. Se divergir, volte um pouco.
Gabarito
Qualquer taxa entre uns 0,12 e uns 0,77 passa, por exemplo taxa_escolhida = 0.3.
- Abaixo disso, a bolinha ainda está descendo quando as 20 épocas acabam.
- Acima de uns 0,83, cada passo pula o fundo da tigela e cai mais alto do outro lado, como a taxa 1.05 da aula 00.05, e o custo explode.
- Entre 0,77 e 0,83, ela não explode, mas fica tanto tempo pulando de um lado pro outro que 20 épocas não bastam.
Exercício 5 (desafio) · Treino com mini-batch
Escreva treinar_minibatch(X, y, taxa, epocas, tamanho_lote, seed):
- a cada época, embaralha a ordem dos exemplos com
np.random.default_rng(seed)e percorre os lotes detamanho_loteexemplos, dando um passo por lote; - no fim de cada época, guarda em
historicoo MSE calculado com todos os exemplos; - devolve
(w, b, historico).
Como cada passo usa só um pedaço dos dados, o resultado não cai exatamente no mínimo: ele fica “tremendo” perto do fundo. Por isso, a conferência aceita uma pequena diferença.
def treinar_minibatch(X, y, taxa, epocas, tamanho_lote, seed):
    ...  # seu código aqui


resultado = treinar_minibatch(Xz, preco, taxa=0.05, epocas=50, tamanho_lote=10, seed=0)
if resultado is None:
    confere(None, None)
else:
    w, b, historico = resultado
    confere(len(historico), 50)
    confere(historico[-1], mse_minimo, tolerancia=0.02)        # até 2% acima do mínimo
    confere(w, lr.coef_, tolerancia=0.05)                       # pesos perto dos do LinearRegression
    confere(b, lr.intercept_, tolerancia=0.05)
Dica
Parta do código de mini-batch da seção 6. O MSE com todos os exemplos vai fora do laço dos lotes, no fim de cada época.
Gabarito
def treinar_minibatch(X, y, taxa, epocas, tamanho_lote, seed):
    rng = np.random.default_rng(seed)
    w = np.zeros(X.shape[1])
    b = 0.0
    historico = []
    for _ in range(epocas):
        ordem = rng.permutation(len(y))
        for inicio in range(0, len(y), tamanho_lote):
            lote = ordem[inicio:inicio + tamanho_lote]
            erro = (X[lote] @ w + b) - y[lote]
            w = w - taxa * (2 / len(lote)) * (X[lote].T @ erro)
            b = b - taxa * 2 * np.mean(erro)
        historico.append(np.mean((X @ w + b - y) ** 2))
    return w, b, historico
Resumo
| Conceito | O que é | Em código |
|---|---|---|
| gradiente do MSE | quanto o custo muda quando cada parâmetro muda | 2 * np.mean(erro * x), ou (2 / n) * (X.T @ erro) com várias features |
| passo | andar contra o gradiente | w -= taxa * dw |
| época | uma passada por todos os dados | for epoca in range(epocas): |
| taxa de aprendizado | o tamanho do passo: pequena demais é lenta, grande demais diverge | escolhida na mão (exercício 4) |
| padronizar | deixar as features na mesma escala, pro terreno virar uma tigela redonda | (X - X.mean(axis=0)) / X.std(axis=0) |
| mini-batch | estimar o gradiente com um pedaço aleatório dos dados | ordem = rng.permutation(n) e fatias de ordem |
A receita, que vale para quase todo modelo de ML: previsão → erro → custo → gradiente → passo, repetida muitas vezes.