Aula 6 de 6
Probabilidade e estatística: média, variância e distribuição normal
Objetivo: resumir dados com poucos números (média, mediana e desvio padrão), entender a distribuição normal e raciocinar sobre probabilidade simulando com NumPy, em vez de decorar fórmulas.
Por que isso importa: ML é estatística feita com computador.
- Os dados sempre têm ruído.
- Os modelos devolvem probabilidades (“87% de chance de ser um gato”).
- A padronização da aula 00.02 usa média e desvio padrão.
- As métricas que medem se um modelo é bom (precisão e recall) são probabilidades condicionais, que aparecem na seção 5.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
1. Média e mediana
O problema: uma empresa pequena tem 10 pessoas. Nove ganham entre 3 e 6 mil por mês, e o dono ganha 80 mil. Qual é o “salário típico” da empresa?
A média soma tudo e divide pela quantidade. A mediana é o valor do meio da lista ordenada; quando a quantidade é par, é a média dos dois valores do meio. Nem o JS nem o C# têm mediana pronta: você ordenaria a lista ([...salarios].sort((a, b) => a - b)) e pegaria o meio. No NumPy, é np.median.
salarios = np.array([3.0, 3.2, 3.5, 3.8, 4.0, 4.2, 4.5, 5.0, 6.0, 80.0])   # mil R$ por mês; o último é o do dono

print(f"com o dono -> média: {salarios.mean():.2f}   mediana: {np.median(salarios):.2f}")
print(f"sem o dono -> média: {salarios[:-1].mean():.2f}   mediana: {np.median(salarios[:-1]):.2f}")

# a mediana "à mão": ordenar e pegar o meio (aqui n = 10 é par, então é a média dos dois do meio)
ordenados = np.sort(salarios)
n = len(ordenados)
print(ordenados)
print((ordenados[n // 2 - 1] + ordenados[n // 2]) / 2)
com o dono -> média: 11.72 mediana: 4.10
sem o dono -> média: 4.13 mediana: 4.00
[ 3. 3.2 3.5 3.8 4. 4.2 4.5 5. 6. 80. ]
4.1| média | mediana | |
|---|---|---|
| sem o dono | 4,13 | 4,00 |
| com o dono | 11,72 | 4,10 |
Um único salário quase triplicou a média, e ninguém na empresa ganha perto de 11,72 mil. A mediana quase não se mexeu. Um valor muito fora do padrão como esse se chama outlier.
fig, ax = plt.subplots(figsize=(8, 2.5))
ax.scatter(salarios, np.zeros(len(salarios)), color=AZUL, s=60, alpha=0.7, zorder=3)
ax.axvline(salarios.mean(), color=LARANJA, linestyle="--", label=f"média = {salarios.mean():.2f}")
ax.axvline(np.median(salarios), color=VERDE, label=f"mediana = {np.median(salarios):.2f}")
ax.text(80, 0.25, "dono", ha="center")
ax.set_ylim(-1, 1)
ax.set_yticks([])                        # o eixo y não significa nada aqui
ax.set_title("Salários da empresa")
ax.set_xlabel("salário (mil R$ por mês)")
ax.legend(loc="upper center")
ax.grid(alpha=0.3)
plt.show()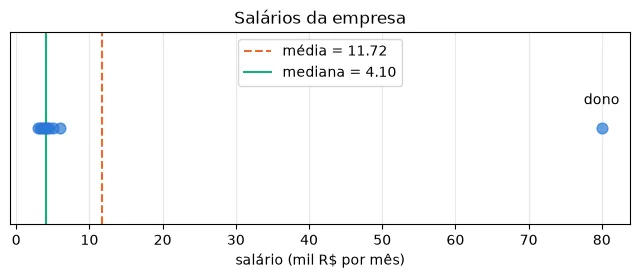
Em ML: outliers atrapalham muito os modelos treinados com erro quadrático médio. Como o erro é elevado ao quadrado, um ponto muito longe “grita” mais alto que todos os outros juntos. Por isso, olhar a média e a mediana é um dos primeiros passos pra conhecer um conjunto de dados.
2. Variância e desvio padrão: o quanto os dados se espalham
O problema: duas turmas têm média 7 na prova. Na turma A, todo mundo tirou perto de 7. Na turma B, tem nota 3 e nota 10. A média não vê diferença nenhuma. Precisamos de um número que meça o espalhamento.
Primeira tentativa: medir o quanto cada nota se afasta da média (o desvio) e tirar a média desses desvios. Olhe a turma B:
| nota | desvio (nota − 7) | desvio² |
|---|---|---|
| 3 | −4 | 16 |
| 10 | 3 | 9 |
| 5 | −2 | 4 |
| 9 | 2 | 4 |
| 8 | 1 | 1 |
| soma | 0 | 34 |
Os desvios somam zero, e isso acontece sempre, por causa da própria definição de média: os negativos cancelam os positivos. O remédio é o mesmo do erro quadrático médio da aula 00.01: elevar ao quadrado antes de tirar a média.
- Variância é a média dos desvios ao quadrado: 34 / 5 = 6,8. O problema é que a unidade dela é “nota²”, que não quer dizer nada.
- Desvio padrão é a raiz da variância: √6,8 ≈ 2,61. Ele volta pra unidade dos dados: “as notas costumam se afastar uns 2,6 pontos da média”.
( é a média, e é a letra grega sigma, o símbolo tradicional do desvio padrão.)
Em TypeScript:
const media = notas.reduce((soma, nota) => soma + nota, 0) / notas.length;
const variancia = notas.reduce((soma, nota) => soma + (nota - media) ** 2, 0) / notas.length;
const desvio = Math.sqrt(variancia);
(No C#, com LINQ, seria notas.Average() e notas.Sum(n => (n - media) * (n - media)) / notas.Length.)
Repare numa coisa: a variância é o erro quadrático médio de chutar a média pra todo mundo.
turma_a = np.array([6.5, 6.8, 7.0, 7.2, 7.5])
turma_b = np.array([3.0, 10.0, 5.0, 9.0, 8.0])

for nome, notas in [("A", turma_a), ("B", turma_b)]:
    print(f"turma {nome}: média = {notas.mean():.1f}   variância = {np.var(notas):.3f}   desvio padrão = {np.std(notas):.3f}")

# a turma B "à mão", sem laço
desvios = turma_b - turma_b.mean()
print(desvios, desvios.sum())
print(np.sqrt(np.mean(desvios ** 2)))
turma A: média = 7.0 variância = 0.116 desvio padrão = 0.341
turma B: média = 7.0 variância = 6.800 desvio padrão = 2.608
[-4. 3. -2. 2. 1.] 0.0
2.6076809620810595fig, axs = plt.subplots(2, 1, figsize=(8, 4), sharex=True) # sharex: os dois usam a mesma escala de x
for ax, nome, notas in zip(axs, ["A", "B"], [turma_a, turma_b]):
media, desvio = notas.mean(), notas.std()
ax.axvspan(media - desvio, media + desvio, color=AZUL, alpha=0.15, label="média ± 1 desvio padrão")
ax.scatter(notas, np.zeros(len(notas)), color=AZUL, s=60, zorder=3, label="notas")
ax.axvline(media, color=LARANJA, linestyle="--", label="média")
ax.set_title(f"Turma {nome}: desvio padrão = {desvio:.2f}")
ax.set_yticks([])
ax.grid(alpha=0.3)
axs[0].legend(loc="upper left")
axs[1].set_xlabel("nota")
axs[1].set_xlim(0, 10.5)
fig.tight_layout()
plt.show()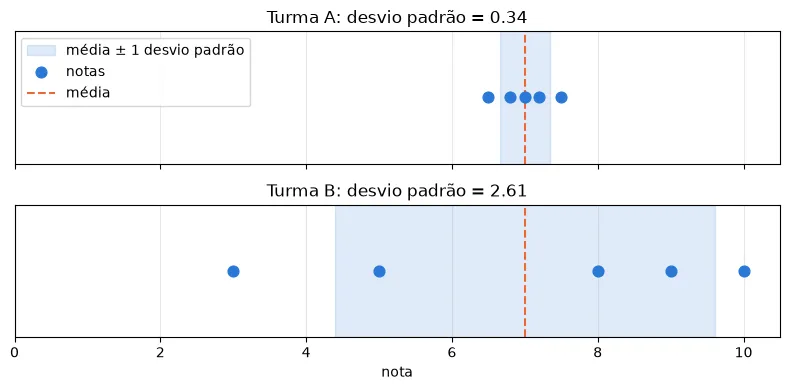
O tal do ddof: dividir por n ou por n − 1?
O np.std divide por , como na fórmula acima. Mas o Excel (DESVPAD), o pandas e muitos livros dividem por . Por quê?
- Quando os dados são tudo o que existe (a turma inteira, a população), divide-se por .
- Quando os dados são uma amostra de algo maior (50 pessoas representando uma cidade), a média também foi calculada com essa mesma amostra. Ela fica “puxada” na direção dos próprios dados, e os desvios saem um pouco menores do que os de verdade. Dividir por compensa isso.
No NumPy, o parâmetro ddof (“delta degrees of freedom”) diz quanto tirar do : np.std(x, ddof=1) divide por .
print(np.std(turma_b))           # divide por n     = 5
print(np.std(turma_b, ddof=1))   # divide por n - 1 = 4
2.6076809620810595
2.9154759474226504Com 5 notas, a diferença aparece. Com os milhares de exemplos de ML, ela some. Só lembre que ela existe quando um número seu não bater com o do Excel ou do pandas.
3. A distribuição normal
O problema: meça a altura de 10 mil pessoas e faça um histograma. Aparece o formato de sino que você viu na aula 00.03. Esse sino tem uma fórmula:
Não precisa decorar. O que importa é que ela só tem dois parâmetros:
- (mi), a média, que diz onde fica o centro do sino;
- , o desvio padrão, que diz o quanto o sino é largo.
Pra pôr a curva em cima do histograma, as escalas precisam bater. Normalmente, a altura de cada barra é uma contagem, enquanto a curva é uma densidade: a área embaixo dela toda soma 1. Com density=True, o hist divide cada contagem por (total de valores × largura da faixa), e a área das barras também passa a somar 1.
Por exemplo: com 10.000 alturas e faixas de 1 cm, uma barra com 500 pessoas fica com altura 500 / (10.000 × 1) = 0,05.
rng = np.random.default_rng(seed=0)
mu, sigma = 170, 8
alturas = rng.normal(mu, sigma, size=10_000)


def densidade_normal(x, mu, sigma):
    return 1 / (sigma * np.sqrt(2 * np.pi)) * np.exp(-(x - mu) ** 2 / (2 * sigma ** 2))


x = np.linspace(135, 205, 300)

fig, ax = plt.subplots(figsize=(7, 4))
ax.hist(alturas, bins=50, density=True, color=AZUL, alpha=0.6, edgecolor="white", label="10.000 alturas sorteadas")
ax.plot(x, densidade_normal(x, mu, sigma), color=LARANJA, linewidth=2, label="fórmula da normal")
ax.set_title(f"Distribuição normal: μ = {mu} cm, σ = {sigma} cm")
ax.set_xlabel("altura (cm)")
ax.set_ylabel("densidade")
ax.legend()
ax.grid(alpha=0.3)
plt.show()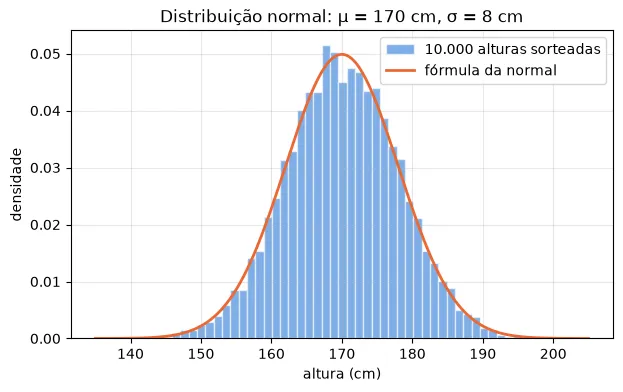
A regra 68-95-99,7
Em qualquer distribuição normal:
- cerca de 68% dos valores ficam a até 1 desvio padrão da média;
- cerca de 95% ficam a até 2 desvios padrão;
- cerca de 99,7% ficam a até 3 desvios padrão.
Nas alturas: 68% das pessoas medem entre 162 e 178 cm, e 95% medem entre 154 e 186 cm. Dá pra conferir com as alturas sorteadas usando o truque da aula 00.02: a média de uma máscara é a proporção de True.
for k in [1, 2, 3]:
    dentro = np.abs(alturas - mu) < k * sigma          # máscara: está a menos de k desvios da média?
    print(f"até {k} desvio(s) padrão: {dentro.mean():.1%}")   # :.1% formata como porcentagem com 1 casa
até 1 desvio(s) padrão: 68.2%
até 2 desvio(s) padrão: 95.5%
até 3 desvio(s) padrão: 99.8%curva = densidade_normal(x, mu, sigma)
fig, ax = plt.subplots(figsize=(7, 4))
for k, opacidade, rotulo in [(3, 0.15, "±3σ: 99,7%"), (2, 0.3, "±2σ: 95%"), (1, 0.5, "±1σ: 68%")]:
faixa = np.abs(x - mu) <= k * sigma
ax.fill_between(x, curva, where=faixa, color=AZUL, alpha=opacidade, label=rotulo) # pinta embaixo da curva
ax.plot(x, curva, color="#222222")
ax.set_title("Quanto cabe em cada faixa")
ax.set_xlabel("altura (cm)")
ax.set_ylabel("densidade")
ax.legend()
ax.grid(alpha=0.3)
plt.show()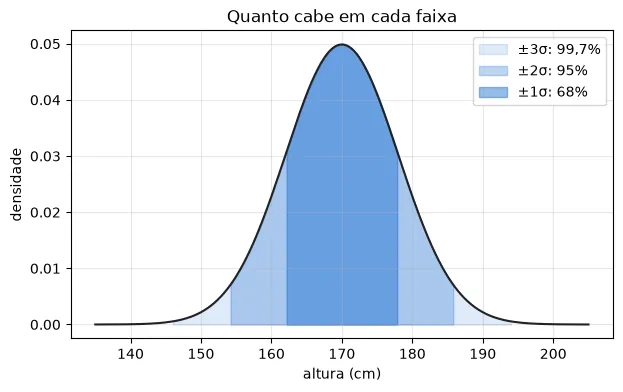
z-score: quantos desvios padrão longe da média
O problema: Ana tirou 8 numa prova em que a turma teve média 6 e desvio padrão 1. Bruno tirou 9 numa prova com média 8 e desvio padrão 1,5. Qual resultado foi mais impressionante?
Comparar 8 com 9 não faz sentido, porque as provas são diferentes. O z-score mede cada nota na “régua” da própria prova, contando quantos desvios padrão ela está acima (ou abaixo) da média:
- Ana: , ou seja, 2 desvios acima da média.
- Bruno: .
A nota 8 da Ana foi bem mais impressionante. Pela regra 68-95-99,7, só uns 2,5% da turma dela passaram de 2 desvios acima da média.
Você já usou isso: a padronização da aula 00.02, (casas - casas.mean(axis=0)) / casas.std(axis=0), calcula o z-score de cada coluna. Depois dela, toda coluna tem média 0 e desvio padrão 1, e área, quartos e preço passam a ser comparáveis.
print("Ana:  ", (8 - 6) / 1)
print("Bruno:", (9 - 8) / 1.5)

altura = 186
print("z de 186 cm:", (altura - mu) / sigma)
print(f"fração das alturas sorteadas acima de 186 cm: {np.mean(alturas > altura):.1%}")
Ana: 2.0
Bruno: 0.6666666666666666
z de 186 cm: 2.0
fração das alturas sorteadas acima de 186 cm: 2.2%4. Probabilidade como frequência (e o poder de simular)
O problema: o que quer dizer “a chance de dar cara é 1/2”? Uma resposta prática é: se você jogar a moeda muitas vezes, a fração de caras chega cada vez mais perto de 1/2.
Essa leitura dá um super poder: quando a conta é difícil, simule um milhão de vezes e conte. Com NumPy, um milhão de lançamentos leva milissegundos. Essa técnica se chama método de Monte Carlo, em homenagem ao cassino.
rng = np.random.default_rng(seed=1)

moedas = rng.integers(0, 2, size=10)    # 0 = coroa, 1 = cara (o 2 não entra, como no range)
print(moedas, "-> fração de caras:", moedas.mean())

milhao = rng.integers(0, 2, size=1_000_000)
print("com 1 milhão de lançamentos:", milhao.mean())
[0 1 1 1 0 0 1 1 0 0] -> fração de caras: 0.5
com 1 milhão de lançamentos: 0.499956Com 10 lançamentos, a fração pode sair bem longe de 0,5. Com um milhão, fica colada. Isso se chama lei dos grandes números.
Pra ver a fração “convergindo” ao longo dos lançamentos, precisamos da fração acumulada: depois de 1 lançamento, de 2, de 3… O np.cumsum faz a soma acumulada, o total corrente que em TS você faria com um laço (soma += x; acumulado.push(soma);):
| lançamento | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| resultado | 1 | 0 | 1 | 1 |
np.cumsum |
1 | 1 | 2 | 3 |
| ÷ nº de lançamentos | 1,00 | 0,50 | 0,67 | 0,75 |
print(np.cumsum([1, 0, 1, 1]) / np.arange(1, 5))

n = 10_000
lancamento = np.arange(1, n + 1)

fig, ax = plt.subplots(figsize=(8, 4))
for semente, cor in zip([10, 20, 30], [AZUL, LARANJA, VERDE]):
    moedas = np.random.default_rng(seed=semente).integers(0, 2, size=n)
    ax.plot(lancamento, np.cumsum(moedas) / lancamento, color=cor, label=f"sequência {semente // 10}")
ax.axhline(0.5, color="gray", linestyle="--", label="1/2")
ax.set_xscale("log")    # escala logarítmica: cada marca do eixo é 10 vezes a anterior
ax.set_title("A fração de caras converge para 1/2")
ax.set_xlabel("número de lançamentos (escala log)")
ax.set_ylabel("fração de caras até ali")
ax.legend()
ax.grid(alpha=0.3)
plt.show()
[1. 0.5 0.66666667 0.75 ]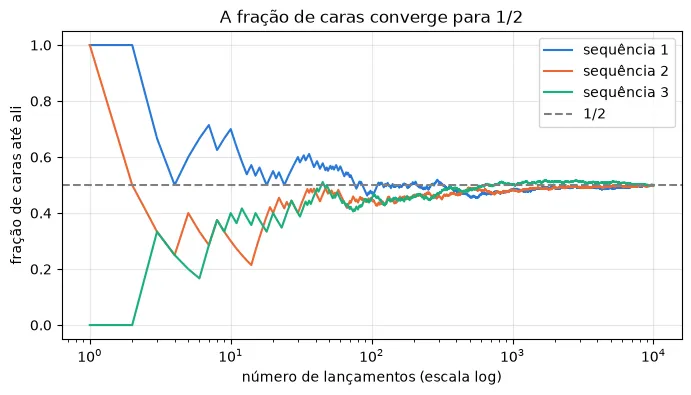
A escala logarítmica espreme o eixo x: o trecho de 1 a 10 lançamentos ocupa o mesmo espaço que o de 1.000 a 10.000. Assim dá pra ver o começo bagunçado e o final estável no mesmo gráfico.
Dois dados: simular × contar
O problema: jogando dois dados, qual soma é a mais provável?
Contando: são 6 × 6 = 36 combinações igualmente prováveis. Pra montar todas, o meshgrid da aula 00.03 serve direitinho. A soma 7 aparece de 6 jeitos (1+6, 2+5, …, 6+1), então a chance é 6/36 ≈ 16,7%.
Simulando: jogue um milhão de pares e conte.
Pra contar quantas vezes cada soma aparece, use o np.bincount. É o contador que em TS você faria com contagem[valor] = (contagem[valor] ?? 0) + 1, só que guardado num array: o índice é o valor, e o conteúdo é quantas vezes ele apareceu. np.bincount([2, 3, 3, 5]) dá [0, 0, 1, 2, 0, 1]: o 3 apareceu 2 vezes e o 5 apareceu 1.
# contando: todas as 36 combinações
d1, d2 = np.meshgrid(np.arange(1, 7), np.arange(1, 7))
somas_possiveis = (d1 + d2).ravel()                         # ravel() "achata" a tabela 6x6 numa lista de 36
exato = np.bincount(somas_possiveis, minlength=13) / 36     # minlength: garante as posições de 0 a 12

# simulando: um milhão de pares de dados
rng = np.random.default_rng(seed=2)
somas = rng.integers(1, 7, size=1_000_000) + rng.integers(1, 7, size=1_000_000)
simulado = np.bincount(somas, minlength=13) / len(somas)

valores = np.arange(2, 13)
fig, ax = plt.subplots(figsize=(7, 4))
ax.bar(valores, simulado[2:], color=AZUL, alpha=0.7, label="simulação (1 milhão)")
ax.plot(valores, exato[2:], "o", color=LARANJA, markersize=8, label="contagem exata")
ax.set_xticks(valores)
ax.set_title("Soma de dois dados")
ax.set_xlabel("soma")
ax.set_ylabel("probabilidade")
ax.legend()
ax.grid(alpha=0.3)
plt.show()

print(f"P(soma = 7): exata {exato[7]:.4f}, simulada {simulado[7]:.4f}")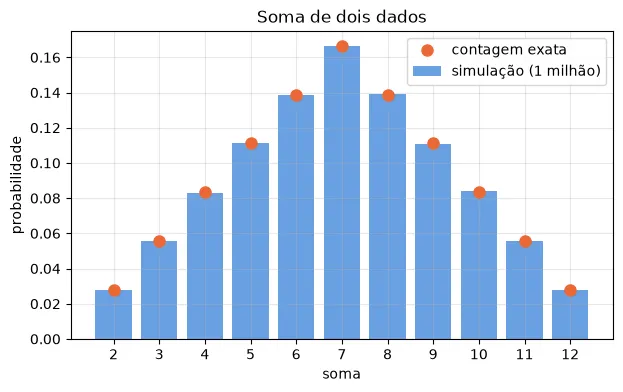
P(soma = 7): exata 0.1667, simulada 0.16625. Probabilidade condicional e o teorema de Bayes
O problema: uma doença atinge 1 em cada 1.000 pessoas. Existe um exame que acerta 99% das vezes: em quem está doente, dá positivo 99% das vezes, e em quem está saudável, dá negativo 99% das vezes. O seu exame deu positivo. Qual a chance de você estar doente?
A maioria das pessoas responde 99%. A resposta certa é uns 9%.
Contando: imagine 100.000 pessoas fazendo o exame.
- 100 estão doentes (1 em 1.000). Dessas, 99 dão positivo.
- 99.900 estão saudáveis. Dessas, 1% dá positivo por engano: 999 pessoas.
| positivo | negativo | total | |
|---|---|---|---|
| doente | 99 | 1 | 100 |
| saudável | 999 | 98.901 | 99.900 |
| total | 1.098 | 98.902 | 100.000 |
Dos 1.098 positivos, só 99 estão doentes: 99 / 1.098 ≈ 9%. Como a doença é rara, os poucos erros do exame entre a multidão de saudáveis são muito mais numerosos que os doentes de verdade.
Notação: se lê “probabilidade de A dado que B aconteceu”. Pra calcular, você olha só os casos em que B aconteceu. Aqui, olha só a coluna “positivo”.
O teorema de Bayes é essa mesma conta da tabela, escrita em fórmula:
Em cima ficam os “positivos doentes”; embaixo, todos os positivos.
# simulando 1 milhão de pessoas
rng = np.random.default_rng(seed=3)
n = 1_000_000

# rng.random(n) faz n sorteios entre 0 e 1, como chamar o Math.random() do JS n vezes.
# Um sorteio fica abaixo de 0.001 em 0,1% das vezes: é o jeito padrão de simular "acontece com probabilidade p".
doente = rng.random(n) < 0.001
positivo = np.where(doente,
                    rng.random(n) < 0.99,     # doente: dá positivo em 99% das vezes
                    rng.random(n) < 0.01)     # saudável: dá positivo (por engano) em 1% das vezes

print("pessoas doentes:     ", doente.sum())
print("exames positivos:    ", positivo.sum())
print(f"P(doente dado positivo) = {doente[positivo].mean():.1%}")   # a máscara faz o "dado que": só os positivos
pessoas doentes: 973
exames positivos: 10701
P(doente dado positivo) = 9.0%Repare no doente[positivo]: filtrar com uma máscara (aula 00.02) é exatamente o “dado que”. Primeiro você fica só com os positivos e depois vê que fração deles está doente.
Isso volta na disciplina 01. Trocando “exame” por “modelo”:
- precisão = dos casos que o modelo chamou de positivos, quantos eram mesmo: , que aqui é 9%;
- recall = dos positivos de verdade, quantos o modelo pegou: , que aqui é 99%.
Esse exame tem recall ótimo e precisão péssima. Um modelo pode “acertar 99%” e mesmo assim ser inútil, dependendo de qual pergunta você faz.
6. Bônus: por que o sino aparece em todo lugar
O problema: um dado tem distribuição plana, já que cada face tem 1/6 de chance. Então por que tanta coisa no mundo (altura, erro de medida, notas) tem formato de sino?
Veja o que acontece quando somamos vários dados:
rng = np.random.default_rng(seed=4)

fig, axs = plt.subplots(1, 3, figsize=(13, 3.8))
for ax, k, titulo in zip(axs, [1, 2, 10], ["1 dado", "soma de 2 dados", "soma de 10 dados"]):
    somas = rng.integers(1, 7, size=(100_000, k)).sum(axis=1)   # k dados por linha; soma cada linha
    faixas = np.arange(k, 6 * k + 2) - 0.5                       # uma faixa centrada em cada soma possível
    ax.hist(somas, bins=faixas, density=True, color=AZUL, edgecolor="white")
    ax.set_title(titulo)
    ax.set_xlabel("soma")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("proporção")
fig.tight_layout()
plt.show()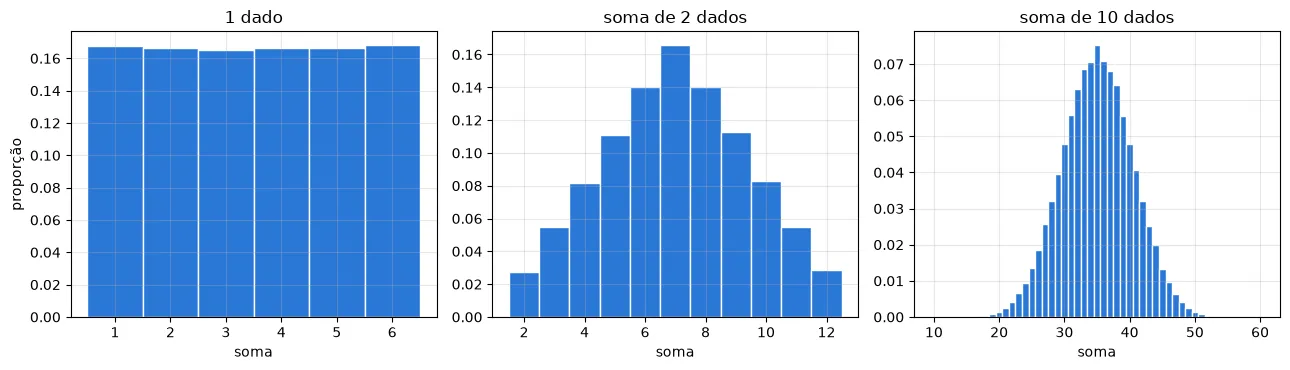
Com 1 dado, o histograma é plano; com 2, vira um triângulo; com 10, já é um sino. Isso é o teorema central do limite: somas (e médias) de muitas coisas independentes tendem à distribuição normal, qualquer que seja a distribuição de cada uma.
A altura de uma pessoa é a soma de muitos pequenos efeitos (genes, alimentação…), e um erro de medida é a soma de muitas pequenas perturbações. Por isso o sino aparece em todo canto.
7. Correlação: duas variáveis andam juntas?
O problema: quem estuda mais tira nota maior? Queremos um número que diga se duas variáveis sobem e descem juntas.
A correlação () vai de −1 a 1:
- perto de 1: quando uma sobe, a outra sobe;
- perto de −1: quando uma sobe, a outra desce;
- perto de 0: não há relação em linha reta.
No NumPy, np.corrcoef(x, y) devolve uma matriz 2×2 com a correlação de cada variável com cada uma: [[x com x, x com y], [y com x, y com y]]. A diagonal é sempre 1 (qualquer variável tem correlação perfeita consigo mesma), então o número que interessa é o [0, 1].
rng = np.random.default_rng(seed=5)
n = 60

horas = rng.uniform(0, 10, n)
nota = 0.6 * horas + 3 + rng.normal(0, 1, n)

idade_carro = rng.uniform(0, 15, n)
preco_carro = 80 - 4 * idade_carro + rng.normal(0, 8, n)

altura = rng.normal(170, 8, n)
nota_2 = rng.normal(7, 1.5, n)

print(np.corrcoef(horas, nota))    # a matriz 2x2 inteira, só pra ver

pares = [
    (horas, nota, "horas de estudo", "nota"),
    (idade_carro, preco_carro, "idade do carro (anos)", "preço (mil R$)"),
    (altura, nota_2, "altura (cm)", "nota"),
]

fig, axs = plt.subplots(1, 3, figsize=(13, 3.8))
for ax, (x, y, nome_x, nome_y) in zip(axs, pares):
    r = np.corrcoef(x, y)[0, 1]
    ax.scatter(x, y, color=AZUL, alpha=0.7)
    ax.set_title(f"r = {r:.2f}")
    ax.set_xlabel(nome_x)
    ax.set_ylabel(nome_y)
    ax.grid(alpha=0.3)
fig.tight_layout()
plt.show()
[[1. 0.91003146]
[0.91003146 1. ]]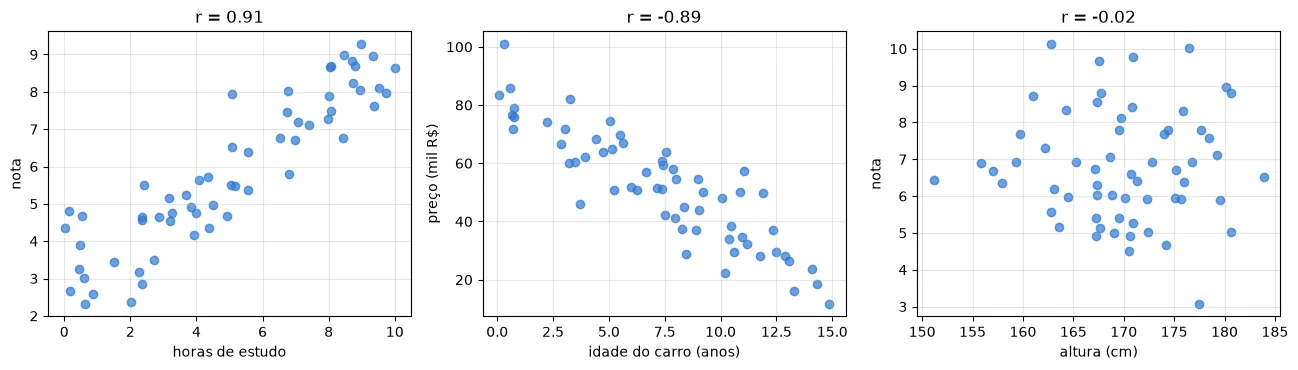
Dois cuidados:
- Correlação não é causalidade. A venda de sorvete e os afogamentos têm correlação positiva, mas o sorvete não afoga ninguém: os dois sobem no verão. Um modelo de ML aprende correlações, e cabe a você não ler causa onde só existe coincidência.
- A correlação só enxerga relação em linha reta. Na célula abaixo, depende totalmente de , mas a correlação dá zero, porque metade da curva desce e metade sobe.
x = np.linspace(-3, 3, 101)
print(f"{np.corrcoef(x, x ** 2)[0, 1]:.3f}") # "-0.000" é só o zero com sinal, coisa de float (aula 00.02)-0.000Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado, tolerancia=1e-6):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido, dtype=float), np.asarray(esperado, dtype=float)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado, rtol=0, atol=tolerancia):
        print("✅ certo!")
    else:
        print(f"❌ esperado (± {tolerancia}):\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Média e desvio padrão à mão
Escreva media_e_desvio(valores), que devolve a média e o desvio padrão (dividindo por ) sem usar np.mean, np.std nem np.var. Pode usar np.sum, len e np.sqrt.
def media_e_desvio(valores):
    ...  # seu código aqui


confere(media_e_desvio(np.array([3, 10, 5, 9, 8])), (7, np.sqrt(6.8)))    # a turma B da seção 2
confere(media_e_desvio(np.array([2, 4, 4, 4, 5, 5, 7, 9])), (5, 2))
Dica
Primeiro a média. Depois, os desvios (valores - media, vetorizado), o quadrado deles, a média dos quadrados e a raiz. Para devolver os dois valores, use return media, desvio (aula 00.01).
Gabarito
def media_e_desvio(valores):
    n = len(valores)
    media = np.sum(valores) / n
    desvio = np.sqrt(np.sum((valores - media) ** 2) / n)
    return media, desvio
Exercício 2 · Padronização (z-score)
Escreva padronizar(valores), que devolve o z-score de cada valor: quantos desvios padrão ele está da média do próprio array. Aqui pode usar .mean() e .std().
def padronizar(valores):
    ...  # seu código aqui


confere(padronizar(np.array([2, 4, 4, 4, 5, 5, 7, 9])), [-1.5, -0.5, -0.5, -0.5, 0, 0, 1, 2])
confere(padronizar(np.array([10, 20, 30, 40])), np.array([-15, -5, 5, 15]) / np.sqrt(125))
Dica
É a fórmula aplicada no array inteiro de uma vez, com broadcasting.
Gabarito
def padronizar(valores):
    return (valores - valores.mean()) / valores.std()
Exercício 3 · Monte Carlo: pelo menos um 6 em 4 lançamentos
Qual a chance de sair pelo menos um 6 em 4 lançamentos de um dado? Responda simulando: escreva chance_de_um_seis(n_jogos, rng), que joga n_jogos partidas de 4 lançamentos e devolve a fração de partidas com pelo menos um 6. Sem laço!
Esse problema tem história. No século XVII, o apostador francês Chevalier de Méré apostava nele. As dúvidas dele sobre apostas com dados chegaram a Pascal, que discutiu o assunto em cartas com Fermat, e essas cartas são consideradas o início da teoria da probabilidade.
def chance_de_um_seis(n_jogos, rng):
    ...  # seu código aqui


estimativa = chance_de_um_seis(1_000_000, np.random.default_rng(seed=7))
confere(estimativa, 1 - (5 / 6) ** 4, tolerancia=0.005)

if estimativa is not None:
    print(f"simulação: {estimativa:.4f}   conta exata: {1 - (5 / 6) ** 4:.4f}")
Dica
Sorteie uma matriz com uma linha por partida e 4 colunas: rng.integers(1, 7, size=(n_jogos, 4)). Compare com 6 pra ter uma máscara. Pra saber se alguma coluna de cada linha é True, use .any(axis=1), que é o .some() do JS (no C#, o Any() do LINQ). Por fim, a média da máscara dá a fração.
Gabarito
def chance_de_um_seis(n_jogos, rng):
    lancamentos = rng.integers(1, 7, size=(n_jogos, 4))   # uma linha por jogo, 4 lançamentos em cada
    return (lancamentos == 6).any(axis=1).mean()
E a conta exata? Pense no contrário: a chance de nenhum 6 num lançamento é 5/6, e em 4 lançamentos independentes é . Então a chance de pelo menos um 6 é , um pouquinho acima de 50%. Era isso que dava vantagem ao Chevalier.
Exercício 4 · Bayes: o exame médico com outros números
Generalize a conta da seção 5. Escreva prob_doente_dado_positivo(prevalencia, sensibilidade, especificidade):
| termo | significado | na seção 5 |
|---|---|---|
| prevalência | fração da população que tem a doença | 0,001 |
| sensibilidade | chance de dar positivo quando a pessoa está doente | 0,99 |
| especificidade | chance de dar negativo quando a pessoa está saudável | 0,99 |
def prob_doente_dado_positivo(prevalencia, sensibilidade, especificidade):
    ...  # seu código aqui


confere(prob_doente_dado_positivo(0.001, 0.99, 0.99), 99 / 1098)    # o caso da seção 5
confere(prob_doente_dado_positivo(0.1, 0.9, 0.95), 2 / 3)           # doença mais comum
confere(prob_doente_dado_positivo(0.5, 0.99, 0.99), 0.99)           # metade da população doente
# 🧪 E se a pessoa fizer um SEGUNDO exame, e ele também der positivo?
# A chance "antes" do segundo exame não é mais 1 em 1.000: é o resultado do primeiro.
if prob_doente_dado_positivo(0.001, 0.99, 0.99) is not None:
depois_do_primeiro = prob_doente_dado_positivo(0.001, 0.99, 0.99)
depois_do_segundo = prob_doente_dado_positivo(depois_do_primeiro, 0.99, 0.99)
print(f"depois de 1 positivo: {depois_do_primeiro:.1%} depois de 2 positivos: {depois_do_segundo:.1%}")depois de 1 positivo: 9.0% depois de 2 positivos: 90.7%Dica
Monte a tabela da seção 5 pra uma pessoa, com frações no lugar de contagens:
- doente e positivo = prevalência × sensibilidade;
- saudável e positivo = (1 − prevalência) × (1 − especificidade).
A resposta é “doente e positivo” dividido por “todos os positivos”.
Gabarito
def prob_doente_dado_positivo(prevalencia, sensibilidade, especificidade):
    positivo_e_doente = sensibilidade * prevalencia
    positivo_e_saudavel = (1 - especificidade) * (1 - prevalencia)
    return positivo_e_doente / (positivo_e_doente + positivo_e_saudavel)
Repare como a resposta depende da prevalência: o mesmo exame vale muito mais quando a doença é comum. E um segundo positivo leva a chance de 9% para uns 91%. É por isso que exames de triagem costumam ser confirmados com um segundo exame.
Exercício 5 (desafio) · Correlação à mão
Escreva correlacao(x, y) sem usar np.corrcoef. Uma fórmula que funciona: a correlação é a média dos produtos dos z-scores.
Por que isso funciona? Quando os dois estão acima da média ao mesmo tempo (os dois z positivos) ou abaixo ao mesmo tempo (os dois negativos), o produto é positivo. Quando um está acima e o outro abaixo, o produto é negativo. A média desses produtos diz qual caso domina.
def correlacao(x, y):
    ...  # seu código aqui


x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])
confere(correlacao(x, y), np.corrcoef(x, y)[0, 1])    # tem que bater com o NumPy
confere(correlacao(x, 3 * x + 1), 1)                  # reta subindo: correlação perfeita
confere(correlacao(x, -2 * x), -1)                    # reta descendo: correlação perfeita negativa
Dica
Calcule o z-score de x e de y (a mesma conta do exercício 2), multiplique elemento a elemento e tire a média.
Gabarito
def correlacao(x, y):
    zx = (x - x.mean()) / x.std()
    zy = (y - y.mean()) / y.std()
    return np.mean(zx * zy)
Outro jeito, com a aula 00.04: a correlação é a similaridade de cosseno entre os vetores centralizados (cada um menos a própria média).
def correlacao(x, y):
    xc, yc = x - x.mean(), y - y.mean()
    return (xc @ yc) / (np.linalg.norm(xc) * np.linalg.norm(yc))
Dois vetores que “apontam na mesma direção” são duas variáveis que sobem e descem juntas.
Resumo
| Conceito | O que mede | NumPy |
|---|---|---|
| média | o centro (sensível a outliers) | np.mean(x) |
| mediana | o valor do meio (resiste a outliers) | np.median(x) |
| variância | a média dos desvios ao quadrado | np.var(x) |
| desvio padrão | o espalhamento, na unidade dos dados | np.std(x) (ddof=1 para amostra) |
| z-score | quantos desvios padrão longe da média | (x - x.mean()) / x.std() |
| probabilidade | a frequência em muitas repetições | simular e fazer np.mean(condicao) |
| P(A dado B) | a frequência de A só entre os casos de B | a[b].mean(), com máscaras |
| correlação | o quanto duas variáveis andam juntas, em linha reta | np.corrcoef(x, y)[0, 1] |
Regra 68-95-99,7: numa distribuição normal, 68% dos valores ficam a até 1 desvio padrão da média, 95% a até 2 e 99,7% a até 3.
Fim da disciplina 00! 🎉
Com Python, NumPy, gráficos, álgebra linear, cálculo e estatística em dia, a base está pronta.