Aula 5 de 6
Cálculo: derivada, derivada parcial e gradiente
Objetivo: relembrar a derivada como inclinação, revisar as regras que importam (principalmente a regra da cadeia) e chegar no gradiente, o vetor que diz para onde uma função sobe mais rápido.
Por que isso importa: treinar um modelo é minimizar a função de custo. Pra isso é preciso saber, para cada peso, se aumentá-lo faz o erro subir ou descer, e isso é uma derivada.
- O gradiente descendente, que treina quase todo modelo de ML, é “dar passinhos contra o gradiente”.
- O backpropagation, que calcula esse gradiente numa rede neural, é a regra da cadeia aplicada camada por camada.
Esta aula é a matemática de “descer a ladeira”.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"
1. Derivada = inclinação
O problema: você está numa trilha de montanha, com tanta neblina que não enxerga nada, e quer chegar no vale. A única informação que você tem é a inclinação do chão sob os pés. Se o chão desce pra direita, você anda pra direita. Essa inclinação é a derivada.
Como medir a inclinação num ponto ? Dê um passinho pra frente e veja quanto mudou. É a velha “subida sobre avanço”:
Quanto menor o , melhor a aproximação. A derivada “de verdade” é o limite disso quando .
Em TypeScript, recebendo a função como parâmetro:
const derivadaAprox = (f: (x: number) => number, x: number, h: number) =>
    (f(x + h) - f(x)) / h;
Em Python é igual: uma função é um valor como outro qualquer e pode ser passada como argumento. No C#, seria um parâmetro do tipo Func<double, double>.
def quadrado(x):
    return x ** 2


def derivada_aprox(f, x, h):
    return (f(x + h) - f(x)) / h      # "subida" dividida pelo "avanço"


# a derivada de x² é 2x; então, em x = 3, a inclinação deve ser 6
for h in [1, 0.1, 0.01, 0.001]:
    print(f"h = {h}: inclinação ≈ {derivada_aprox(quadrado, 3, h):.4f}")
h = 1: inclinação ≈ 7.0000
h = 0.1: inclinação ≈ 6.1000
h = 0.01: inclinação ≈ 6.0100
h = 0.001: inclinação ≈ 6.0010Com o resultado sai 7, com sai 6.1, e ele vai se aproximando de 6. No gráfico: a reta que passa por dois pontos da curva (a secante) vai virando a reta que só encosta na curva (a tangente). A inclinação da tangente é a derivada.
x0 = 1                                  # o ponto onde queremos a inclinação
x = np.linspace(-0.5, 3.5, 200)
tangente = quadrado(x0) + 2 * x0 * (x - x0)     # reta que passa em (1, 1) com inclinação f'(1) = 2

fig, axs = plt.subplots(1, 3, figsize=(13, 4))
for ax, h in zip(axs, [2, 1, 0.3]):
    inclinacao = derivada_aprox(quadrado, x0, h)
    secante = quadrado(x0) + inclinacao * (x - x0)

    ax.plot(x, quadrado(x), color="gray", label="f(x) = x²")
    ax.plot(x, secante, color=AZUL, label="secante")
    ax.plot(x, tangente, color=LARANJA, linestyle="--", label="tangente")
    ax.plot([x0, x0 + h], [quadrado(x0), quadrado(x0 + h)], "o", color=AZUL)   # os dois pontos da secante
    ax.set_ylim(-1, 10)
    ax.set_title(f"h = {h}: inclinação da secante = {inclinacao:.1f}")
    ax.set_xlabel("x")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("f(x)")
axs[0].legend(loc="upper left")
fig.tight_layout()
plt.show()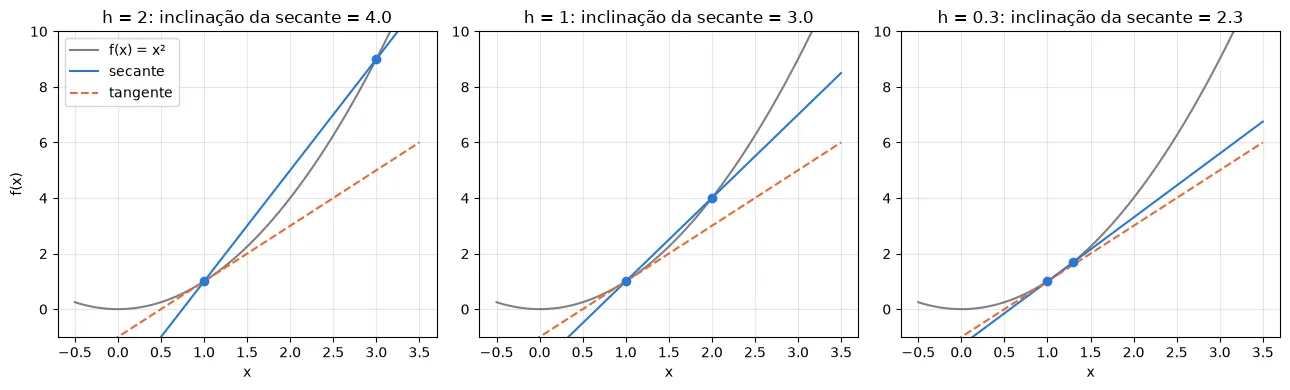
E se o for minúsculo? Também estraga, por causa do float (lembra do 0.1 + 0.2 da aula 00.01?). Um float64 guarda uns 16 dígitos significativos, então 3 + 1e-20 é arredondado de volta pra 3. O number do JS/TS é esse mesmo float64, e lá 3 + 1e-20 === 3 também dá true. (1e-20 é notação científica, , igual no JS.)
print(3 + 1e-20 == 3)                        # True: a diferença some no arredondamento
print(derivada_aprox(quadrado, 3, 1e-20))    # 0.0 -> "inclinação zero", o que está errado
True
0.0Na prática, usa-se um pequeno, mas não pequeno demais: algo como 1e-5. No exercício 1 você vai escrever uma versão mais precisa dessa conta.
2. As regras que importam
A derivada numérica sempre funciona, mas é aproximada e cara: cada derivada custa duas chamadas de , e uma rede neural tem milhões de pesos. As regras de derivação dão a fórmula exata. As que você vai usar:
| Função | Derivada | Exemplo |
|---|---|---|
| constante | ||
| potência | ||
| número vezes função, | ||
| soma, | ||
| exponencial | é a única função que é a própria derivada |
Não acredite, confira. A derivada numérica é ótima pra testar uma fórmula feita à mão:
x0 = 1.5
h = 1e-6

# (nome, função, derivada pela regra)
regras = [
    ("x³  ->  3x²",         lambda x: x ** 3,          lambda x: 3 * x ** 2),
    ("4x²  ->  8x",         lambda x: 4 * x ** 2,      lambda x: 8 * x),
    ("x² + 3x  ->  2x + 3", lambda x: x ** 2 + 3 * x,  lambda x: 2 * x + 3),
    ("eˣ  ->  eˣ",          lambda x: np.exp(x),       lambda x: np.exp(x)),
]

for nome, funcao, derivada in regras:
    # {nome:22} ocupa 22 caracteres, pra alinhar as colunas
    print(f"{nome:22} numérica: {derivada_aprox(funcao, x0, h):8.4f}   pela regra: {derivada(x0):8.4f}")
x³ -> 3x² numérica: 6.7500 pela regra: 6.7500
4x² -> 8x numérica: 12.0000 pela regra: 12.0000
x² + 3x -> 2x + 3 numérica: 6.0000 pela regra: 6.0000
eˣ -> eˣ numérica: 4.4817 pela regra: 4.4817Regra da cadeia: a mais importante pra ML
O problema: e quando uma função está dentro de outra? Por exemplo, . Dá pra expandir o quadrado, mas numa rede neural são dezenas de funções encaixadas, e expandir não é opção.
A regra da cadeia diz: derive a função de fora (mantendo a de dentro intacta) e multiplique pela derivada da de dentro.
| Parte | Função | Derivada |
|---|---|---|
| de dentro | ||
| de fora | ||
| juntando |
Intuição de engenharia: engrenagens. Se a engrenagem gira 3 vezes mais rápido que , e gira vezes mais rápido que , então gira vezes mais rápido que . As taxas se multiplicam ao longo da cadeia.
Por que isso importa: uma rede neural é uma cadeia: entrada → camada 1 → camada 2 → … → custo. Pra saber como o custo muda quando se mexe num peso lá da camada 1, multiplicam-se as taxas de todas as camadas no caminho. O backpropagation é exatamente isso, feito de trás pra frente.
def encaixada(x):
    return (3 * x + 1) ** 2


def encaixada_linha(x):
    return 2 * (3 * x + 1) * 3      # regra da cadeia: (derivada de fora) × (derivada de dentro)


for x0 in [0, 1, 2]:
    print(f"x = {x0}: numérica {derivada_aprox(encaixada, x0, 1e-6):.4f}   regra da cadeia {encaixada_linha(x0):.4f}")
x = 0: numérica 6.0000 regra da cadeia 6.0000
x = 1: numérica 24.0000 regra da cadeia 24.0000
x = 2: numérica 42.0000 regra da cadeia 42.00003. Derivada e mínimo
Lembra do exercício 4 da aula 00.03? Ele desenhou ao lado da derivada, . Onde a função tem o ponto mais baixo (), a derivada vale zero: no fundo do vale, o chão é plano.
E o sinal da derivada diz pra que lado ir:
| Onde | O chão… | Pra descer, ande pra… | |
|---|---|---|---|
| negativa | desce pra direita | direita ( aumenta) | |
| zero | é plano | lugar nenhum: é o mínimo | |
| positiva | sobe pra direita | esquerda ( diminui) |
Nos dois casos, a regra é a mesma: ande no sentido contrário ao sinal da derivada. Essa é a ideia inteira da próxima seção.
def custo(x):
    return (x - 2) ** 2


def custo_linha(x):
    return 2 * (x - 2)


x = np.linspace(-0.5, 4.5, 200)

fig, ax = plt.subplots(figsize=(7, 4.5))
ax.plot(x, custo(x), color=AZUL, label="f(x) = (x - 2)²")
for i, x0 in enumerate([0.5, 2, 3.5]):
    trecho = np.linspace(x0 - 0.6, x0 + 0.6, 2)
    ax.plot(trecho, custo(x0) + custo_linha(x0) * (trecho - x0), color=LARANJA, linewidth=2.5,
            label="inclinação (tangente)" if i == 0 else None)    # só um item na legenda
    ax.plot(x0, custo(x0), "o", color=LARANJA)
    if x0 < 2:      # rótulo do lado de fora da curva, pra não encostar na tangente
        ax.text(x0 - 0.3, custo(x0) - 0.3, f"f'({x0}) = {custo_linha(x0):.0f}", ha="right", fontsize=11)
    elif x0 > 2:
        ax.text(x0 + 0.3, custo(x0) - 0.3, f"f'({x0}) = {custo_linha(x0):.0f}", ha="left", fontsize=11)
    else:
        ax.text(x0, custo(x0) - 0.9, f"f'({x0}) = {custo_linha(x0):.0f}", ha="center", fontsize=11)
ax.set_ylim(-1.5, 7)
ax.set_title("O sinal da derivada diz pra que lado o chão desce")
ax.set_xlabel("x")
ax.set_ylabel("f(x)")
ax.legend()
ax.grid(alpha=0.3)
plt.show()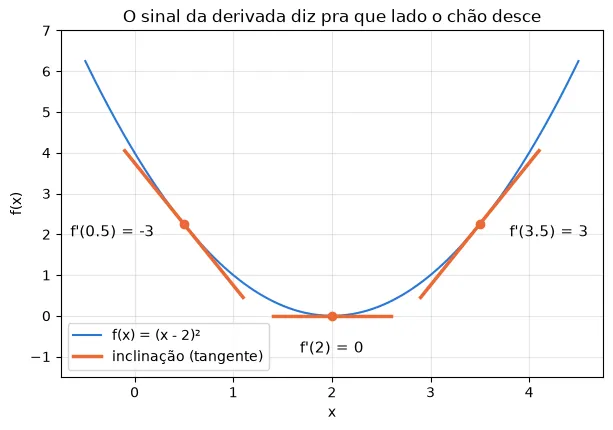
4. Gradiente descendente em 1D (só a ideia)
O problema: achar o que minimiza . Aqui daria pra resolver na mão, mas com um modelo de milhões de pesos isso é impossível. A saída é começar num ponto qualquer e repetir: dar um passinho contra a derivada.
Em TypeScript:
let x = -1;
for (let passo = 0; passo < 20; passo++)
x = x - taxa * custoLinha(x);- Por que o menos? Se (o chão sobe pra direita), diminui. Se , aumenta. É a tabela da seção 3.
- A taxa de aprendizado (learning rate) controla o tamanho do passo.
- Perto do mínimo, a derivada fica pequena, e os passos encolhem sozinhos.
x = -1.0
taxa = 0.1
historico = [x]

for passo in range(20):
    x = x - taxa * custo_linha(x)
    historico.append(x)

print("primeiros passos:", np.round(historico[:6], 3))
print("depois de 20 passos:", round(historico[-1], 4))
primeiros passos: [-1. -0.4 0.08 0.464 0.771 1.017]
depois de 20 passos: 1.9654A taxa é o parâmetro mais importante desse algoritmo. Veja três escolhas, 10 passos cada, saindo de :
def descer(x, taxa, passos):
    historico = [x]
    for _ in range(passos):          # "_" é o nome convencional pra variável que não vai ser usada
        x = x - taxa * custo_linha(x)
        historico.append(x)
    return np.array(historico)


casos = [(0.05, "pequena: lenta"), (0.3, "boa"), (1.05, "grande demais: diverge")]

fig, axs = plt.subplots(1, 3, figsize=(14, 4))
for ax, (taxa, descricao) in zip(axs, casos):
    caminho = descer(-1.0, taxa, 10)
    limite = max(4.5, np.abs(caminho - 2).max() + 2.5)       # o gráfico da divergência precisa de mais espaço
    x = np.linspace(2 - limite, 2 + limite, 300)

    ax.plot(x, custo(x), color=AZUL, label="f(x)")
    ax.plot(caminho, custo(caminho), color=LARANJA, marker="o", markersize=5, label="passos")
    ax.plot(caminho[0], custo(caminho[0]), "o", color="black", markersize=7, label="início")
    ax.set_title(f"taxa = {taxa} ({descricao})\nx final = {caminho[-1]:.2f}")
    ax.set_xlabel("x")
    ax.grid(alpha=0.3)
axs[0].set_ylabel("f(x)")
axs[0].legend(loc="upper center")
fig.tight_layout()
plt.show()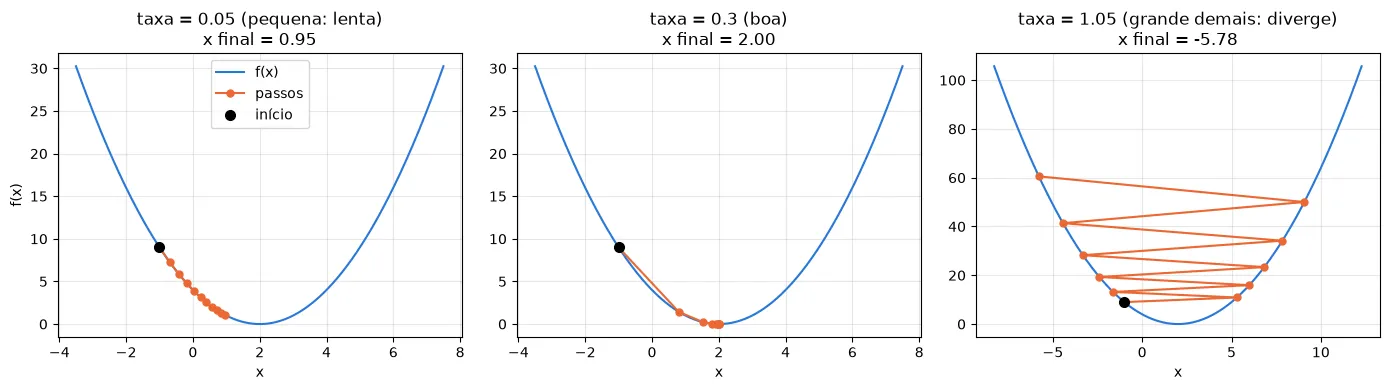
- Taxa pequena: anda na direção certa, mas devagar demais. Em 10 passos ainda está longe.
- Taxa boa: chega perto do mínimo em poucos passos.
- Taxa grande demais: cada passo passa do mínimo e cai do outro lado, mais alto do que estava. O fica pulando de um lado pro outro e se afasta cada vez mais.
🧪 Experimente taxa = 1.0 no descer: o fica pulando entre −1 e 5 pra sempre.
A disciplina 01 aprofunda tudo isso: como aplicar em modelos de verdade, como escolher a taxa e quando parar.
5. Derivada parcial
O problema: funções de custo de verdade dependem de vários números. Pegue o terreno do exercício 5 da aula 00.03:
Qual é a “inclinação” num ponto? Depende da direção em que você anda! Numa montanha, andar pro leste pode ser subida leve, e andar pro norte, uma ribanceira.
A derivada parcial em , escrita , é a inclinação quando você anda só na direção . Pra calcular, finja que é uma constante e derive normalmente:
| Derivada parcial | Como pensar | Resultado |
|---|---|---|
| fixo, então é constante e sua derivada é 0 | ||
| fixo, então é constante |
Em TypeScript, é a derivada numérica mexendo só um dos argumentos:
const parcialX = (f: (x: number, y: number) => number, x: number, y: number, h: number) =>
    (f(x + h, y) - f(x, y)) / h;     // o y não muda
def terreno(x, y):
return (x - 1) ** 2 + 2 * (y + 1) ** 2
x0, y0 = 2.5, 0.0
h = 1e-6
parcial_x = (terreno(x0 + h, y0) - terreno(x0, y0)) / h # só o x anda
parcial_y = (terreno(x0, y0 + h) - terreno(x0, y0)) / h # só o y anda
print(f"∂f/∂x ≈ {parcial_x:.4f} (fórmula 2(x - 1) = {2 * (x0 - 1)})")
print(f"∂f/∂y ≈ {parcial_y:.4f} (fórmula 4(y + 1) = {4 * (y0 + 1)})")∂f/∂x ≈ 3.0000 (fórmula 2(x - 1) = 3.0)
∂f/∂y ≈ 4.0000 (fórmula 4(y + 1) = 4.0)Visualmente: fixar é como cortar o terreno com uma parede vertical ao longo da linha . O perfil do corte é uma curva comum de uma variável, , e a inclinação dessa curva é a derivada parcial em .
x = np.linspace(-3, 3, 200)
y = np.linspace(-3, 3, 200)
X, Y = np.meshgrid(x, y)

fig, axs = plt.subplots(1, 2, figsize=(11, 4.5))

# esquerda: o terreno visto de cima, com a linha do corte
mapa = axs[0].contourf(X, Y, terreno(X, Y), levels=20, cmap="Blues")
fig.colorbar(mapa, ax=axs[0], label="f(x, y)")
axs[0].axhline(0, color=LARANJA, linewidth=2.5, label="corte em y = 0")
axs[0].plot(x0, y0, "o", color="black")
axs[0].set_title("O terreno visto de cima")
axs[0].set_xlabel("x")
axs[0].set_ylabel("y")
axs[0].set_aspect("equal")
axs[0].legend(loc="upper left")

# direita: o perfil do corte, com a tangente em x = 2.5
corte = terreno(x, 0)
axs[1].plot(x, corte, color=AZUL, label="perfil: f(x, 0)")
trecho = np.linspace(x0 - 1, x0 + 1, 2)
axs[1].plot(trecho, terreno(x0, 0) + parcial_x * (trecho - x0), color=LARANJA, linestyle="--",
            label=f"inclinação ∂f/∂x = {parcial_x:.1f}")
axs[1].plot(x0, terreno(x0, 0), "o", color="black")
axs[1].set_title("O perfil do corte")
axs[1].set_xlabel("x")
axs[1].set_ylabel("f(x, 0)")
axs[1].legend(loc="upper center")
axs[1].grid(alpha=0.3)

fig.tight_layout()
plt.show()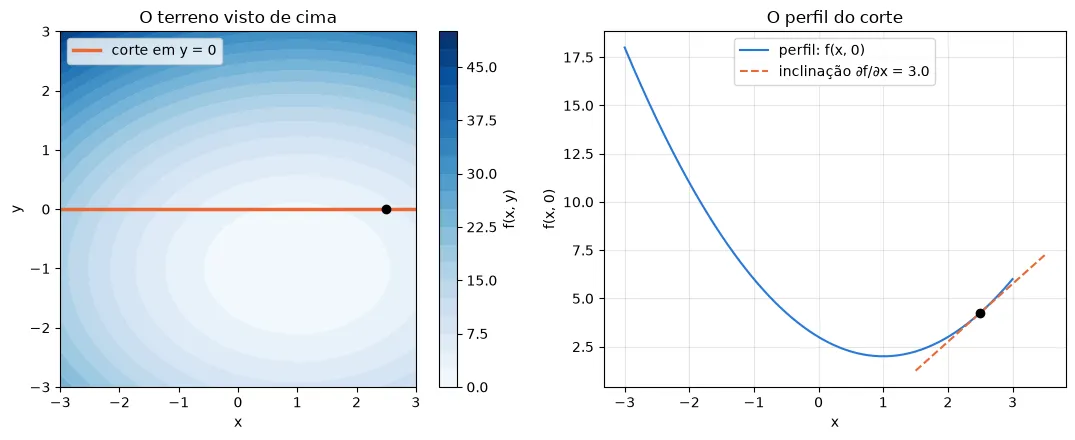
6. Gradiente: a flecha que aponta pra subida
Junte as derivadas parciais num vetor e você tem o gradiente, escrito :
No ponto do nosso terreno, .
A propriedade que torna o gradiente tão útil (fica sem demonstração): ele aponta na direção de subida mais íngreme, e o tamanho dele (a norma da aula 00.04) diz o quão íngreme é. Então aponta pra descida mais íngreme. É daí que vem o nome gradiente descendente.
Pra quem já leu mapa topográfico: a subida mais íngreme cruza as curvas de nível em ângulo reto. As setas abaixo mostram exatamente isso.
def gradiente(x, y):
    return np.array([2 * (x - 1), 4 * (y + 1)])     # (∂f/∂x, ∂f/∂y)


# uma grade grossa de pontos, onde as setas vão nascer
xs = np.linspace(-3, 3, 9)
Xs, Ys = np.meshgrid(xs, xs)
U, V = -gradiente(Xs, Ys)            # componentes das setas: MENOS o gradiente (descida)
tamanho = np.sqrt(U ** 2 + V ** 2)
U, V = U / tamanho * 0.45, V / tamanho * 0.45     # vetor unitário (aula 00.04) × 0.45: só a direção importa

fig, ax = plt.subplots(figsize=(6, 5))
mapa = ax.contourf(X, Y, terreno(X, Y), levels=20, cmap="Blues")
fig.colorbar(mapa, ax=ax, label="f(x, y)")
ax.quiver(Xs, Ys, U, V, angles="xy", scale_units="xy", scale=1, color="#222222")
ax.plot(1, -1, marker="*", markersize=16, color=LARANJA, linestyle="none", label="mínimo")
ax.set_title("Setas: −gradiente (a direção de descida)")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_aspect("equal")
ax.legend(loc="upper left")
plt.show()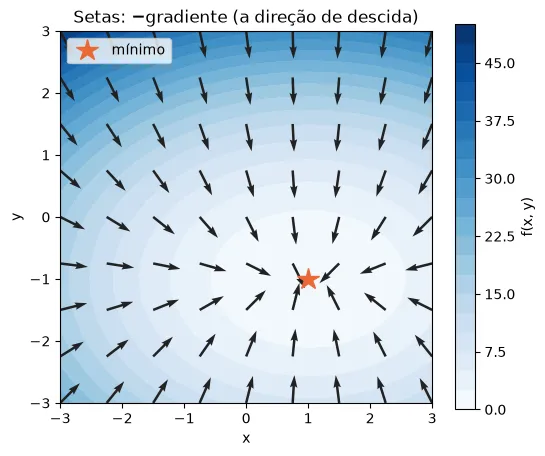
Os argumentos do quiver (“aljava”, o estojo de flechas):
Xs, Ys: onde cada seta nasce, uma por ponto da grade (omeshgridda aula 00.03).U, V: as componentes de cada seta, quanto ela anda em e quanto anda em .angles="xy", scale_units="xy", scale=1: “desenhe as setas nas unidades dos eixos, sem reescalar”. Sem isso, o matplotlib escolhe uma escala por conta própria, e as setas ficam com um tamanho que não tem relação com o gráfico.
Normalizamos as setas pra todas terem o mesmo tamanho, porque aqui só interessa a direção. Repare que perto da estrela elas apontam pra ela, e que todas cruzam as curvas de nível em ângulo reto.
A bolinha descendo até a estrela
Na aula 00.03 ficou a promessa: o gradiente descendente é uma bolinha que desce até a estrela. É a mesma regra do 1D, agora com vetores (soma e escalar da aula 00.04):
ponto = np.array([-2.5, 2.0])
taxa = 0.1
caminho = [ponto]

for passo in range(30):
    ponto = ponto - taxa * gradiente(ponto[0], ponto[1])    # a mesma regra do 1D, agora com vetores
    caminho.append(ponto)

caminho = np.array(caminho)     # (31, 2): uma linha por posição da bolinha
print("início:", caminho[0], "| fim:", np.round(caminho[-1], 3))

fig, ax = plt.subplots(figsize=(6, 5))
mapa = ax.contourf(X, Y, terreno(X, Y), levels=20, cmap="Blues")
fig.colorbar(mapa, ax=ax, label="f(x, y)")
ax.plot(caminho[:, 0], caminho[:, 1], color=LARANJA, marker="o", markersize=4, label="caminho")
ax.plot(caminho[0, 0], caminho[0, 1], "o", color="black", markersize=8, label="início")
ax.plot(1, -1, marker="*", markersize=16, color="black", linestyle="none", label="mínimo")
ax.set_title("Gradiente descendente em 2D")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_aspect("equal")
ax.legend(loc="upper right")
plt.show()
início: [-2.5 2. ] | fim: [ 0.996 -1. ]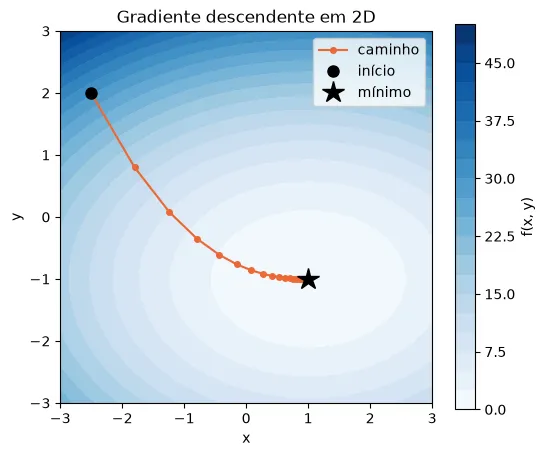
O caminho faz uma curva: no começo, a bolinha desce mais na direção , que é a mais íngreme (lembre do “2” na frente do ), e depois corrige o .
Em ML: e são os pesos do modelo, e é a função de custo. Com um milhão de pesos, o gradiente é um vetor de um milhão de derivadas parciais. Ninguém calcula isso na mão: o PyTorch calcula automaticamente (o autograd da disciplina 02) usando… a regra da cadeia.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Derivada numérica mais precisa
A fórmula da seção 1 olha só pra frente ( e ). Uma versão bem mais precisa olha pros dois lados e divide pela distância total, :
É a diferença central. Escreva derivada_numerica(f, x, h=1e-5).
def derivada_numerica(f, x, h=1e-5):
    ...  # seu código aqui


confere(derivada_numerica(lambda x: x ** 3, 2), 12)    # 3x² em x = 2
confere(derivada_numerica(np.sin, 0), 1)                # a derivada do seno é o cosseno, e cos(0) = 1
confere(derivada_numerica(np.exp, 1), np.e)             # eˣ é a própria derivada
Dica
É uma linha, igual à derivada_aprox da seção 1, só que com no lugar de e embaixo.
Gabarito
def derivada_numerica(f, x, h=1e-5):
    return (f(x + h) - f(x - h)) / (2 * h)
Por que é mais precisa? Na versão só pra frente, o erro diminui na proporção de . Na central, os erros dos dois lados se cancelam quase todos, e o erro cai na proporção de . Com , isso é a diferença entre errar na 5ª casa decimal e errar na 10ª.
Exercício 2 · Regra da cadeia na mão
Derive no papel a função
usando a regra da cadeia, e escreva a fórmula em g_linha(x). Depois o código confere pra você.
def g(x):
    return (x ** 2 + 1) ** 3


def g_linha(x):
    ...  # seu código aqui


confere(g_linha(0), 0)
confere(g_linha(1), 24)
confere(g_linha(2), 300)
confere(g_linha(-1), -24)

# Bônus: se você fez o exercício 1, compare a sua fórmula com a derivada numérica
if derivada_numerica(g, 1.5) is not None and g_linha(1.5) is not None:
    print(f"em x = 1.5: numérica {derivada_numerica(g, 1.5):.6f} | sua fórmula {g_linha(1.5):.6f}")
Dica
Monte a tabela da seção 2: de dentro, , com derivada ; de fora, , com derivada . Depois multiplique as duas.
Gabarito
def g_linha(x):
    return 3 * (x ** 2 + 1) ** 2 * (2 * x)    # de fora: 3u²; de dentro: 2x
Exercício 3 · Gradiente numérico
Escreva gradiente_numerico(f, ponto, h=1e-5). A função f recebe um array (o ponto, com quantas coordenadas for) e devolve um número. O resultado deve ser o array das derivadas parciais, uma por coordenada, calculadas pela diferença central do exercício 1.
Pra coordenada : mexa só a coordenada do ponto, e , e mantenha as outras paradas.
def gradiente_numerico(f, ponto, h=1e-5):
    ...  # seu código aqui


# o terreno da seção 5, agora recebendo o ponto como array: em (2.5, 0), o gradiente é (3, 4)
confere(gradiente_numerico(lambda p: (p[0] - 1) ** 2 + 2 * (p[1] + 1) ** 2, np.array([2.5, 0.0])), [3, 4])

# f(x, y) = x·y: ∂f/∂x = y e ∂f/∂y = x
confere(gradiente_numerico(lambda p: p[0] * p[1], np.array([2.0, 3.0])), [3, 2])

# em 3 dimensões: f = x² + y² + z², gradiente = (2x, 2y, 2z)
confere(gradiente_numerico(lambda p: np.sum(p ** 2), np.array([1.0, 2.0, 3.0])), [2, 4, 6])
Dica
np.eye(n) cria a matriz identidade : a linha tem um 1 só na posição . Então np.eye(n) * h dá, em cada linha, “um passinho só na coordenada ”. Some e subtraia cada linha do ponto.
Um laço (ou list comprehension) sobre as coordenadas é aceitável aqui.
⚠️ Se você preferir copiar o ponto e mudar uma coordenada, converta antes pra float (np.asarray(ponto, dtype=float)). Num array de inteiros, p[0] += 0.00001 é truncado e não muda nada!
Gabarito
def gradiente_numerico(f, ponto, h=1e-5):
    ponto = np.asarray(ponto, dtype=float)
    passos = np.eye(len(ponto)) * h     # linha i: um passinho h só na coordenada i
    return np.array([(f(ponto + e) - f(ponto - e)) / (2 * h) for e in passos])
Exercício 4 · Gradiente descendente em 1D
Escreva descida_1d(derivada, x_inicial, taxa, passos). Ela aplica passos vezes a regra e devolve o histórico: a lista com todos os valores de , incluindo o inicial (então passos + 1 valores).
O último teste acha o mínimo de , que não dá pra achar de cabeça. A derivada já vem pronta.
def descida_1d(derivada, x_inicial, taxa, passos):
    ...  # seu código aqui


# f(x) = (x - 2)², a mesma da seção 4
confere(descida_1d(lambda x: 2 * (x - 2), -1.0, 0.1, 3), [-1.0, -0.4, 0.08, 0.464])

# depois de 100 passos, tem que estar no mínimo, x = 2
historico = descida_1d(lambda x: 2 * (x - 2), -1.0, 0.1, 100)
confere(None if historico is None else historico[-1], 2)

# f(x) = x⁴ - 3x³ + 2, com derivada 4x³ - 9x²
historico = descida_1d(lambda x: 4 * x ** 3 - 9 * x ** 2, 4.0, 0.01, 500)
confere(None if historico is None else historico[-1], 2.25)
Dica
É o laço da seção 4 dentro de uma função. Comece a lista com o x_inicial e faça append depois de cada passo.
Gabarito
def descida_1d(derivada, x_inicial, taxa, passos):
    x = x_inicial
    historico = [x]
    for _ in range(passos):
        x = x - taxa * derivada(x)
        historico.append(x)
    return historico
Conferindo o último teste na mão: vale zero em , e é lá que o algoritmo chegou sozinho.
Exercício 5 (desafio) · O vale estreito
Escreva descida_2d(gradiente, inicio, taxa, passos), a versão 2D do exercício 4. A função gradiente recebe um ponto (array) e devolve o vetor gradiente. O resultado é um array (passos + 1, 2), com uma linha por posição.
O terreno do teste é um vale estreito: . O pesa 10 vezes mais que o .
def grad_vale(p):
    # gradiente de f(x, y) = x² + 10y²
    return np.array([2 * p[0], 20 * p[1]])


def descida_2d(gradiente, inicio, taxa, passos):
    ...  # seu código aqui


confere(descida_2d(grad_vale, np.array([-4.0, 1.0]), 0.09, 2),
        [[-4.0, 1.0], [-3.28, -0.8], [-2.6896, 0.64]])
# Depois de acertar, rode esta célula pra ver o caminho no vale estreito
caminho = descida_2d(grad_vale, np.array([-4.0, 1.0]), 0.09, 30)
if caminho is not None:
x = np.linspace(-5, 5, 300)
y = np.linspace(-1.5, 1.5, 200)
X, Y = np.meshgrid(x, y)
fig, ax = plt.subplots(figsize=(10, 3.8))
mapa = ax.contourf(X, Y, X ** 2 + 10 * Y ** 2, levels=20, cmap="Blues")
fig.colorbar(mapa, ax=ax, label="f(x, y)", shrink=0.75) # shrink: barra de cores mais curta, da altura do mapa
ax.plot(caminho[:, 0], caminho[:, 1], color=LARANJA, marker="o", markersize=4, label="caminho")
ax.plot(0, 0, marker="*", markersize=16, color="black", linestyle="none", label="mínimo")
ax.set_title("Gradiente descendente num vale estreito: f(x, y) = x² + 10y²")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_aspect("equal")
ax.legend(loc="lower right")
plt.show()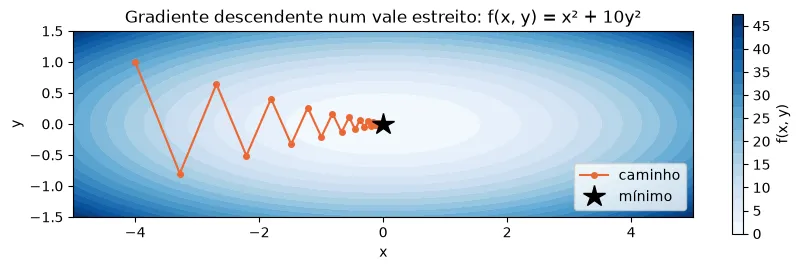
O zigue-zague: num vale estreito, o gradiente aponta pra parede do vale, e não pro mínimo. A taxa precisa ser grande pro andar num ritmo razoável, mas aí o passa do ponto a cada passo e pula de uma parede pra outra.
🧪 Experimente taxa = 0.11 no gráfico: o passa a pular cada vez mais alto e o caminho diverge.
É por isso que existem otimizadores mais espertos, como o momentum e o Adam (disciplina 02). É também um dos motivos pra normalizar os dados (exercício 3 da aula 00.01): com as features na mesma escala, o vale fica mais “redondo” e a descida anda reto.
Dica
É o exercício 4 com vetores: comece com ponto = np.asarray(inicio, dtype=float), guarde cada ponto numa lista e, no fim, converta com np.array(lista).
Gabarito
def descida_2d(gradiente, inicio, taxa, passos):
    ponto = np.asarray(inicio, dtype=float)
    caminho = [ponto]
    for _ in range(passos):
        ponto = ponto - taxa * gradiente(ponto)
        caminho.append(ponto)
    return np.array(caminho)
Resumo
| Conceito | O que é | Em código | Em ML |
|---|---|---|---|
| derivada | a inclinação da função num ponto | (f(x + h) - f(x - h)) / (2 * h) |
pra que lado mexer um peso |
| regras | potência, constante, soma, | derivadas exatas e baratas | |
| regra da cadeia | função encaixada: as taxas se multiplicam | 2 * (3 * x + 1) * 3 |
backpropagation |
| mínimo | onde a derivada vale zero | o melhor modelo | |
| gradiente descendente | passos contra a derivada | x = x - taxa * derivada(x) |
treinar o modelo |
| taxa de aprendizado | o tamanho do passo | pequena: lenta; grande: diverge | o hiperparâmetro mais importante |
| derivada parcial | inclinação numa direção, com as outras variáveis fixas | mexer só uma coordenada | o efeito de um peso só |
| gradiente | o vetor das derivadas parciais: aponta pra subida mais íngreme | np.array([df_dx, df_dy]) |
o que o PyTorch calcula (autograd) |