Aula 2 de 6
NumPy: pensar em arrays, não em laços
Objetivo: entender por que todo código de ML usa NumPy e aprender a trocar laços for por operações no array inteiro.
Por que isso importa: PyTorch, OpenCV, scikit-learn e pandas conversam com NumPy (e o PyTorch copia a interface dele quase igual). Uma imagem da webcam é um array NumPy. O que você aprender aqui vale pro resto do curso.
1. O problema: listas são lentas pra fazer conta
Numa lista do Python, cada número é um objeto separado na memória, e a lista guarda só referências para eles. É como um List<object> do C#, com boxing em todo elemento. Além disso, o laço for é interpretado passo a passo.
Um array NumPy é como um double[] do C# ou um Float64Array do JS: um bloco contínuo de memória, com todos os elementos do mesmo tipo. As operações rodam em código C compilado, numa chamada só.
import time
import numpy as np

n = 1_000_000                  # o "_" é só separador visual (C# e JS também aceitam)
lista = list(range(n))
arr = np.arange(n)             # o "range" do NumPy

inicio = time.perf_counter()   # cronômetro (C#: Stopwatch)
soma_lista = sum([x * x for x in lista])
tempo_lista = time.perf_counter() - inicio

inicio = time.perf_counter()
soma_arr = np.sum(arr * arr)
tempo_arr = time.perf_counter() - inicio

print(f"lista: {tempo_lista * 1000:.1f} ms")
print(f"NumPy: {tempo_arr * 1000:.1f} ms")
print(f"NumPy foi {tempo_lista / tempo_arr:.0f}x mais rápido. Mesmo resultado? {soma_lista == soma_arr}")
lista: 47.0 ms
NumPy: 1.9 ms
NumPy foi 24x mais rápido. Mesmo resultado? TrueIsso é vetorização: você escreve a operação para o array inteiro (arr * arr) e o laço acontece dentro do NumPy, em C.
Em ML você lida com milhões de números. Uma única foto colorida de 640×480 da webcam já tem 921.600 deles. Essa diferença é o que separa “roda em 1 segundo” de “roda em 1 minuto”.
Por que tanta diferença?
Primeiro, um detalhe: a lista do Python não é uma linked list. Ela é um array dinâmico, como o List<T> do C#. A diferença está no que fica dentro do array:
lista Python:  [ ref | ref | ref | ref | ... ]   cada ref aponta pra um objeto int
                  ↓     ↓     ↓     ↓            (28 bytes cada, em outro lugar da memória)
                 (0)   (1)   (2)   (3)

array NumPy:   [ 0 | 1 | 2 | 3 | ... ]           os números "crus", 8 bytes cada, lado a lado
São duas causas somadas:
- Disposição na memória (vale pra qualquer linguagem). Com os números lado a lado, o processador lê tudo em sequência e aproveita o cache, em vez de pular de ponteiro em ponteiro. No C# a diferença é a mesma entre
List<object>com boxing eint[]. - O laço roda fora do interpretador (peculiaridade do Python). Em C e C#, o compilador (ou o JIT) transforma o
forem código de máquina. No Python, cada volta do laço passa pelo interpretador: ele descobre o tipo dex, procura como multiplicar esse tipo e cria um objeto novo pro resultado, um milhão de vezes. Com NumPy,arr * arré uma chamada só, e o laço acontece em C compilado, podendo usar instruções que processam vários números de uma vez (SIMD).
A prova de que o principal é o laço, e não só a estrutura de dados: um for do Python em cima de um array NumPy fica ainda mais lento que na lista. A cada volta, o NumPy precisa “embrulhar” o número cru num objeto Python.
import sys

print(sys.getsizeof(12345), "bytes: um int do Python (o objeto inteiro)")
print(arr.itemsize, "bytes: um número dentro do array NumPy")

inicio = time.perf_counter()
soma = sum([x * x for x in arr])     # laço do Python, mas em cima do ARRAY
tempo_laco_array = time.perf_counter() - inicio

print(f"laço Python na lista:        {tempo_lista * 1000:6.1f} ms")
print(f"laço Python no array NumPy:  {tempo_laco_array * 1000:6.1f} ms  <- o array sozinho não ajuda!")
print(f"NumPy vetorizado:            {tempo_arr * 1000:6.1f} ms")
28 bytes: um int do Python (o objeto inteiro)
8 bytes: um número dentro do array NumPy
laço Python na lista: 47.0 ms
laço Python no array NumPy: 64.2 ms <- o array sozinho não ajuda!
NumPy vetorizado: 1.9 msE em C ou C#, essa diferença existe?
Fizemos a mesma conta em C, compilado com gcc -O2, na mesma máquina (soma dos quadrados de 1 milhão de números):
| Versão | Tempo |
|---|---|
C, array cru (long[]) |
0,65 ms |
| NumPy vetorizado | 1,9 ms |
| C, array de ponteiros pra números (em ordem na memória) | 3,8 ms |
| C, array de ponteiros (espalhados na memória) | 9,2 ms |
Python, laço for na lista |
59 ms |
- A disposição na memória pesa até em C: um array de ponteiros é 6 a 14 vezes mais lento que o array cru. Em C#, você escolhe o
int[]sem nem pensar, por causa da tipagem estática. No Python, a lista sempre guarda ponteiros. - O interpretador soma mais uns 15x: compare o Python com a linha de ponteiros em ordem.
- O NumPy fica a uns 3x do C puro. Essa diferença existe porque
arr * arrcria um array temporário e depois soma, ou seja, passa duas vezes pelos dados. A proposta do NumPy é essa: velocidade quase de C, escrevendo em Python.
Então por que ML usa Python, se ele é lento? Porque o Python é o maestro, e não quem toca os instrumentos. Uma linha como modelo(quadro), num script de visão computacional, dispara milhões de operações em C++ e CUDA dentro do PyTorch. O Python gasta uma fração mínima do tempo e entra com o que tem de bom: notebooks, experimentação rápida e um ecossistema enorme. O PyTorch leva a mesma ideia à GPU, dividindo cada operação vetorizada entre milhares de núcleos. Quem pensa vetorizado em NumPy já pensa do jeito que a GPU precisa.
2. Criando arrays
a = np.array([1, 2, 3, 4])        # a partir de uma lista
print(a, a.dtype, a.shape)        # dtype = tipo dos elementos; shape = formato

b = np.array([1, 2, 3.5])         # um float "contamina" o resto: tudo vira float
print(b, b.dtype)

print(np.zeros(3))                # [0. 0. 0.]
print(np.ones(3))                 # [1. 1. 1.]
print(np.arange(0, 10, 2))        # igual ao range: [início, fim), com passo
print(np.linspace(0, 1, 5))       # 5 pontos igualmente espaçados de 0 a 1, com o 1 INCLUÍDO
[1 2 3 4] int64 (4,)
[1. 2. 3.5] float64
[0. 0. 0.]
[1. 1. 1.]
[0 2 4 6 8]
[0. 0.25 0.5 0.75 1. ]- Tipo único: ao contrário da lista, todos os elementos do array têm o mesmo tipo (
dtype). É isso que permite guardar tudo num bloco só. arange×linspace: oarangesegue a regra dorange, e o fim não entra. Olinspaceé a exceção, por um bom motivo: ele serve pra dividir um intervalo em N pontos (pra desenhar um gráfico de 0 a 1, por exemplo), e aí as duas pontas importam.float64×float32: o padrão do NumPy éfloat64(odoubledo C#). GPUs trabalham comfloat32(ofloat), por isso você vai ver muitodtype=np.float32em código de ML.
rng = np.random.default_rng(seed=42)   # gerador de aleatórios (C#: new Random(42))
print(rng.random(3))                   # 3 números entre 0 e 1
print(rng.integers(1, 7, size=5))      # 5 lançamentos de dado (o 7 não entra!)
print(rng.normal(0, 1, size=3))        # 3 sorteios da distribuição normal (tema da aula 00.06)
[0.77395605 0.43887844 0.85859792]
[1 5 2 1 4]
[ 0.1278404 -0.31624259 -0.01680116]A seed faz a sequência “aleatória” sair sempre igual. Em ML isso é importante pra conseguir repetir um experimento e comparar resultados.
3. Operações elemento a elemento
Entre arrays, os operadores agem elemento a elemento. Cuidado: com listas, os mesmos operadores fazem outra coisa!
a = np.array([1, 2, 3])
b = np.array([10, 20, 30])

print(a + b)         # [11 22 33]
print(a * b)         # [10 40 90] -> multiplica par a par
print(a * 2)         # [2 4 6]
print(a ** 2)        # [1 4 9]
print(np.sqrt(b))    # as funções do NumPy também agem em cada elemento
print(a > 1)         # [False  True  True] -> comparação também!

# ⚠️ com LISTAS, os mesmos operadores têm outro significado:
print([1, 2, 3] * 2)             # [1, 2, 3, 1, 2, 3] -> repete a lista
print([1, 2, 3] + [10, 20, 30])  # concatena
[11 22 33]
[10 40 90]
[2 4 6]
[1 4 9]
[3.16227766 4.47213595 5.47722558]
[False True True]
[1, 2, 3, 1, 2, 3]
[1, 2, 3, 10, 20, 30]4. Agregações
notas = np.array([7.5, 8.0, 6.5, 9.0, 10.0])

print(notas.sum(), notas.mean(), notas.min(), notas.max())
print(notas.std())       # desvio padrão: o quanto os valores se espalham (aula 00.06)
print(notas.argmax())    # o ÍNDICE do maior valor -> 4
print(np.mean(notas))    # também existe como função: np.mean(x) é o mesmo que x.mean()
41.0 8.2 6.5 10.0
1.2083045973594573
4
8.2O argmax parece bobo, mas é assim que um classificador decide. A rede devolve uma pontuação pra cada classe, por exemplo [0.1, 0.7, 0.2] para gato, cachorro e pássaro, e o argmax diz qual classe ganhou (a 1, cachorro).
5. Arrays 2D: tabelas
A maioria dos dados de ML é uma tabela: cada linha é um exemplo (uma casa, um paciente, uma foto) e cada coluna é uma característica, que em ML se chama feature. Em NumPy, isso é um array 2D.
# 4 casas; colunas: área (m²), quartos, preço (mil R$)
casas = np.array([
    [ 50, 1, 200],
    [ 80, 2, 350],
    [120, 3, 500],
    [ 65, 2, 280],
])

print(casas.shape)    # (4, 3) -> 4 linhas, 3 colunas
print(casas.ndim)     # 2 dimensões
print(casas[1, 2])    # linha 1, coluna 2 -> 350
(4, 3)
2
350Repare no casas[1, 2], com vírgula: é a mesma sintaxe da matriz int[,] do C#. Numa lista de listas você escreveria casas[1][2]. Isso também funciona no NumPy, mas é mais lento e não permite as fatias da próxima seção.
Para mudar o formato sem mudar os dados, use reshape:
v = np.arange(12)
print(v)

m = v.reshape(3, 4)      # os mesmos 12 números, agora em 3 linhas e 4 colunas
print(m)

print(v.reshape(2, -1))  # -1 = "calcule pra mim": 12 / 2 = 6 colunas
[ 0 1 2 3 4 5 6 7 8 9 10 11]
[[ 0 1 2 3]
[ 4 5 6 7]
[ 8 9 10 11]]
[[ 0 1 2 3 4 5]
[ 6 7 8 9 10 11]]6. Fatiamento, agora em várias dimensões
Revisão rápida: as regras do fatiamento
Duas dúvidas comuns sobre fatiamento: por que [1:4] não inclui o 4, e como [::-1] inverte a lista. Aqui o fatiamento vira ferramenta do dia a dia, então vale entender a regra.
O fim não entra, e C# e JS fazem igual. a[1..4] no C# 8+ e a.slice(1, 4) no JS também param antes do 4. É a mesma ideia do for (int i = 0; i < n; i++), em que o < deixa o n de fora. Esse formato tem duas vantagens:
- o tamanho da fatia é simplesmente
fim - início; a[:k]ea[k:]se encaixam sem sobrar nem repetir nada. É assim que se separam os dados de treino e de teste, sem pensar em +1 ou −1.
Modelo mental: os números são cortes entre os elementos, e não os elementos em si. a[1:4] é “o que está entre o corte 1 e o corte 4”.
   | 0 | 10 | 20 | 30 | 40 | 50 |
   0   1    2    3    4    5    6
  -6  -5   -4   -3   -2   -1
O passo. A forma completa é [início:fim:passo], e deixar uma parte vazia significa “use o padrão”. Com passo negativo os padrões se invertem: a fatia começa no último elemento e vai até antes do primeiro. Por isso [::-1] significa “tudo, de trás pra frente”. É o for (int i = n - 1; i >= 0; i--) em quatro caracteres.
a = np.array([0, 10, 20, 30, 40, 50])

print(a[1:4], "-> tamanho", len(a[1:4]), "= 4 - 1")
print(a[:3], a[3:], "-> se encaixam sem sobrar nem repetir")
print(a[::2])      # de 2 em 2
print(a[4:1:-1])   # do índice 4 até ANTES do 1, andando pra trás
print(a[::-1])     # tudo, de trás pra frente
[10 20 30] -> tamanho 3 = 4 - 1
[ 0 10 20] [30 40 50] -> se encaixam sem sobrar nem repetir
[ 0 20 40]
[40 30 20]
[50 40 30 20 10 0]# 🧠 Antes de rodar, tente prever cada linha (use o desenho dos cortes!)
print(a[-3:])
print(a[1:-1])
print(a[::-2])
print(a[2:2])[30 40 50]
[10 20 30 40]
[50 30 10]
[]A novidade: uma fatia por dimensão
No NumPy você fatia cada dimensão, separando por vírgula: array[linhas, colunas]. Um : sozinho significa “tudo nessa dimensão”.
print(casas[:, 0])      # todas as linhas, coluna 0 -> as áreas
print(casas[0, :])      # linha 0, todas as colunas -> a primeira casa
print(casas[:2, :])     # as 2 primeiras casas
print(casas[::-1, :])   # as casas em ordem inversa

X = casas[:, :2]        # as entradas do modelo (área e quartos)
y = casas[:, 2]         # o que queremos prever (preço)
print(X)
print(y)
[ 50 80 120 65]
[ 50 1 200]
[[ 50 1 200]
[ 80 2 350]]
[[ 65 2 280]
[120 3 500]
[ 80 2 350]
[ 50 1 200]]
[[ 50 1]
[ 80 2]
[120 3]
[ 65 2]]
[200 350 500 280]Essas duas últimas linhas, separando X (as features) de y (o alvo), vão aparecer em praticamente todo notebook de ML daqui pra frente.
7. Agregando por eixo (axis)
Num array 2D, sum() soma tudo. Para somar por coluna ou por linha, passe o axis. Isso confunde todo mundo, mas uma regra resolve: o eixo que você passa é o que desaparece.
Veja um boletim com 3 alunos (linhas) e 4 provas (colunas). O shape é (3, 4): o eixo 0 são os alunos e o eixo 1 são as provas.
boletim.mean(axis=0)“esmaga” os alunos. Sobram 4 valores: a média de cada prova.boletim.mean(axis=1)“esmaga” as provas. Sobram 3 valores: a média de cada aluno.
boletim = np.array([
    [7, 8,  9,  6],    # aluno 0
    [5, 6, 10,  7],    # aluno 1
    [9, 9,  8, 10],    # aluno 2
])

print(boletim.mean(axis=0))         # média de cada PROVA
print(boletim.mean(axis=0).shape)   # (4,) -> o eixo 0 (alunos) sumiu

print(boletim.mean(axis=1))         # média de cada ALUNO
print(boletim.mean(axis=1).shape)   # (3,) -> o eixo 1 (provas) sumiu

print(casas.mean(axis=0))           # na tabela de casas: a média de cada coluna (área, quartos, preço)
[7. 7.66666667 9. 7.66666667]
(4,)
[7.5 7. 9. ]
(3,)
[ 78.75 2. 332.5 ]8. Filtrando com máscaras
Uma comparação gera um array de True/False, chamado de máscara. Usar a máscara como índice devolve só os elementos True. É o Where do LINQ.
precos = casas[:, 2]

print(precos > 300)               # a máscara
print(precos[precos > 300])       # LINQ: precos.Where(p => p > 300)
print(casas[casas[:, 1] >= 2])    # casas com 2 quartos ou mais (as linhas inteiras)

# True vale 1 e False vale 0, então dá pra contar:
print((precos > 300).sum())       # quantas casas passam de 300
print((precos > 300).mean())      # a proporção delas

# np.where é o ternário aplicado a cada elemento: condição ? a : b
print(np.where(precos > 300, "caro", "ok"))
[False True True False]
[350 500]
[[ 80 2 350]
[120 3 500]
[ 65 2 280]]
2
0.5
['ok' 'caro' 'caro' 'ok']9. Broadcasting: operações entre formatos diferentes
Por que a * 2 funciona, se 2 não é um array? Porque o NumPy “estica” o 2 até o formato de a. Isso se chama broadcasting, e também funciona entre arrays:
print(precos * 1000)          # o escalar é "esticado" pra todos os elementos

ajuste = np.array([1, 0, 10])   # +1 na área, +0 nos quartos, +10 no preço
print(casas + ajuste)           # (4, 3) + (3,) -> o ajuste é somado em CADA linha
[200000 350000 500000 280000]
[[ 51 1 210]
[ 81 2 360]
[121 3 510]
[ 66 2 290]]A regra: compare os formatos da direita para a esquerda. Duas dimensões são compatíveis se forem iguais ou se uma delas for 1 (ou não existir). A dimensão de tamanho 1 é repetida até caber.
casas:   (4, 3)
ajuste:     (3,)   -> vira (1, 3) -> repetido até (4, 3)   ✅
a: (3,)
b: (4,) -> 3 ≠ 4 e nenhum dos dois é 1 ❌ errotry:
np.array([1, 2, 3]) + np.array([1, 2, 3, 4])
except ValueError as erro:
print("Erro:", erro)
# um exemplo bonito: coluna (10, 1) × linha (10,) -> tabela (10, 10)
coluna = np.arange(1, 11).reshape(-1, 1)
linha = np.arange(1, 11)
print(coluna * linha) # a tabuada inteira, sem nenhum laçoErro: operands could not be broadcast together with shapes (3,) (4,)
[[ 1 2 3 4 5 6 7 8 9 10]
[ 2 4 6 8 10 12 14 16 18 20]
[ 3 6 9 12 15 18 21 24 27 30]
[ 4 8 12 16 20 24 28 32 36 40]
[ 5 10 15 20 25 30 35 40 45 50]
[ 6 12 18 24 30 36 42 48 54 60]
[ 7 14 21 28 35 42 49 56 63 70]
[ 8 16 24 32 40 48 56 64 72 80]
[ 9 18 27 36 45 54 63 72 81 90]
[ 10 20 30 40 50 60 70 80 90 100]]Uso real em ML: padronizar as colunas. Cada coluna tem uma escala: área na casa das dezenas, preço na das centenas. Pra deixar todas comparáveis, subtraímos a média de cada coluna e dividimos pelo desvio padrão dela. Com broadcasting, isso é uma linha só:
padronizado = (casas - casas.mean(axis=0)) / casas.std(axis=0)   # (4, 3) com (3,)

print(padronizado.round(2))
print(padronizado.mean(axis=0).round(2))   # agora toda coluna tem média 0 ("-0." é só o zero com sinal, coisa de float)
print(padronizado.std(axis=0).round(2))    # ... e desvio padrão 1
[[-1.1 -1.41 -1.2 ]
[ 0.05 0. 0.16]
[ 1.58 1.41 1.52]
[-0.53 0. -0.48]]
[ 0. 0. -0.]
[1. 1. 1.]10. Cuidado: fatia de NumPy não é cópia
Numa lista, lista[1:4] cria uma lista nova. No NumPy, a fatia é uma view: uma janela para a mesma memória. Pra quem vem de C#, é um Span<T>, e não um array novo. No JS, é a diferença entre subarray() e slice() de um Float64Array.
a = np.arange(6)
janela = a[1:4]        # view: não copia nada
janela[0] = 999
print(a)               # o original mudou!

b = np.arange(6)
copia = b[1:4].copy()  # cópia de verdade
copia[0] = 999
print(b)               # agora não mudou
[ 0 999 2 3 4 5]
[0 1 2 3 4 5]O motivo é desempenho: recortar um pedaço de uma imagem 4K não copia megabytes. Quando você precisa de uma cópia independente, use .copy().
11. Do zero × NumPy: revisitando a aula passada
Lembra do erro quadrático médio e da normalização da aula 00.01? Com NumPy, cada um vira uma linha, sem laço:
reais = np.array([3, 5, 7])
previstos = np.array([2, 5, 9])

# aula 00.01:  media([(r - p) ** 2 for r, p in zip(reais, previstos)])
print(np.mean((reais - previstos) ** 2))

valores = np.array([10, 20, 30])
# aula 00.01:  [(v - menor) / (maior - menor) for v in valores]
print((valores - valores.min()) / (valores.max() - valores.min()))
1.6666666666666667
[0. 0.5 1. ]Repare como o código ficou parecido com a fórmula:
Em ML você lê a fórmula num artigo e escreve quase igual em NumPy.
12. Bônus: uma imagem é só um array
O scikit-learn vem com duas fotos de exemplo, e uma delas é a de uma torre na China. O OpenCV a carrega como um array NumPy, e tudo que você viu até aqui funciona nela.
Foto: china.jpg, de danielbuechele, licença CC BY 2.0, distribuída com o scikit-learn.
from pathlib import Path
import cv2
import matplotlib.pyplot as plt
import sklearn.datasets

# __file__ é onde o módulo está instalado; as fotos de exemplo ficam na pasta images, ao lado dele
CAMINHO_FOTO = Path(sklearn.datasets.__file__).parent / "images" / "china.jpg"
foto = cv2.imread(str(CAMINHO_FOTO))
assert foto is not None, f"não achei a imagem em {CAMINHO_FOTO}"

print(type(foto))
print(foto.shape)    # (altura, largura, canais de cor)
print(foto.dtype)    # uint8: inteiros de 0 a 255
print(foto[0, 0])    # o pixel do canto superior esquerdo: [azul, verde, vermelho]
<class 'numpy.ndarray'>
(427, 640, 3)
uint8
[231 201 174]Três eixos: linhas (altura), colunas (largura) e canais (cor). O OpenCV guarda as cores na ordem BGR, e quase todo o resto (o matplotlib, por exemplo) espera RGB. Adivinha como converte? Invertendo o último eixo com ::-1.
rgb = foto[:, :, ::-1]                      # BGR -> RGB: inverte o eixo das cores
espelhado = rgb[:, ::-1]                    # inverte as colunas -> espelho
recorte = rgb[20:380, 60:360]               # uma fatia de linhas e colunas -> recorte
escuro = (rgb * 0.4).astype(np.uint8)       # broadcasting: multiplica todos os pixels

imagens = [foto, rgb, espelhado, recorte, escuro]
titulos = ["sem converter (BGR)", "[:, :, ::-1]", "[:, ::-1]", "[20:380, 60:360]", "* 0.4"]

# o matplotlib é o tema da próxima aula; por enquanto, só aproveite o resultado
fig, eixos = plt.subplots(1, 5, figsize=(16, 4))
for eixo, img, titulo in zip(eixos, imagens, titulos):
    eixo.imshow(img)
    eixo.set_title(titulo)
    eixo.axis("off")
plt.show()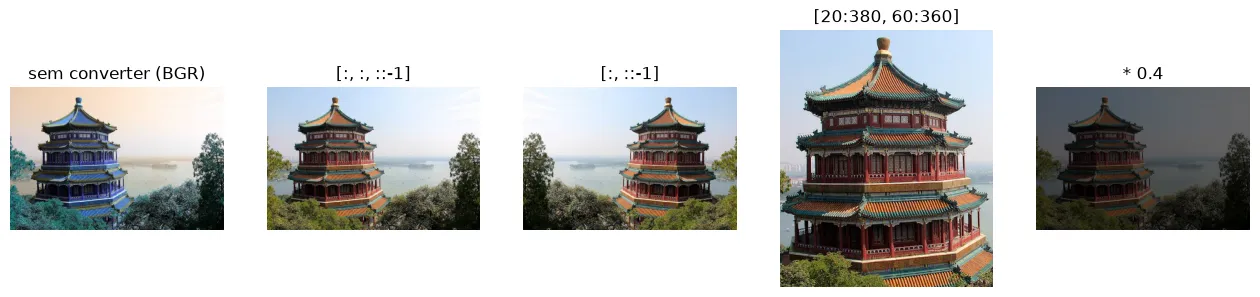
Exercícios
Regra do jogo: nenhum laço for. Use só operações de NumPy.
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Acurácia
Um classificador previu as classes de alguns exemplos. A acurácia é a fração de acertos. Por exemplo, 3 acertos em 4 dá 0.75. É a primeira métrica que você vai usar na disciplina de Fundamentos de ML.
def acuracia(reais, previstos):
    ...  # seu código aqui


confere(acuracia(np.array([1, 0, 1, 1]), np.array([1, 1, 1, 0])), 0.5)
confere(acuracia(np.array([2, 2, 3]), np.array([2, 2, 3])), 1.0)
Dica
reais == previstos gera uma máscara de acertos. E qual é a média de uma máscara? (seção 8)
Gabarito
def acuracia(reais, previstos):
    return np.mean(reais == previstos)
Exercício 2 · Normalizar cada coluna
Na aula 00.01 você normalizou uma lista para o intervalo [0, 1]. Agora faça isso com cada coluna de uma tabela: o menor valor de cada coluna vira 0 e o maior vira 1.
def normalizar_colunas(tabela):
    ...  # seu código aqui


confere(normalizar_colunas(np.array([[1, 100], [2, 200], [3, 300]])),
        [[0, 0], [0.5, 0.5], [1, 1]])
confere(normalizar_colunas(np.array([[0, 10], [10, 10], [5, 30]])),
        [[0, 0], [1, 0], [0.5, 1]])
Dica
tabela.min(axis=0) devolve o mínimo de cada coluna, com formato (colunas,). O broadcasting faz o resto (seções 7 e 9).
Gabarito
def normalizar_colunas(tabela):
    menor = tabela.min(axis=0)
    maior = tabela.max(axis=0)
    return (tabela - menor) / (maior - menor)
Exercício 3 · Vizinho mais próximo, versão vetorizada
Na aula 00.01 você achou o ponto mais próximo com min e lambda. Agora os pontos estão num array (n, 2), uma linha por ponto:
distancias(ponto, pontos)devolve a distância dopontoaté cada um dos pontos, sem laço;mais_proximo(ponto, pontos)usa a função anterior para devolver o ponto mais perto.
def distancias(ponto, pontos):
    ...  # seu código aqui


def mais_proximo(ponto, pontos):
    ...  # seu código aqui


pontos = np.array([[5, 5], [1, 2], [-3, 0]])
confere(distancias(np.array([0, 0]), pontos), [np.sqrt(50), np.sqrt(5), 3])
confere(mais_proximo(np.array([0, 0]), pontos), [1, 2])
Dica
pontos - ponto é (n, 2) menos (2,): broadcasting! Eleve ao quadrado, some cada linha (qual axis?) e tire a raiz. Para o segundo item, existe argmin, o irmão do argmax.
Gabarito
def distancias(ponto, pontos):
    return np.sqrt(((pontos - ponto) ** 2).sum(axis=1))

def mais_proximo(ponto, pontos):
    return pontos[distancias(ponto, pontos).argmin()]
Existe pronto: np.linalg.norm(pontos - ponto, axis=1).
Exercício 4 · Limiarização de imagem
Transforme uma imagem em tons de cinza em preto e branco puro: o pixel vira 255 (branco) se for maior que o limite, e 0 (preto) caso contrário. Devolva o resultado com dtype np.uint8, o tipo de imagem.
É uma das operações mais básicas de visão computacional, e vai voltar na disciplina 03.
def limiarizar(imagem, limite):
    ...  # seu código aqui


confere(limiarizar(np.array([[10, 200], [130, 90]]), 128), [[0, 255], [255, 0]])
# Depois de acertar, rode esta célula para ver sua função aplicada na foto
cinza = cv2.cvtColor(foto, cv2.COLOR_BGR2GRAY) # 3 canais -> 1 canal (tons de cinza)
preto_e_branco = limiarizar(cinza, 128)
if preto_e_branco is not None:
plt.figure(figsize=(4, 5))
plt.imshow(preto_e_branco, cmap="gray")
plt.axis("off")
plt.show()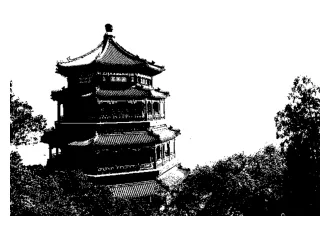
Dica
É um ternário por elemento (seção 8). Para trocar o tipo, use .astype(np.uint8).
Gabarito
def limiarizar(imagem, limite):
    return np.where(imagem > limite, 255, 0).astype(np.uint8)
Exercício 5 (desafio) · One-hot encoding
Modelos só entendem números, mas “gato” não é maior nem menor que “cachorro”. Por isso, categorias viram vetores com um único 1, na posição da categoria. Com 3 classes (0 = gato, 1 = cachorro, 2 = pássaro):
rótulo 0 -> [1, 0, 0]
rótulo 2 -> [0, 0, 1]
rótulo 1 -> [0, 1, 0]
Escreva one_hot(rotulos, n_classes), que recebe um array de rótulos e devolve a tabela (len(rotulos), n_classes), sem laço.
def one_hot(rotulos, n_classes):
    ...  # seu código aqui


confere(one_hot(np.array([0, 2, 1]), 3), [[1, 0, 0], [0, 0, 1], [0, 1, 0]])
confere(one_hot(np.array([1, 1]), 2), [[0, 1], [0, 1]])
Dica
Lembra da tabuada da seção 9? Transforme os rótulos numa coluna (n, 1) e compare com np.arange(n_classes), que é uma linha. O broadcasting monta a tabela de True/False, e .astype(int) converte.
Gabarito
def one_hot(rotulos, n_classes):
    return (rotulos.reshape(-1, 1) == np.arange(n_classes)).astype(int)
Resumo
| Quero… | NumPy |
|---|---|
| criar | np.array(lista), np.zeros(n), np.arange(i, f, passo), np.linspace(i, f, n) |
| ver o formato | a.shape, a.dtype, a.ndim |
| mudar o formato | a.reshape(linhas, -1) |
| operar elemento a elemento | a + b, a * 2, a ** 2, np.sqrt(a), a > 0 |
| agregar | a.sum(), a.mean(axis=0), a.argmax() (o eixo passado desaparece) |
| fatiar 2D | m[linhas, colunas], m[:, 0], m[::-1, :] |
| filtrar | a[a > 0], np.where(cond, x, y) |
| combinar formatos | broadcasting: da direita pra esquerda, as dimensões têm que ser iguais ou 1 |
| copiar | a.copy() (a fatia é uma view!) |