Aula 4 de 6
Álgebra linear: vetores, produto escalar e matrizes
Objetivo: relembrar vetores e matrizes pelo lado prático: o que cada operação calcula, como fica em NumPy e onde aparece em ML.
Por que isso importa: álgebra linear é o idioma do ML.
- Um dado é um vetor.
- Uma tabela de dados é uma matriz.
- Um neurônio calcula um produto escalar.
- Uma camada inteira de rede neural é uma multiplicação de matrizes.
A GPU existe, basicamente, pra fazer essa última conta muito rápido.
import numpy as np
import matplotlib.pyplot as plt

AZUL, LARANJA, VERDE = "#2a78d6", "#eb6834", "#1baf7a"


# Duas ferramentas pra desenhar vetores. A única novidade é o ax.annotate,
# que desenha uma flecha de um ponto (xytext) até outro (xy).

def preparar_plano(ax, limite=5):
    # deixa o ax com cara de plano cartesiano: eixos no zero, grade e mesma escala em x e y
    ax.axhline(0, color="gray", linewidth=0.8)
    ax.axvline(0, color="gray", linewidth=0.8)
    ax.set_xlim(-limite, limite)
    ax.set_ylim(-limite, limite)
    ax.set_aspect("equal")
    ax.grid(alpha=0.3)


def seta(ax, vetor, cor, nome, origem=(0, 0), rotulo=(0.15, 0.15), no_meio=False):
    # desenha o vetor como uma flecha saindo de "origem", com o nome perto da ponta
    # (rotulo = deslocamento do nome em relação à ponta, ou ao meio da flecha se no_meio=True)
    origem = np.asarray(origem, dtype=float)
    vetor = np.asarray(vetor, dtype=float)
    ponta = origem + vetor
    ax.annotate("", xy=ponta, xytext=origem,
                arrowprops={"arrowstyle": "-|>", "color": cor, "lw": 2, "mutation_scale": 15})
    ancora = origem + vetor / 2 if no_meio else ponta
    ax.text(ancora[0] + rotulo[0], ancora[1] + rotulo[1], nome, color="#222222", fontsize=11)
1. Vetor: uma lista de números (e uma flecha)
O problema: como descrever uma casa pra um modelo? Com uma lista de números, um por característica. Por exemplo, [80, 2, 10] pode ser área, quartos e idade. Isso é um vetor: em C#, um double[]; em NumPy, um array 1D.
Um vetor tem duas leituras, e ML usa as duas:
- Lista de números: é como os dados ficam guardados.
- Flecha: com 2 números dá pra desenhar.
[3, 2]é uma flecha que sai da origem e vai até o ponto (3, 2). Essa leitura dá a intuição de direção, tamanho e semelhança.
Com 3 números, a flecha vive no espaço 3D. Com 100 números, vive num espaço de 100 dimensões, que ninguém consegue desenhar, mas as contas continuam exatamente as mesmas. Por isso a gente aprende em 2D.
casa = np.array([80, 2, 10])     # área, quartos, idade: um vetor de 3 dimensões
print(casa, casa.shape)

v = np.array([3, 2])             # um vetor de 2 dimensões, que dá pra desenhar

fig, ax = plt.subplots(figsize=(4, 4))
preparar_plano(ax)
seta(ax, v, AZUL, "v = [3, 2]")
plt.show()
[80 2 10] (3,)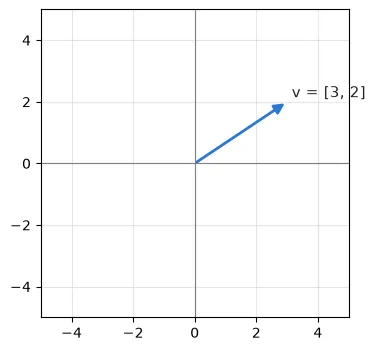
2. Soma e multiplicação por um número
Somar vetores é somar posição por posição, exatamente a operação elemento a elemento da aula 00.02: [3, 1] + [1, 2] = [4, 3].
Na leitura de flecha: ponha a cauda de b na ponta de a, e a + b vai da origem até onde você chegou. É como somar deslocamentos: andar 3 pra direita e 1 pra cima, depois mais 1 pra direita e 2 pra cima.
a = np.array([3, 1])
b = np.array([1, 2])
print(a + b)

fig, ax = plt.subplots(figsize=(4, 4))
preparar_plano(ax)
seta(ax, a, AZUL, "a", rotulo=(0.1, -0.5))
seta(ax, b, LARANJA, "b", origem=a, rotulo=(0.25, -0.1), no_meio=True)    # b começando na ponta de a
seta(ax, a + b, VERDE, "a + b", rotulo=(-1.4, 0.2))
plt.show()
[4 3]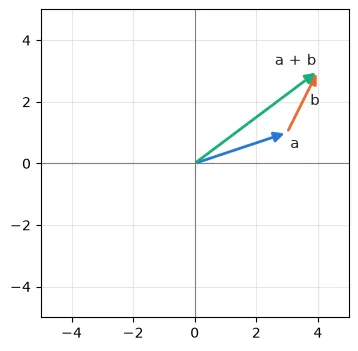
Multiplicar por um número (um escalar) multiplica cada posição: 2 * [3, 1] = [6, 2]. A flecha estica (×2), encolhe (×0.5) ou inverte o sentido (×−1), mas continua sobre a mesma reta. Daí vem o nome “escalar”: ele muda a escala do vetor.
fig, ax = plt.subplots(figsize=(4, 4))
preparar_plano(ax)
seta(ax, 1.5 * a, LARANJA, "1.5 a", rotulo=(-0.6, 0.35))
seta(ax, a, AZUL, "a", rotulo=(-0.1, -0.6))
seta(ax, -1 * a, VERDE, "-a", rotulo=(-0.3, 0.3))
plt.show()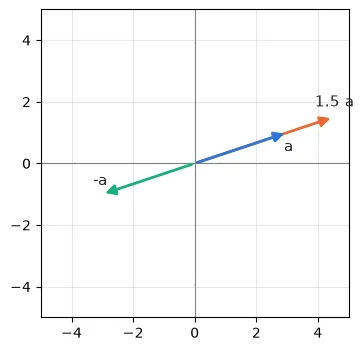
3. Tamanho (norma) e distância
O problema: qual o tamanho de um vetor? Na leitura de flecha, é o comprimento, e o comprimento vem do bom e velho Pitágoras. [3, 4] é a hipotenusa de um triângulo retângulo de catetos 3 e 4, então mede .
Com mais dimensões, a conta é a mesma: a raiz da soma dos quadrados. Esse tamanho se chama norma e se escreve :
v = np.array([3, 4])
print(np.sqrt(np.sum(v ** 2)))    # a fórmula, escrita à mão
print(np.linalg.norm(v))          # a função pronta (linalg = linear algebra)

print(np.linalg.norm(np.array([1, 2, 2])))   # em 3D: √(1 + 4 + 4) = 3
5.0
5.0
3.0Distância entre dois pontos é a norma da diferença, . O vetor a - b é a flecha que vai de b até a, e o tamanho dela é a distância. Você já fez essa conta no vizinho mais próximo das aulas 00.01 e 00.02, e ela é a base do k-NN e do k-means.
Vetor unitário: dividir um vetor pela própria norma deixa ele com tamanho 1 sem mudar a direção. Serve quando só a direção importa, como na próxima seção.
a = np.array([4, 3])
b = np.array([1, -1])
print(np.linalg.norm(a - b))       # distância entre os pontos a e b: a - b = [3, 4], então 5

unitario = a / np.linalg.norm(a)
print(unitario, np.linalg.norm(unitario))   # mesma direção, tamanho 1
5.0
[0.8 0.6] 1.04. Produto escalar: a conta mais importante do ML
O problema: um modelo simples de preço de casa diz que cada m² vale 3 mil, cada quarto vale 20 mil e cada ano de idade tira 1 mil. Pra casa [80, 2, 10]:
É só multiplicar posição por posição e somar tudo. Em C#:
double preco = 0;
for (int i = 0; i < casa.Length; i++)
    preco += pesos[i] * casa[i];
Essa conta tem nome: produto escalar (dot product), escrito :
Em NumPy, é o operador @:
pesos = np.array([3, 20, -1])
casa = np.array([80, 2, 10])

print(np.sum(pesos * casa))   # do jeito da aula 00.02: multiplica elemento a elemento e soma
print(pesos @ casa)           # produto escalar com o operador @
print(np.dot(pesos, casa))    # a mesma coisa, como função
270
270
270Por que @? No NumPy, o * já é a multiplicação elemento a elemento (aula 00.02). Por isso o Python ganhou, na versão 3.5, um operador só pra multiplicação de vetores e matrizes: o @. Não existe equivalente no C#.
Isso é um neurônio. Um neurônio artificial recebe um vetor de entradas , tem um vetor de pesos e calcula . Depois vem uma função de ativação, como a ReLU da aula 00.03. Treinar é achar bons valores para os pesos. A regressão linear da disciplina 01 é exatamente esse modelo de preço.
O que o produto escalar mede
Existe uma segunda fórmula que dá o mesmo número:
onde é o ângulo entre as flechas. Não precisa decorar. O que importa é o sinal, que vem do cosseno:
| Ângulo | Leitura | ||
|---|---|---|---|
| menor que 90° | positivo | positivo | as flechas apontam pro mesmo lado |
| 90° | 0 | zero | são perpendiculares: “não têm nada a ver” |
| maior que 90° | negativo | negativo | apontam pra lados opostos |
a = np.array([3, 0])

fig, axs = plt.subplots(1, 3, figsize=(12, 4))
for ax, graus in zip(axs, [30, 90, 150]):
    angulo = np.radians(graus)                                # cos e sin do NumPy trabalham em radianos
    b = 2.5 * np.array([np.cos(angulo), np.sin(angulo)])     # vetor de tamanho 2.5 no ângulo pedido
    preparar_plano(ax, limite=4)
    seta(ax, a, AZUL, "a")
    seta(ax, b, LARANJA, "b")
    ax.set_title(f"{graus}°:  a · b = {a @ b:.1f}")
plt.show()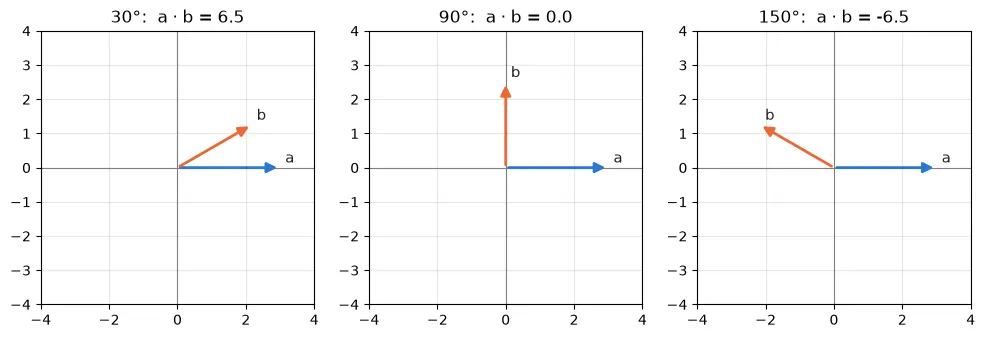
Similaridade de cosseno
Dividindo o produto escalar pelos dois tamanhos, sobra só o cosseno: um número entre −1 e 1 que diz o quanto dois vetores apontam na mesma direção, ignorando o tamanho.
É assim que se compara o “significado” de textos e imagens em ML. Cada um vira um vetor, chamado embedding (disciplina 04), e a similaridade de cosseno diz o quanto eles se parecem. Você vai implementar essa função no exercício 2.
5. Matriz × vetor: vários produtos escalares de uma vez
O problema: agora são 4 casas, e queremos o preço previsto de todas com os mesmos pesos. Com as casas numa matriz, uma por linha como na aula 00.02, é um produto escalar por linha. Em C#:
for (int i = 0; i < casas.GetLength(0); i++)       // cada casa (linha)
{
    precos[i] = 0;
    for (int j = 0; j < pesos.Length; j++)         // cada característica (coluna)
        precos[i] += casas[i, j] * pesos[j];
}
Em NumPy, casas @ pesos faz tudo isso:
# colunas: área (m²), quartos, idade (anos)
casas = np.array([
    [ 50, 1, 30],
    [ 80, 2, 10],
    [120, 3,  5],
    [ 65, 2, 20],
])
pesos = np.array([3, 20, -1])

print(casas @ pesos)                                  # um preço por casa
print(np.array([linha @ pesos for linha in casas]))   # a mesma coisa, linha por linha (só pra conferir)
[140 270 415 215]
[140 270 415 215]A regra dos formatos do @: os números “de dentro” precisam ser iguais, e o resultado fica com os “de fora”.
 casas   @   pesos   =   preços
(4, 3)       (3,)        (4,)
    └─ 3 = 3 ─┘
Cada casa tem 3 números, e o vetor de pesos também precisa ter 3, porque o produto escalar pareia posição com posição. Se os tamanhos não baterem, dá erro:
try:
    casas @ np.array([3, 20])
except ValueError as erro:
    print("Erro:", erro)

# A mensagem é comprida e enigmática, mas o final diz tudo: "size 2 is different from 3".
Erro: matmul: Input operand 1 has a mismatch in its core dimension 0, with gufunc signature (n?,k),(k,m?)->(n?,m?) (size 2 is different from 3)Cuidado: * e @ são coisas diferentes. casas * pesos também funciona, por broadcasting, mas só multiplica cada coluna pelo seu peso e não soma: o resultado é uma tabela (4, 3). O @ multiplica e soma, e devolve um número por casa.
print(casas * pesos)                   # (4, 3): cada coluna multiplicada pelo seu peso
print((casas * pesos).sum(axis=1))     # somando cada linha, chega no mesmo resultado do @
[[150 20 -30]
[240 40 -10]
[360 60 -5]
[195 40 -20]]
[140 270 415 215]6. Matriz × matriz: vários modelos de uma vez
O problema: além do preço de venda, queremos prever o aluguel, que usa outros pesos. São dois vetores de pesos, e cada um vira uma coluna de uma matriz W:
             venda   aluguel
área      [[   3,      20 ],
quartos    [  20,     150 ],
idade      [  -1,     -10 ]]
casas @ W calcula o produto escalar de cada casa (uma linha de casas) com cada modelo (uma coluna de W). O resultado tem uma linha por casa e uma coluna por modelo. Em C#, são três for aninhados:
for (int i = 0; i < n; i++)            // cada casa (linha de casas)
    for (int j = 0; j < m; j++)        // cada modelo (coluna de W)
        for (int k = 0; k < p; k++)    // produto escalar entre os dois
            R[i, j] += casas[i, k] * W[k, j];
W = np.array([
[ 3, 20],
[20, 150],
[-1, -10],
])
previsoes = casas @ W
print(previsoes) # coluna 0: venda (mil R$); coluna 1: aluguel (R$/mês)
print(previsoes.shape)[[ 140 850]
[ 270 1800]
[ 415 2800]
[ 215 1400]]
(4, 2)A regra dos formatos é a mesma:
 casas   @    W     =   previsões
(4, 3)      (3, 2)       (4, 2)
    └ 3 = 3 ┘
 os "de fora", 4 e 2, formam o resultado
Isso é uma camada de rede neural. Troque “casas” por “exemplos”, “características” por “entradas” e “modelos” por “neurônios”. X @ W calcula a saída de todos os neurônios da camada, para todos os exemplos, numa operação só. Uma rede neural é uma sequência dessas multiplicações, com funções de ativação entre elas. Você vai montar uma camada no exercício 4.
A ordem importa: A @ B geralmente é diferente de B @ A, e muitas vezes nem existe. W @ casas seria (3, 2) @ (4, 3), e 2 ≠ 4.
Transposta
.T troca linhas por colunas, e um (4, 3) vira (3, 4). É o jeito mais comum de fazer os formatos se encaixarem. Nas fórmulas, você vai ver a transposta escrita como .
print(casas.T)
print(casas.shape, "->", casas.T.shape)
[[ 50 80 120 65]
[ 1 2 3 2]
[ 30 10 5 20]]
(4, 3) -> (3, 4)7. Bônus: uma matriz transforma o espaço
Até aqui, matriz foi tabela de números. Existe uma terceira leitura, a mais bonita: uma matriz 2×2 é uma função que transforma os pontos do plano. Multiplique a matriz por cada ponto de um desenho, e o desenho inteiro se deforma.
Vamos guardar os pontos de uma casinha como colunas (a linha 0 tem os x e a linha 1 tem os y). Assim, M @ casinha transforma todos os pontos de uma vez: (2, 2) @ (2, n) = (2, n).
casinha = np.array([
    [0, 2, 2, 1, 0, 0],    # x de cada ponto (o último repete o primeiro pra fechar o desenho)
    [0, 0, 2, 3, 2, 0],    # y de cada ponto
])

transformacoes = {
    "esticar x, achatar y": np.array([[1.5, 0], [0, 0.5]]),
    "cisalhamento": np.array([[1, 1], [0, 1]]),
    "espelho": np.array([[-1, 0], [0, 1]]),
}

fig, axs = plt.subplots(1, 3, figsize=(12, 4.5))
for ax, (nome, M) in zip(axs, transformacoes.items()):    # items() devolve pares (chave, valor)
    nova = M @ casinha
    preparar_plano(ax, limite=4)
    ax.plot(casinha[0], casinha[1], color="gray", linestyle="--", label="original")
    ax.plot(nova[0], nova[1], color=AZUL, linewidth=2, label="transformada")
    ax.set_title(f"{nome}\n{M.tolist()}")
    ax.legend(loc="lower left")
plt.show()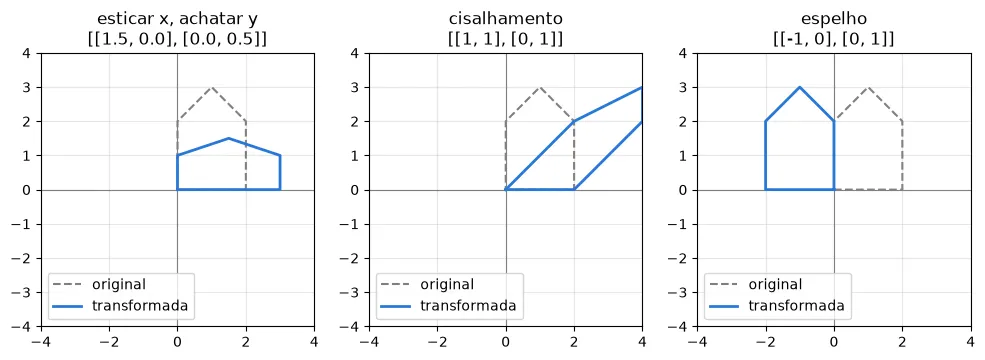
O segredo pra ler uma matriz 2×2: a primeira coluna diz para onde vai o ponto (1, 0), e a segunda coluna diz para onde vai o (0, 1). O resto do plano vai junto.
No cisalhamento, [[1, 1], [0, 1]], a primeira coluna é (1, 0), então o (1, 0) fica onde está. A segunda é (1, 1), então o (0, 1) vai para (1, 1). Por isso a casinha “tomba” pro lado.
Por que isso importa em ML: cada camada de uma rede neural transforma o espaço dos dados. Treinar a rede é achar transformações que deixem, por exemplo, as fotos de gato de um lado e as de cachorro do outro.
Pra ir além: a série Essence of linear algebra, do canal 3Blue1Brown no YouTube, mostra essas transformações animadas. É uma revisão visual excelente da matemática da faculdade.
Exercícios
Código de apoio dos exercícios
def confere(obtido, esperado):
    if obtido is None:
        print("⏳ ainda não implementado")
        return
    obtido, esperado = np.asarray(obtido), np.asarray(esperado)
    if obtido.shape != esperado.shape:
        print(f"❌ formato esperado {esperado.shape}, mas veio {obtido.shape}")
    elif np.allclose(obtido, esperado):
        print("✅ certo!")
    else:
        print(f"❌ esperado:\n{esperado}\nmas veio:\n{obtido}")
Exercício 1 · Norma à mão
Escreva norma(v) sem usar np.linalg.norm: a raiz da soma dos quadrados, pra um vetor de qualquer tamanho.
def norma(v):
    ...  # seu código aqui


confere(norma(np.array([3, 4])), 5)
confere(norma(np.array([1, 2, 2])), 3)
confere(norma(np.array([0, 0, 0, 0])), 0)
Dica
Três funções do NumPy resolvem: ** 2, np.sum e np.sqrt. Sem laço!
Gabarito
def norma(v):
    return np.sqrt(np.sum(v ** 2))
Exercício 2 · Similaridade de cosseno
Escreva similaridade_cosseno(a, b), com a fórmula da seção 4:
Antes de rodar, tente prever cada resultado: flechas perpendiculares, na mesma direção e opostas.
def similaridade_cosseno(a, b):
    ...  # seu código aqui


confere(similaridade_cosseno(np.array([1, 0]), np.array([0, 1])), 0)     # perpendiculares
confere(similaridade_cosseno(np.array([1, 1]), np.array([3, 3])), 1)     # mesma direção, tamanhos diferentes
confere(similaridade_cosseno(np.array([2, 0]), np.array([-5, 0])), -1)   # opostas
Dica
Produto escalar com @ em cima; np.linalg.norm (ou a sua norma) embaixo. Cuidado com os parênteses!
Gabarito
def similaridade_cosseno(a, b):
    return (a @ b) / (np.linalg.norm(a) * np.linalg.norm(b))
Repare no segundo teste: [1, 1] e [3, 3] têm tamanhos diferentes, mas similaridade 1. O cosseno só olha a direção.
Exercício 3 · Um recomendador de filmes
Cada filme é um vetor que diz o quanto ele tem de ação, romance e comédia, de 0 a 1. O gosto de uma pessoa é um vetor no mesmo formato. O produto escalar entre os dois mede a combinação: é alto quando o filme tem muito do que a pessoa gosta.
pontuacoes(filmes, gosto)devolve a pontuação de cada filme, sem laço.recomendar(filmes, gosto)devolve o índice do filme com a maior pontuação.
É uma versão de brinquedo de como os sistemas de recomendação funcionam: filmes e pessoas viram vetores, e o produto escalar mede a combinação.
nomes = ["Explosão Total", "Amor em Paris", "Rindo à Toa", "Policial Trapalhão", "Casamento Maluco"]

# colunas: ação, romance, comédia
filmes = np.array([
    [0.9, 0.1, 0.2],
    [0.1, 0.9, 0.3],
    [0.2, 0.2, 0.9],
    [0.8, 0.0, 0.6],
    [0.3, 0.7, 0.7],
])
gosto = np.array([1.0, 0.0, 0.5])    # adora ação, não liga pra romance, gosta um pouco de comédia


def pontuacoes(filmes, gosto):
    ...  # seu código aqui


def recomendar(filmes, gosto):
    ...  # seu código aqui


confere(pontuacoes(filmes, gosto), [1.0, 0.25, 0.65, 1.1, 0.65])
confere(recomendar(filmes, gosto), 3)

if recomendar(filmes, gosto) is not None:
    print("Recomendação:", nomes[recomendar(filmes, gosto)])
Dica
A matriz filmes tem um filme por linha, e você quer um produto escalar por linha com o gosto: é a seção 5. Para achar o índice do maior valor, use o argmax da aula 00.02.
Gabarito
def pontuacoes(filmes, gosto):
    return filmes @ gosto

def recomendar(filmes, gosto):
    return pontuacoes(filmes, gosto).argmax()
Repare que o “Policial Trapalhão” (1.1) ganhou do “Explosão Total” (1.0), mesmo tendo menos ação: a comédia que ele tem também conta pontos pra essa pessoa.
Exercício 4 · Uma camada de rede neural
Uma camada de rede neural faz três coisas:
- multiplica as entradas pelos pesos:
X @ W; - soma um vetor de ajuste
b(o bias), um valor por neurônio; - aplica a ReLU, que zera os negativos:
np.maximum(0, ...).
Escreva camada(X, W, b). Aqui, X tem 2 exemplos com 3 entradas cada, e W tem os pesos de 2 neurônios. Antes de rodar, descubra qual vai ser o formato da saída.
X = np.array([
    [1,  2, 3],
    [0, -1, 1],
])
W = np.array([
    [1, -1],
    [0,  1],
    [1,  0],
])
b = np.array([0, -1])


def camada(X, W, b):
    ...  # seu código aqui


confere(camada(X, W, b), [[4, 0], [1, 0]])
Dica
É uma linha só. X @ W tem formato (2, 2), e + b soma o vetor em cada linha, por broadcasting (aula 00.02).
Gabarito
def camada(X, W, b):
    return np.maximum(0, X @ W + b)
Fazendo à mão: X @ W = [[4, 1], [1, -1]]; somando b = [[4, 0], [1, -2]]; a ReLU zera o −2 e chega em [[4, 0], [1, 0]]. O PyTorch tem isso pronto: nn.Linear faz o X @ W + b e nn.ReLU faz o resto.
Exercício 5 (desafio) · Girando a casinha
A matriz que gira os pontos do plano por um ângulo , em volta da origem, é:
Escreva rotacionar(pontos, graus), que recebe os pontos como colunas, no formato (2, n) da seção 7, e devolve os pontos girados. Atenção: o ângulo chega em graus.
def rotacionar(pontos, graus):
    ...  # seu código aqui


confere(rotacionar(np.array([[1], [0]]), 90), [[0], [1]])                # (1, 0) girado 90° vira (0, 1)
confere(rotacionar(np.array([[1, 0], [0, 1]]), 180), [[-1, 0], [0, -1]])  # 180° inverte tudo
# Depois de acertar, rode esta célula pra ver a casinha girando
if rotacionar(casinha, 0) is not None:
fig, ax = plt.subplots(figsize=(5, 5))
preparar_plano(ax, limite=4)
for graus, cor in zip([0, 60, 120], [AZUL, LARANJA, VERDE]):
nova = rotacionar(casinha, graus)
ax.plot(nova[0], nova[1], color=cor, linewidth=2, label=f"{graus}°")
ax.set_title("Casinha girando em volta da origem")
ax.legend()
plt.show()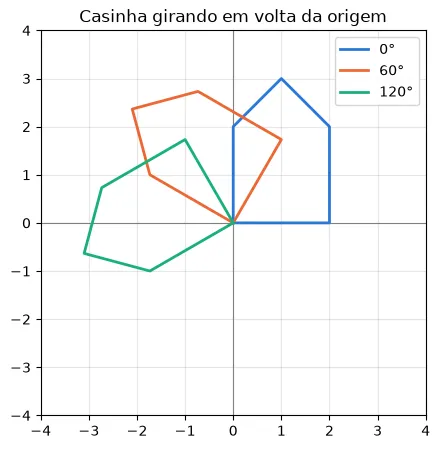
Dica
Converta com np.radians(graus), monte a matriz com np.array([[...], [...]]) e multiplique pelos pontos com @.
E por que a fórmula é essa? Lembre do segredo da seção 7: a primeira coluna diz para onde vai o (1, 0). Girar o (1, 0) por leva ele para , que é exatamente a primeira coluna.
Gabarito
def rotacionar(pontos, graus):
    t = np.radians(graus)
    R = np.array([
        [np.cos(t), -np.sin(t)],
        [np.sin(t),  np.cos(t)],
    ])
    return R @ pontos
Resumo
| Conceito | Conta | NumPy | Onde aparece em ML |
|---|---|---|---|
| vetor | lista de números / flecha | np.array([...]) |
um exemplo (uma casa, uma foto) |
| soma, escalar | posição por posição | a + b, 2 * a |
ajustar os pesos no treino |
| norma | np.linalg.norm(v) |
o tamanho de um vetor | |
| distância | np.linalg.norm(a - b) |
k-NN, k-means | |
| produto escalar | a @ b |
um neurônio, regressão linear | |
| similaridade de cosseno | (a @ b) / (norm(a) * norm(b)) |
comparar embeddings | |
| matriz × vetor | um produto escalar por linha | X @ w |
prever para todos os exemplos |
| matriz × matriz | linha × coluna | X @ W |
uma camada de rede neural |
| transposta | linhas ↔ colunas | A.T |
fazer os formatos se encaixarem |
A regra do @: (n, k) @ (k, m) → (n, m). Os de dentro precisam ser iguais, e os de fora formam o resultado.